几百 MB 的 PDF 不想下载?我们用 HTTP Range + 服务端预解析做到了在线秒开
2026年11月3日 · StreamPDF Team
前言
同事发来一份 200MB+ 的技术规范,你点开链接,浏览器底部弹出下载进度条——然后就是漫长的等待。
200MB 起步的 PDF,在普通网络下下载可能要一两分钟;下到本地还要占存储,看完还得手动清理;要是在手机上打开,流量跑了、存储满了、机身也烫了。
问题来了:看 PDF,一定要把整个文件下载下来吗?
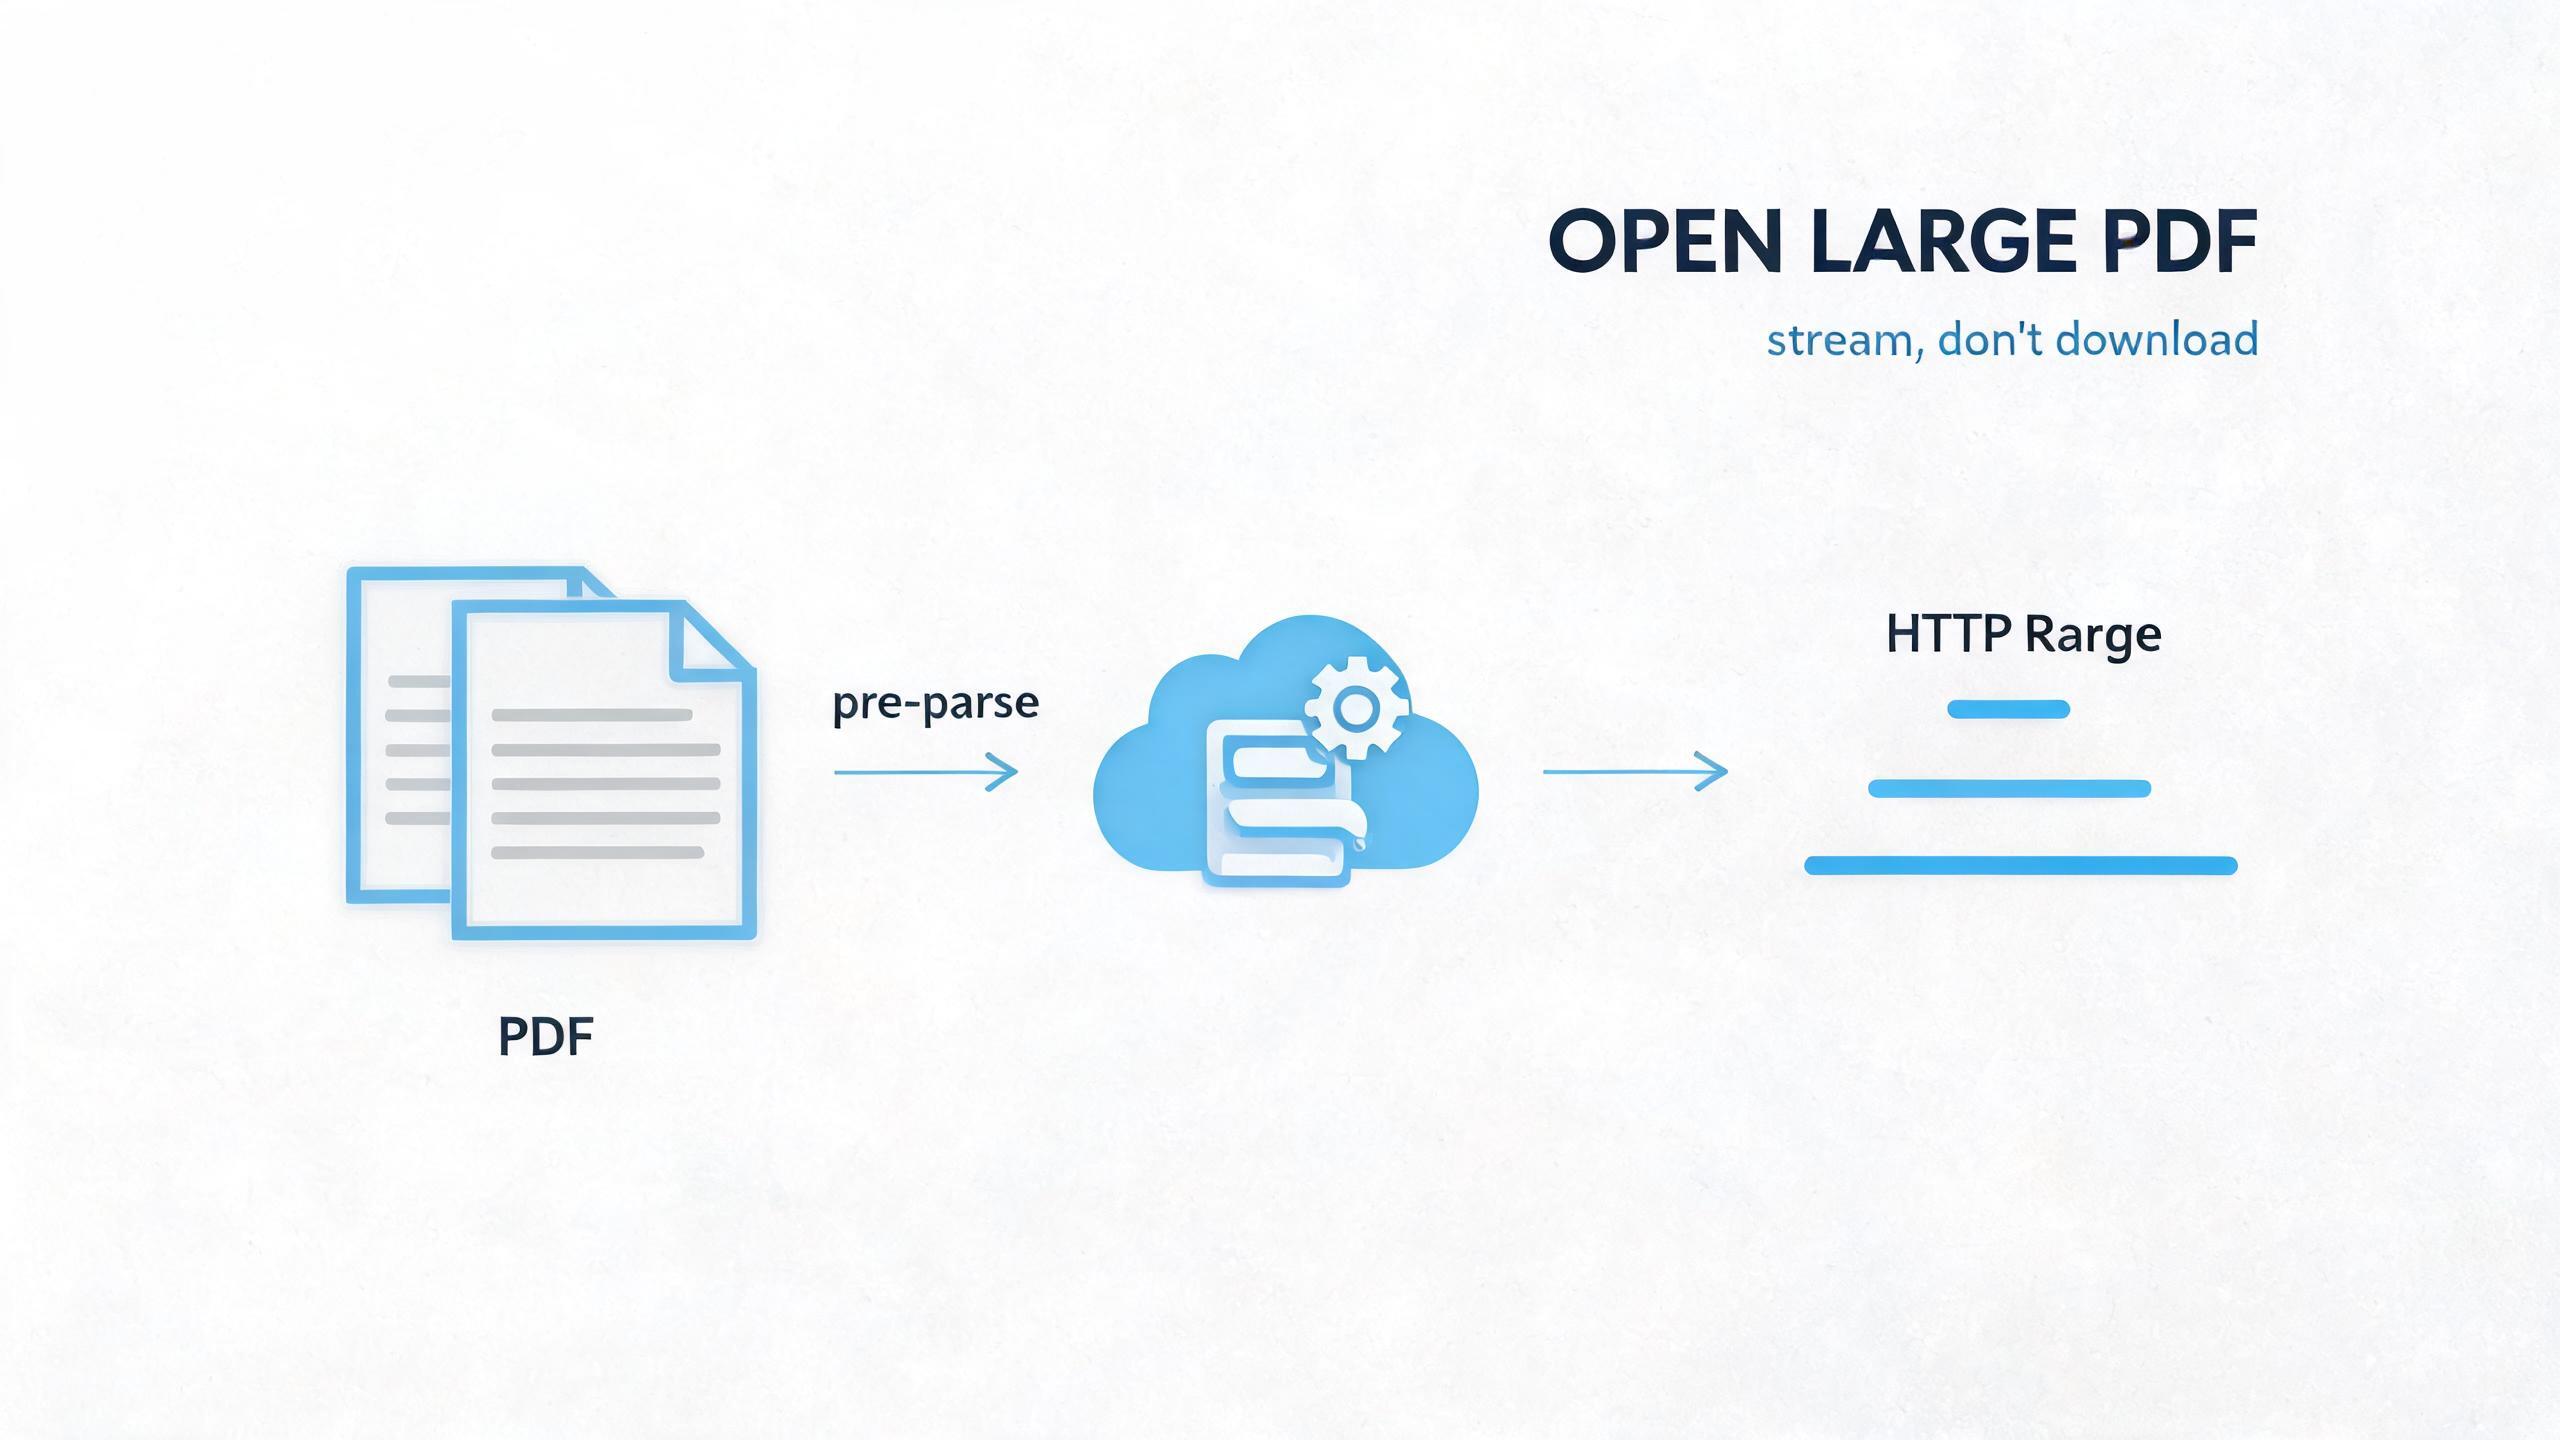
答案是不需要。要做到「在线打开大 PDF 而不下载整文件」,核心是两件事:HTTP Range 请求——只取需要的字节;以及服务端预解析文件结构——让浏览器跳过扫描、直接知道每页在哪。
本文会拆解这两件事的技术原理,以及 StreamPDF 如何把它们组合成「首屏约 1 秒、跳到第 1000 页也是即时响应」的体验。
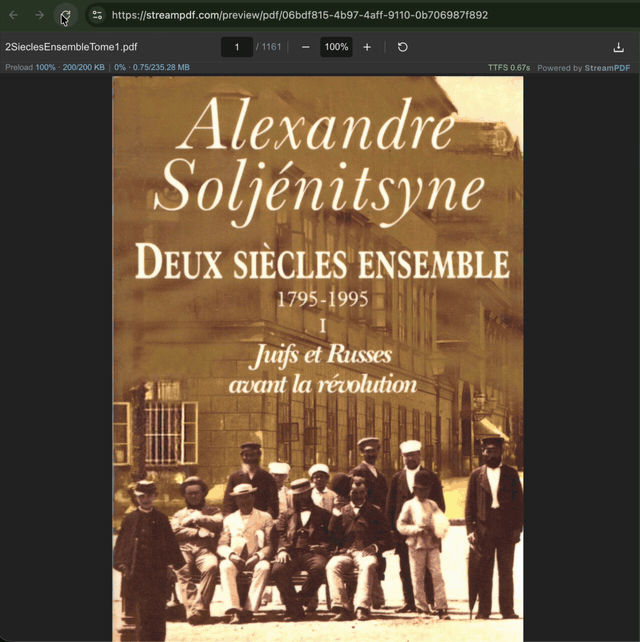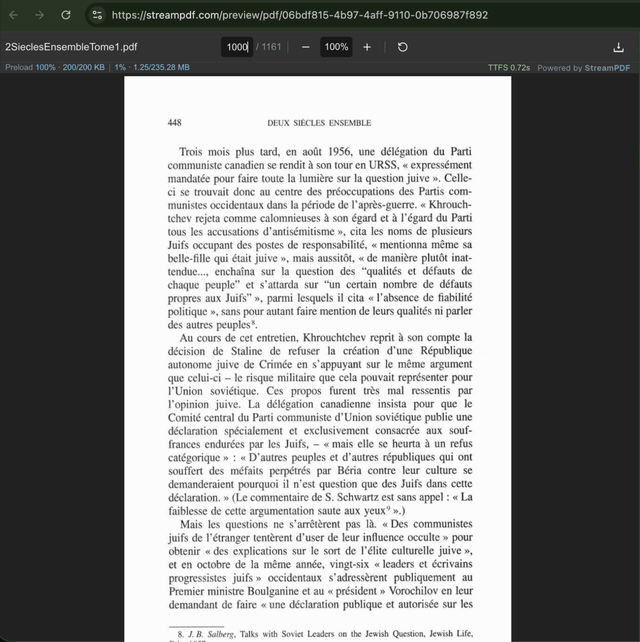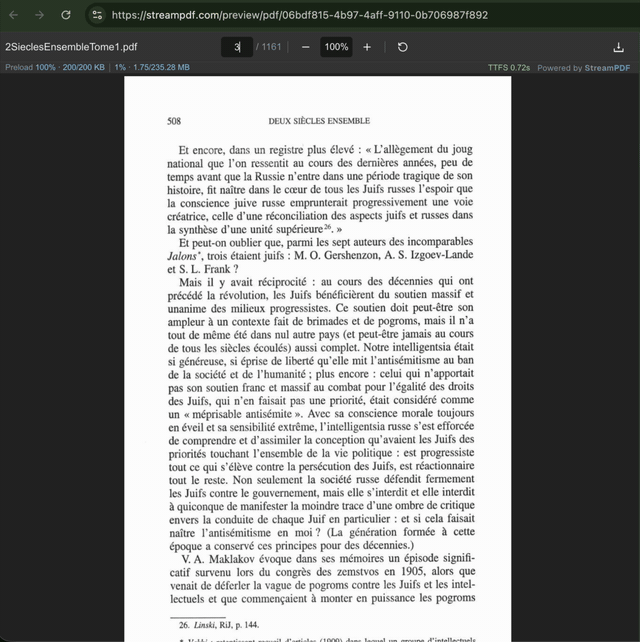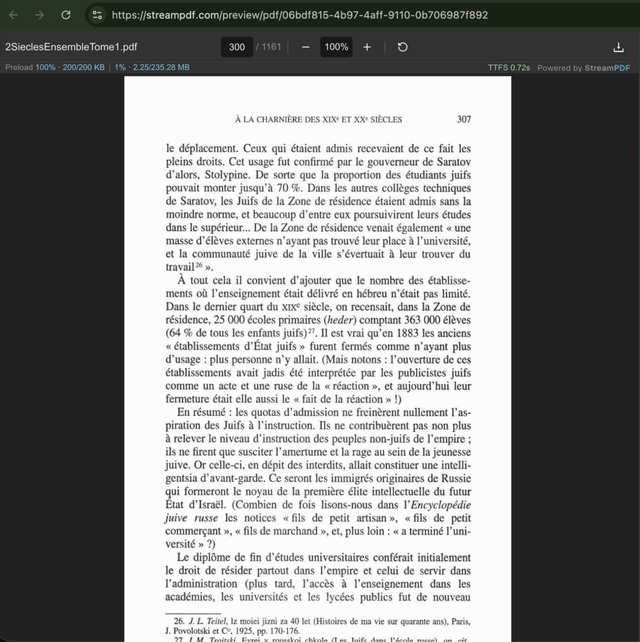
阅读器地址: https://streampdf.com/preview/pdf/06bdf815-4b97-4aff-9110-0b706987f892
一、为什么「下载整文件」是打开大 PDF 的最大障碍
传统阅读器的链路
大多数桌面 PDF 阅读器和浏览器的「在线预览」,背后走的是同一条链路:
完整下载文件 → 解析整个文件结构 → 渲染第一页
也就是说,首屏时间约等于「下载时间 + 解析时间」。文件越大,下载越久,首屏就越慢。一个 300MB 的文件,哪怕解析只要几百毫秒,光下载就能把首屏拖到分钟级。
更糟的是,下载这件事是「全有或全无」的——你只想看第 5 页,也得把第 1 到第 1000 页的字节全部拉到本地。
即使是 pdf.js,首次打开也绕不开尾部扫描
pdf.js 是目前 Web 上最主流的 PDF 渲染引擎,它本身已经支持 HTTP Range 请求,可以按需取字节。但它仍然有一个绕不开的瓶颈。
PDF 文件的结构索引——xref(交叉引用表)和页树(Pages tree)——通常位于文件的尾部。要知道「第 N 页在文件的哪个字节偏移」,解析器必须先读到尾部的 xref,再顺着页树遍历到目标页。
这里有一个容易被忽略的细节:所谓「请求尾部拿结构」,并不是一次 Range 请求就能搞定的。
PDF 的初始化是一条顺着对象引用逐层下钻的链路。pdf.js 的实际过程大致是:
- 先读文件末尾约 1KB,找到
startxref标记,它指向 xref(交叉引用表)的起始偏移 - 按这个偏移发 Range,取到 xref。xref 给出每个对象编号到字节偏移的映射,但它本身可能是普通的 xref table,也可能是压缩的 xref stream——后者需要先解压
- 从 xref 里找到 Catalog 对象的偏移,再发一次 Range 取 Catalog
- Catalog 里有 Pages 树的根节点引用,继续发 Range 取 Pages 根
- Pages 树是一棵树,不是扁平列表。要定位第一页,可能要从根节点一路遍历到叶子节点,每个中间节点都可能需要一次 Range 请求
- 最终拿到第一页的页面对象,再取它的内容流(content stream)和资源(字体、图片引用),才能开始渲染
也就是说,从 startxref 到「第一页可渲染」,中间可能隔着 5~10 次甚至更多 Range 请求,每一次都是一次网络往返。
而「结构各异」决定了这个数字极不稳定:
- 页树深度:有的 PDF 页树是两层(根 → 所有页),有的是多层平衡树,深度越大请求越多
- xref 类型:xref table 是明文,一次 Range 即可;xref stream 是压缩的,取到后还要解压,且可能包含多个分段
- 对象流(ObjStm):现代 PDF 常把多个小对象打包进一个压缩的对象流,pdf.js 需要先取到这个流并解压,才能解析出里面的对象偏移
- 跨对象引用:第一页的字体、图片资源可能分散在文件不同位置,又会触发额外的 Range 请求
更麻烦的是,这些请求很难并行——因为后一次请求的偏移,依赖前一次请求返回的解析结果。这是一条串行链路,延迟是叠加的。
再加上 Range 请求拿到的是原始字节,服务器无法对部分内容做 gzip 压缩,传输效率本身就有上限。对于大文件,一次 Range 可能就是几十 KB 到几百 KB 的原始字节。
结论很直接:单靠浏览器端的 Range,做不到真正的「秒开 + 任意页跳转」。 初始化阶段的多次串行 Range,就是首屏速度的天花板。
二、技术支柱一:HTTP Range 请求——只取需要的字节
在讲 StreamPDF 的方案之前,先把 Range 请求这件事说清楚。它是「不下载整文件」的基础能力。
Range 请求是什么
HTTP 协议允许客户端通过 Range 请求头,只获取资源的某一段字节,而不是整个文件:
GET /large.pdf HTTP/1.1
Range: bytes=0-65535
服务器如果支持,会返回 206 Partial Content,并在 Content-Range 头中标明本次返回的字节区间:
HTTP/1.1 206 Partial Content
Content-Range: bytes 0-65535/314572800
Content-Length: 65536
这给了客户端「按需取字节」的能力——我只需要文件开头的 64KB,就不用把 300MB 全拉下来。
pdf.js 的两路并行策略
pdf.js 把 Range 的能力用得很彻底。它同时维护两条数据通道:
- 渐进全量流:从文件头开始顺序下载,边下边解析。这条通道保证数据按序到达,适合从头开始的连贯阅读。
- 按需 Range:当解析器遇到当前还没下载到的字节时,会抛出
MissingDataException,然后对齐到 64KB 的 chunk 边界,发起一次 Range 请求把缺失区间补齐。
两条通道的数据最终汇入同一个 ChunkedStream,靠 _loadedChunks 这个集合记录哪些 chunk 已经到位,避免重复下载。
这部分的源码细节可以参考 PDF.js 深入浅出:网络流与 Range 请求,里面完整走了一遍 PDFFetchStream → PDFWorkerStream → NetworkPdfManager → ChunkedStreamManager 的调用链。
仍未解决的问题:结构定位
Range 解决了「怎么按需取字节」,但没解决「该取哪段字节」。
要精准发 Range,必须先知道每页对应的字节偏移。而页树和 xref 在文件尾部——首次打开必须先扫尾部,这一步本身就是一次额外的网络往返,决定了首屏不可能真正快。
换句话说,Range 是「弹药」,但你还需要一张「地图」才知道往哪打。
三、技术支柱二:StreamPDF 把文件结构前置到服务端
StreamPDF 的核心思路,就是把「绘制地图」这件事提前到服务端做完。
上传后的服务端预解析
用户把 PDF 上传到 StreamPDF 后,文件直传 R2 对象存储,字节不经过应用服务器。随后 Modal 后台会对这份 PDF 做一次预解析:
- 解析 xref,建立对象编号到字节偏移的映射
- 遍历页树,提取每一页的对象引用和字节范围
- 收集渲染所需的元数据(页面尺寸、资源引用等)
解析完成后,这些「结构产物」会写回 R2,与原 PDF 文件并存。换句话说,文件上传一次,结构就被永久「画好」了。
阅读器打开时直接拿到结构
当用户在浏览器中打开这份 PDF 时,阅读器首先获取的不是原文件,而是服务端预解析好的结构数据。
这份结构数据体积很小(通常只有几十 KB),但它直接给出了「第 N 页 → 字节偏移」的映射。阅读器拿到它之后,立即就知道第一页在哪个位置、第 1200 页在哪个位置,完全不需要扫描整个文件,也不需要请求尾部的 xref。
结构 + Range = 秒开任意页
有了地图(结构数据)和弹药(Range 请求),体验就变成了:
- 首屏:只拉取第一页所在的字节区间,大约 1 秒就能渲染出来
- 跳转:想看第 1200 页,直接按偏移发一次 Range,即时响应,不存在「越往后翻越慢」
- 滚动:可视区域外的页面按需加载,不会预先下载几百 MB
这就是 StreamPDF 能做到「大 PDF 在线秒开」的原因——把浏览器端最耗时的「结构扫描」前置到了服务端,浏览器只负责「拿结构 + 取字节 + 渲染」。
四、体验层面的工程细节
技术原理讲完了,落到体验上,还有几个细节值得说。
首屏秒开(Time to First Screen)
StreamPDF 把首屏时间作为核心指标来优化。因为结构数据极小,首屏实际只取第一页的字节区间——通常就是几百 KB 到几 MB,而不是整个文件。
对比原生阅读器「整文件下载完才能渲染」的方式,StreamPDF 的首屏时间与文件总大小基本无关,只与第一页的复杂度有关。在首页的 benchmark 区域,你可以实时看到首屏计时器(Time to First Screen),400MB+ 的 PDF 也能在约 1 秒内出第一屏。
任意页码即时跳转
因为页码到字节偏移的映射已经在服务端算好,跳转任意页都是一次常数时间的查询 + 一次 Range 请求。
很多阅读器跳转到靠后的页面会明显变慢,因为它们需要顺序解析前面的页树节点。StreamPDF 不存在这个问题——第 1 页和第 1000 页的跳转延迟几乎一致。
只下载可见页
浏览过程中,阅读器只会请求当前可视区域内的页面字节。你往下滚,它才按需加载后面的内容;你停在某一页,它不会在后台偷偷把剩下的几百 MB 下完。
这对内存和带宽都很友好,也是手机上不发烫、不跑流量的关键。
CDN 边缘加速
所有字节请求都经过 CDN(cdn-stream-pdf.streampdf.com)回源 R2。边缘节点会缓存热门页面的字节区间,重复访问同一页时几乎是零延迟。
五、延伸讨论(开放性话题)
以下话题不给出标准答案,欢迎留言交流。
服务端预解析的边界在哪里?
服务端预解析的前提是「能解析」。那么:
- 含动态表单(AcroForm / XFA)的 PDF,预解析出的静态结构是否足够支撑交互?表单字段的状态如何在「不下载整文件」的前提下同步?
- 超大页数(几万页)的 PDF,预解析产物本身会不会成为新的瓶颈?结构数据的体积和查询效率如何控制?
- 线性化(Linearized)的 PDF 本身已经针对「快速首屏」做了优化,服务端预解析对它还有多大增益?
纯客户端方案还有未来吗?
StreamPDF 走的是「服务端前置结构」的路线,但纯客户端方案并非没有意义:
- 如果未来浏览器原生支持「PDF 结构索引」(类似 EPUB 的 nav 文档),把结构信息内嵌在文件头部,那还需要服务端预解析吗?
- pdf.js 的渐进全量流 + Range 已经很强,对于「只看前几页就关」的场景,纯客户端方案是不是已经够用了?什么场景下服务端方案仍然不可替代?
「在线不下载」的隐私权衡
文件存在云端,天然带来隐私与合规问题。这引出几个值得讨论的方向:
- 有没有可能做到「结构在服务端、字节在客户端」的混合方案?即服务端只存结构索引,原文件仍留在用户本地或私有存储。
- 企业内部的大 PDF,往往不能落地到公有云。如何在「不落地」的前提下,做到服务端级别的秒开体验?
六、适用场景
说了这么多,StreamPDF 最适合谁?
- 经常收到大 PDF 的人:技术规范、法律合同、产品手册、学术论文集,不必为看几页下载整个文件
- 不想占本地存储的人:文件存在云端,随时在线打开,看完即走,不用清理
- 手机党:不跑流量、不占存储、不发烫,大 PDF 在手机上也能流畅看
- 需要分享大 PDF 的人:发一个链接,对方打开就能阅读,不用让对方下载几百 MB
七、立即体验
说了这么多,不如自己试一下:
- 打开 StreamPDF 官网
- 上传一份大 PDF,或者直接粘贴一个 PDF 链接
- 几秒处理完成后,在线秒开,随意翻页
- 首屏时间实时可见,跳到任意页都是即时响应
结尾
「不下载」的本质,其实是只拿需要的字节。
要做到这一点,需要两个支柱:HTTP Range 提供按需取字节的能力,服务端前置结构 让浏览器跳过扫描、精准定位每页。两者结合,几百 MB 的 PDF 也能像网页一样随开随看。
如果你也受够了「下载 → 等待 → 清理」的循环,现在就去 streampdf.com 试试你的那份大 PDF。
关于我:StreamPDF 创造者,专注于 AI 和 PDF 领域的研究和开发。