数百MBのPDFをダウンロードせずにオンラインで即座に開く:HTTP Range+サーバー側事前解析による高速化の実現
2026年11月3日 · StreamPDF Team
はじめに
同僚から200MBを超える技術仕様書が送られてきた。リンクを開くとブラウザ下部にダウンロードのプログレスバーが表示され——そして長い待ち時間が始まる。
200MBから始まるPDFは、通常のネットワーク環境ではダウンロードに1~2分かかることもある。ローカルにダウンロードすればストレージを消費し、読み終わった後は手動で削除しなければならない。スマートフォンで開けば、通信量は増えるわストレージは満タンになるわ本体は熱くなるわ。
問題はこれだ:PDFを見るのに、ファイル全体をダウンロードする必要があるのだろうか?
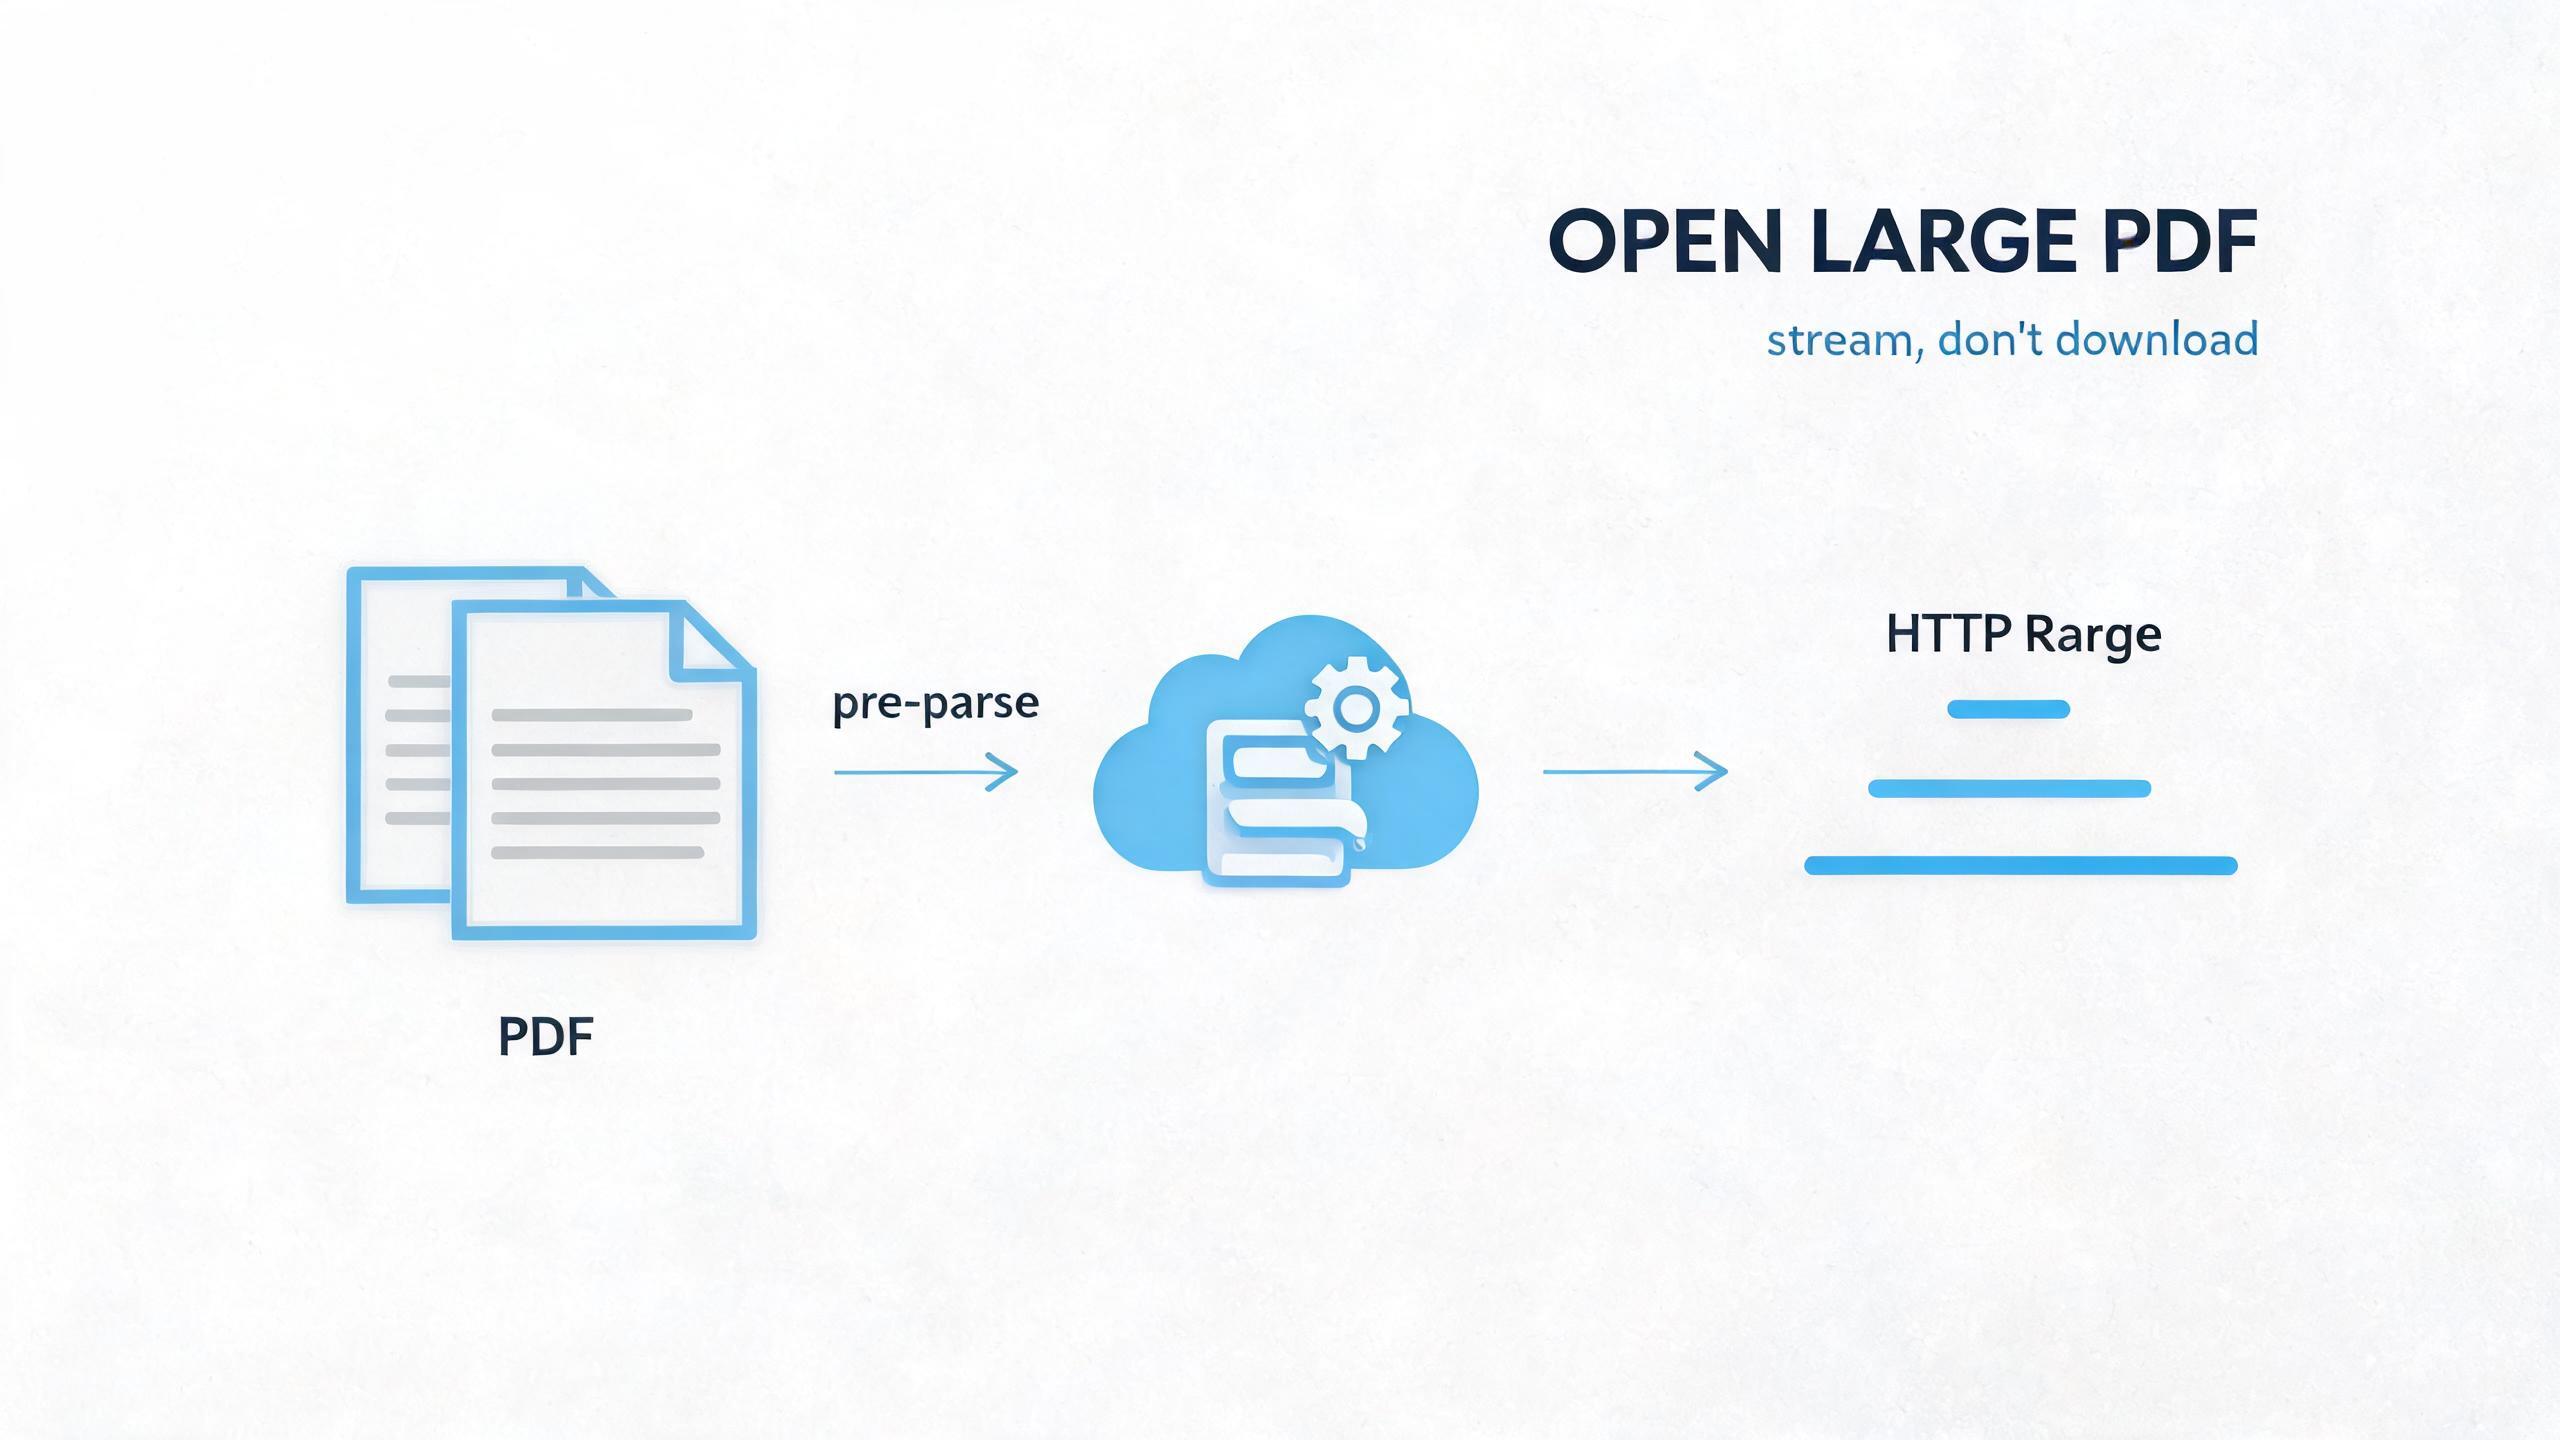
答えは「No」だ。「大きなPDFをオンラインで開き、ファイル全体をダウンロードしない」ために必要なのは、核心的に2つのことだけ:HTTP Rangeリクエスト——必要なバイトだけを取得すること、そしてサーバー側でファイル構造を事前解析すること——ブラウザがスキャンをスキップし、各ページの位置を直接知れるようにすること。
本記事ではこの2つの技術原理を解き明かし、StreamPDFがそれらをどのように組み合わせて「初回表示約1秒、1000ページ目へのジャンプも即座に応答する」体験を実現したかを紹介する。
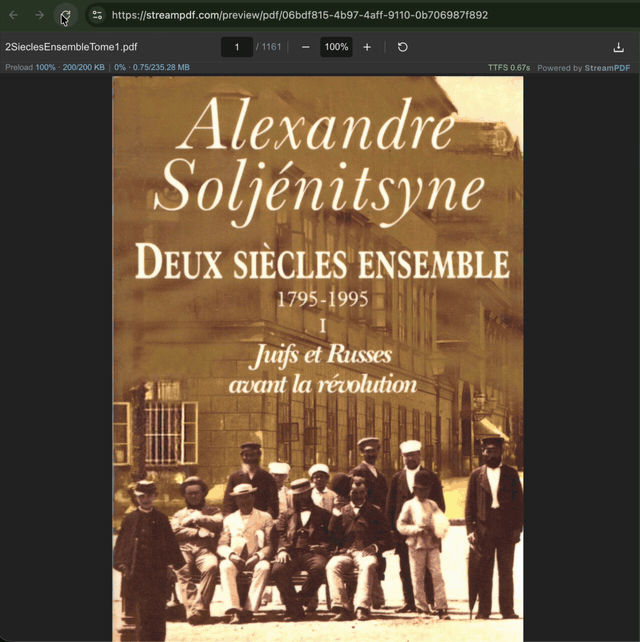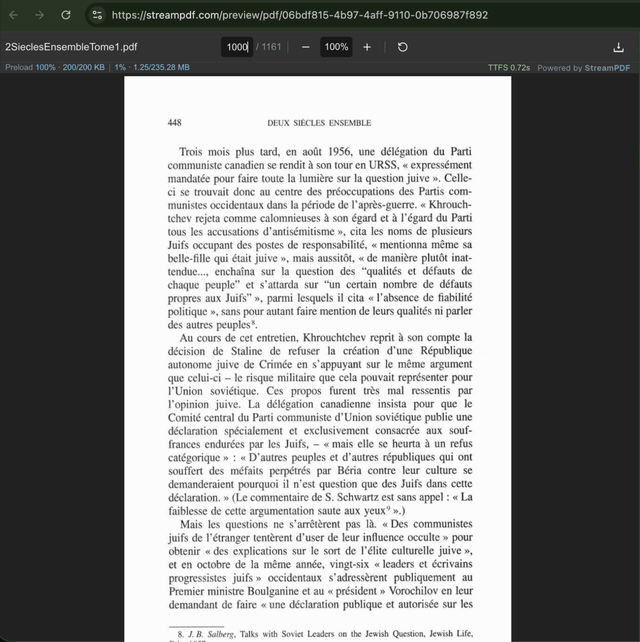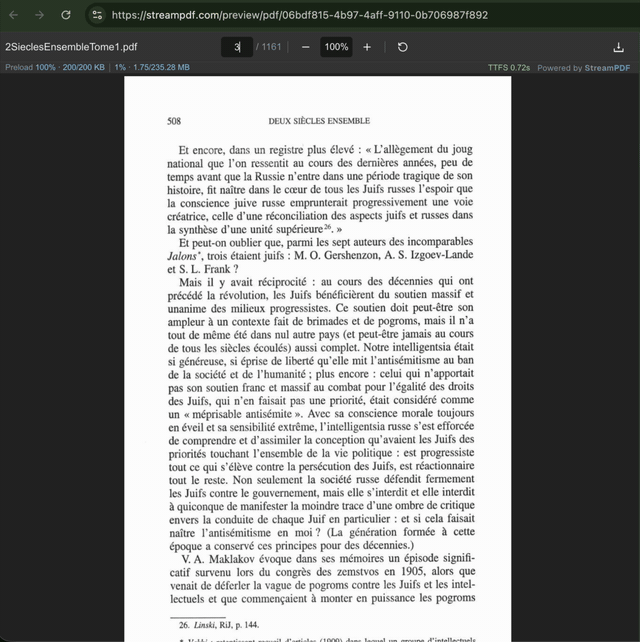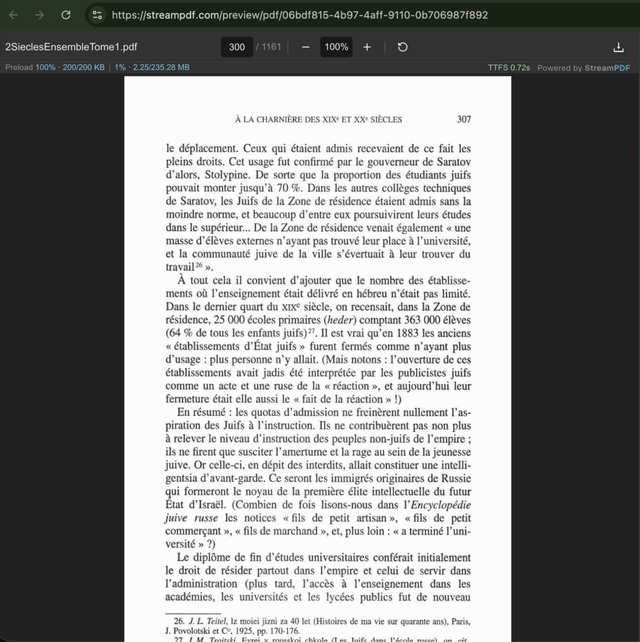
リーダーURL: https://streampdf.com/preview/pdf/06bdf815-4b97-4aff-9110-0b706987f892
1. なぜ「ファイル全体のダウンロード」が大きなPDFを開く最大の障壁となるのか
従来のリーダーの処理フロー
ほとんどのデスクトップPDFリーダーとブラウザの「オンラインプレビュー」の背後には、同じ処理フローがある:
ファイルを完全にダウンロード → ファイル構造全体を解析 → 1ページ目を描画
つまり、初回表示時間は「ダウンロード時間+解析時間」にほぼ等しい。ファイルが大きいほどダウンロードに時間がかかり、初回表示も遅くなる。300MBのファイルであれば、解析に数百ミリ秒しかかからなくても、ダウンロードだけで初回表示が数分レベルに引きずられる可能性がある。
さらに悪いことに、ダウンロードは「オール・オア・ナッシング」なものだ——5ページ目だけを見たいとしても、1ページ目から1000ページ目までのバイトをすべてローカルに取得しなければならない。
pdf.jsですら、初回オープン時には末尾スキャンを避けられない
pdf.jsは現在Web上で最も主流なPDF描画エンジンであり、HTTP Rangeリクエストをサポートして必要なバイトを取得できるようになっている。それでもなお、避けられないボトルネックが1つ存在する。
PDFファイルの構造インデックスであるxref(クロスリファレンステーブル)とPages treeは、通常ファイルの末尾に位置する。「Nページ目がファイル内のどのバイトオフセットにあるか」を知るには、パーサーはまず末尾のxrefを読み、そこからPages treeを辿って目的のページに到達しなければならない。
ここに見落とされがちな細部がある。「構造を取得するために末尾をリクエストする」といっても、Rangeリクエスト1回で済むわけではない。
PDFの初期化はオブジェクト参照を辿って段階的に掘り下げる処理フローだ。pdf.jsの実際の流れはおおよそ次の通り:
- まずファイル末尾の約1KBを読み、
startxrefマーカーを見つける。これがxref(クロスリファレンステーブル)の開始オフセットを指している - このオフセットでRangeリクエストを送り、xrefを取得する。xrefは各オブジェクト番号からバイトオフセットへのマッピングを与えるが、それ自体が通常のxref tableの場合もあれば、圧縮されたxref streamの場合もある——後者はまず解凍する必要がある
- xrefからCatalogオブジェクトのオフセットを見つけ、もう一度Rangeリクエストを送ってCatalogを取得する
- CatalogにはPages treeのルートノードへの参照があるので、さらにRangeリクエストを送ってPagesルートを取得する
- Pages treeはフラットなリストではなく木構造だ。1ページ目の位置を特定するには、ルートノードからリーフノードまで階層を辿る必要があり、各中間ノードにつきRangeリクエストが必要になる場合がある
- 最終的に1ページ目のページオブジェクトを取得し、そのcontent streamとリソース(フォント、画像参照)を取得してようやく描画を開始できる
つまり、startxrefから「1ページ目が描画可能になるまで」の間に、5~10回、あるいはそれ以上のRangeリクエストが必要になる可能性があり、そのたびにネットワーク往復が発生する。
そして「構造の多様性」がこの数を極めて不安定にする:
- Pages treeの深さ:PDFによってはPages treeが2層(ルート→全ページ)のものもあれば、多層の平衡木になっているものもあり、深いほどリクエスト数が増える
- xrefの種類:xref tableは平文なのでRangeリクエスト1回で済むが、xref streamは圧縮されており取得後に解凍が必要で、複数のセグメントを含む場合もある
- オブジェクトストリーム(ObjStm):現代のPDFでは複数の小さなオブジェクトを1つの圧縮されたObjStmにまとめることが多く、pdf.jsはまずこのストリームを取得して解凍してから、中のオブジェクトオフセットを解析する必要がある
- オブジェクト間の参照:1ページ目のフォントや画像リソースがファイルの異なる位置に分散している場合、さらなるRangeリクエストが発生する
さらに厄介なことに、これらのリクエストは並列化が難しい——後のリクエストのオフセットは前のリクエストの解析結果に依存するためだ。これは直列的な処理フローであり、遅延は加算されていく。
加えて、Rangeリクエストで取得するのは生のバイトデータなので、サーバーは部分的なコンテンツにgzip圧縮をかけることができず、伝送効率には上限がある。大きなファイルでは1回のRangeリクエストで数十KBから数百KBの生バイトを取得することになる。
結論は明確だ:ブラウザ側のRangeだけでは、真の「即座表示+任意ページジャンプ」は実現できない。 初期化段階の複数の直列Rangeリクエストが、初回表示速度の天井となっている。
2. 技術的支柱その1:HTTP Rangeリクエスト——必要なバイトだけを取得する
StreamPDFの方案を説明する前に、Rangeリクエストについて整理しておこう。これは「ファイル全体をダウンロードしない」ための基本的な能力だ。
Rangeリクエストとは
HTTPプロトコルでは、クライアントがRangeリクエストヘッダーを使って、リソース全体ではなく特定のバイト範囲だけを取得できる:
GET /large.pdf HTTP/1.1
Range: bytes=0-65535サーバーが対応していれば206 Partial Contentを返し、Content-Rangeヘッダーで今回返却するバイト範囲を示す:
HTTP/1.1 206 Partial Content
Content-Range: bytes 0-65535/314572800
Content-Length: 65536
これによりクライアントは「必要な分だけバイトを取得する」能力を得る——ファイル先頭の64KBだけ必要な場合、300MB全体を取得する必要はない。
pdf.jsの2本並列戦略
pdf.jsはRangeの能力を徹底的に活用している。2本のデータチャネルを同時に維持する:
- 段階的全量ストリーム:ファイル先頭から順次ダウンロードしながら解析する。このチャネルはデータが順序通りに届くことを保証し、頭から読み進める一貫した閲覧に適している。
- 按需Range:パーサーがまだダウンロードされていないバイトに遭遇すると、
MissingDataExceptionを投げ、64KBのchunk境界にアライメントしてRangeリクエストを送り、欠けている区間を補完する。
2本のチャネルのデータは最終的に同じChunkedStreamに合流し、_loadedChunksという集合でどのchunkが取得済みかを記録して重複ダウンロードを回避する。
この部分のソースコードの詳細は PDF.jsを深く掘る:ネットワークストリームとRangeリクエスト を参照されたい。PDFFetchStream → PDFWorkerStream → NetworkPdfManager → ChunkedStreamManagerの呼び出し鎖が一通り説明されている。
解決されていない問題:構造の特定
Rangeは「按需でバイトを取得する方法」は解決したが、「どのバイトを取得すべきか」は解決していない。
正確にRangeリクエストを送るには、各ページに対応するバイトオフセットを事前に知っておく必要がある。Pages treeとxrefはファイル末尾にある——初回オープン時は必ず末尾をスキャンしなければならず、これ自体が追加のネットワーク往復となり、初回表示を本当に速くすることを妨げている。
言い換えれば、Rangeは「弾薬」だが、「どこに打てばいいか」を知るための「地図」も必要なのだ。
3. 技術的支柱その2:StreamPDFがファイル構造をサーバー側に配置する
StreamPDFの核心的な発想は、「地図を描く」作業を事前にサーバー側で終わらせてしまうことだ。
アップロード後のサーバー側事前解析
ユーザーがPDFをStreamPDFにアップロードすると、ファイルはアプリケーションサーバーを経由せず直接R2オブジェクトストレージに送信される。その後ModalバックエンドがこのPDFに対して事前解析を実行する:
- xrefを解析し、オブジェクト番号からバイトオフセットへのマッピングを作成する
- Pages treeを走査し、各ページのオブジェクト参照とバイト範囲を抽出する
- 描画に必要なメタデータ(ページサイズ、リソース参照など)を収集する
解析が完了すると、これらの「構造成果物」は元のPDFファイルと並んでR2に書き戻される。つまり、ファイルは一度アップロードされれば、構造は永久に「描かれた」状態になる。
リーダーはオープン時に構造を直接取得する
ユーザーがブラウザでこのPDFを開くとき、リーダーが最初に取得するのは元のファイルではなく、サーバー側で事前解析された構造データだ。
この構造データはサイズが小さく(通常数十KB程度)、直接「Nページ目→バイトオフセット」のマッピングを提供する。リーダーはこれを取得した後、1ページ目がどこにあるか、1200ページ目がどこにあるかを即座に知り、ファイル全体をスキャンする必要もなければ末尾のxrefをリクエストする必要もなくなる。
構造+Range=任意ページの即座表示
地図(構造データ)と弾薬(Rangeリクエスト)が揃えば、体験は以下のように変わる:
- 初回表示:1ページ目のバイト範囲だけを取得し、約1秒で描画される
- ジャンプ:1200ページ目を見たい場合、オフセットに基づいてRangeリクエストを1回送るだけ。即座に応答し、「後ろのページほど遅くなる」ことはない
- スクロール:表示領域外のページは按需で読み込まれ、数百MBを事前にダウンロードすることはない
これがStreamPDFで「大きなPDFをオンラインで即座に開ける」理由だ——ブラウザ側で最も時間のかかる「構造スキャン」をサーバー側に事前配置し、ブラウザは「構造を取得+バイトを取得+描画」だけを担当するようになる。
4. 体験面でのエンジニアリング的詳細
技術原理は説明したが、体験に落とし込む上でいくつかの細部がある。
初回即座表示(Time to First Screen)
StreamPDFでは初回表示時間を主要な指標として最適化に取り組んでいる。構造データが極めて小さいため、初回表示では実際に1ページ目のバイト範囲だけを取得する——通常数百KBから数MBであり、ファイル全体ではない。
ネイティブリーダーの「ファイル全体をダウンロードしてから描画」という方式と比べ、StreamPDFの初回表示時間はファイルの合計サイズとほぼ無関係で、1ページ目の複雑さにのみ依存する。ホームページのベンチマークエリアでは、初回表示タイマー(Time to First Screen)をリアルタイムで確認でき、400MBを超えるPDFでも約1秒で最初の画面が表示される。
任意ページ番号への即座ジャンプ
ページ番号からバイトオフセットへのマッピングはサーバー側で計算済みなので、任意ページへのジャンプは定数時間の参照とRangeリクエスト1回で実現する。
後ろのページにジャンプすると顕著に遅くなるリーダーも多いが、それはPages treeの前のノードを順次解析する必要があるからだ。StreamPDFにはこの問題はない——1ページ目と1000ページ目のジャンプ遅延はほぼ同じだ。
表示ページだけをダウンロード
閲覧中、リーダーは現在の表示領域内のページのバイトだけをリクエストする。下にスクロールすれば後のコンテンツを按需で読み込み、あるページで止まっていれば、残りの数百MBをバックグラウンドでこっそりダウンロードするようなことはない。
これはメモリと帯域の両方に優しく、スマートフォンで熱くならず通信量を消費しない要因でもある。
CDNエッジでの高速化
すべてのバイトリクエストはCDN(cdn-stream-pdf.streampdf.com)を経由してR2にオリジン取得する。エッジノードが人気のあるページのバイト範囲をキャッシュするため、同じページを繰り返し訪れる場合はほぼゼロレイテンシで応答する。
5. 拡張的な議論(オープンな話題)
以下の話題については標準的な回答を示さず、コメントでの意見交換を歓迎する。
サーバー側事前解析の限界はどこにあるのか?
サーバー側事前解析の前提は「解析できること」だ。となれば:
- 動的フォーム(AcroForm / XFA)を含むPDFでは、事前解析で得られる静的な構造だけで対話を支えるのに十分だろうか?フォームフィールドの状態を「ファイル全体をダウンロードしない」前提でどう同期するのか?
- 数万ページにも及ぶ超大ページ数のPDFでは、事前解析の成果物そのものが新たなボトルネックにならないだろうか?構造データのサイズと検索効率をどう制御するのか?
- 線形化(Linearized)されたPDFは元々「初回表示の高速化」のために最適化されている。サーバー側事前解析による付加価値はどれほどあるのか?
純クライアント側方案に未来はあるのか?
StreamPDFは「構造をサーバー側に事前配置する」方針を取っているが、純クライアント側方案にも意義がないわけではない:
- 将来的にブラウザがネイティブで「PDF構造インデックス」(EPUBのnav文書のようなもの)をサポートし、構造情報をファイル先頭に埋め込むようになれば、サーバー側事前解析はまだ必要だろうか?
- pdf.jsの段階的全量ストリーム+Rangeはすでに強力だ。「最初の数ページだけ見て閉じる」シナリオでは、純クライアント側方案でも十分なのではないか?どのようなシナリオでサーバー側方案がやはり代替できないものとなるのか?
「オンラインでダウンロードしない」ことによるプライバシーのトレードオフ
ファイルをクラウドに置くことは、当然プライバシーとコンプライアンスの問題を引き起こす。これからいくつか議論すべき方向性が生まれる:
- 「構造はサーバー側、バイトはクライアント側」というハイブリッド方案は可能だろうか?つまりサーバーには構造インデックスだけを置き、元のファイルはユーザーのローカルまたはプライベートストレージに残したままにする。
- 企業内の大きなPDFは、パブリッククラウドに配置できないことが多い。「配置しない」前提で、サーバー側レベルの即座表示体験を実現するにはどうすればよいのか?
6. 適用シナリオ
ここまで説明してきて、StreamPDFはどんな人に最も適しているのだろうか?
- よく大きなPDFを受け取る人:技術仕様書、法律契約書、製品マニュアル、学術論文集など。数ページ見るだけなのにファイル全体をダウンロードする必要がない
- ローカルストレージを消費したくない人:ファイルはクラウドに置き、いつでもオンラインで開ける。読み終わったらそのまま去ればよく、削除する必要もない
- スマートフォンユーザー:通信量を消費せず、ストレージを占めず、本体も熱くならない。大きなPDFもスマートフォンで快適に読める
- 大きなPDFを共有したい人:リンクを送れば、相手は開いてすぐ読める。数百MBをダウンロードさせる必要がない
7. 今すぐ試してみよう
ここまで聞いてきたけど、実際に試してみるのが一番だ:
- StreamPDF公式サイト を開く
- 大きなPDFをアップロードするか、PDFのリンクを直接貼り付ける
- 数秒で処理が完了すると、オンラインで即座に開き、ページを自由にめくれる
- 初回表示時間はリアルタイムで確認でき、任意のページへのジャンプも即座に応答する
おわりに
「ダウンロードしない」ことの本質は、実は必要なバイトだけを取得することだ。
これを実現するには2つの支柱が必要だ:HTTP Rangeが按需でバイトを取得する能力を提供し、サーバー側で事前に構造を配置することでブラウザがスキャンをスキップして各ページを正確に特定できるようになる。この2つが組み合わされれば、数百MBのPDFでもWebページのようにすぐに開いて読める。
「ダウンロード→待機→削除」のループにうんざりしているなら、今すぐ streampdf.com であなたの大きなPDFを試してみてほしい。
自己紹介:StreamPDF の创造者。AIとPDFの分野における研究開発に注力している。