수백 MB PDF를 다운로드 없이 HTTP Range + 서버 사전 파싱으로 온라인 즉시 열기
2026년 11월 3일 · StreamPDF Team
들어가며
동료가 200MB 이상의 기술 규격서를 보내 왔고, 링크를 클릭하니 브라우저 하단에 다운로드 진행 바가 뜬다 — 그리고 끝없는 기다림이 시작된다.
200MB부터 시작되는 PDF는 일반적인 네트워크 환경에서 다운로드에 1~2분이 걸릴 수 있다; 로컬에 다운로드하면 저장 공간을 차지하고, 다 읽은 후에는 수동으로 정리해야 한다; 휴대폰으로 열면 데이터가 낭비되고 저장소가 차며 기기도 뜨거워진다.
문제가 생겼다: PDF를 볼 때, 정말 전체 파일을 다운로드해야 할까?
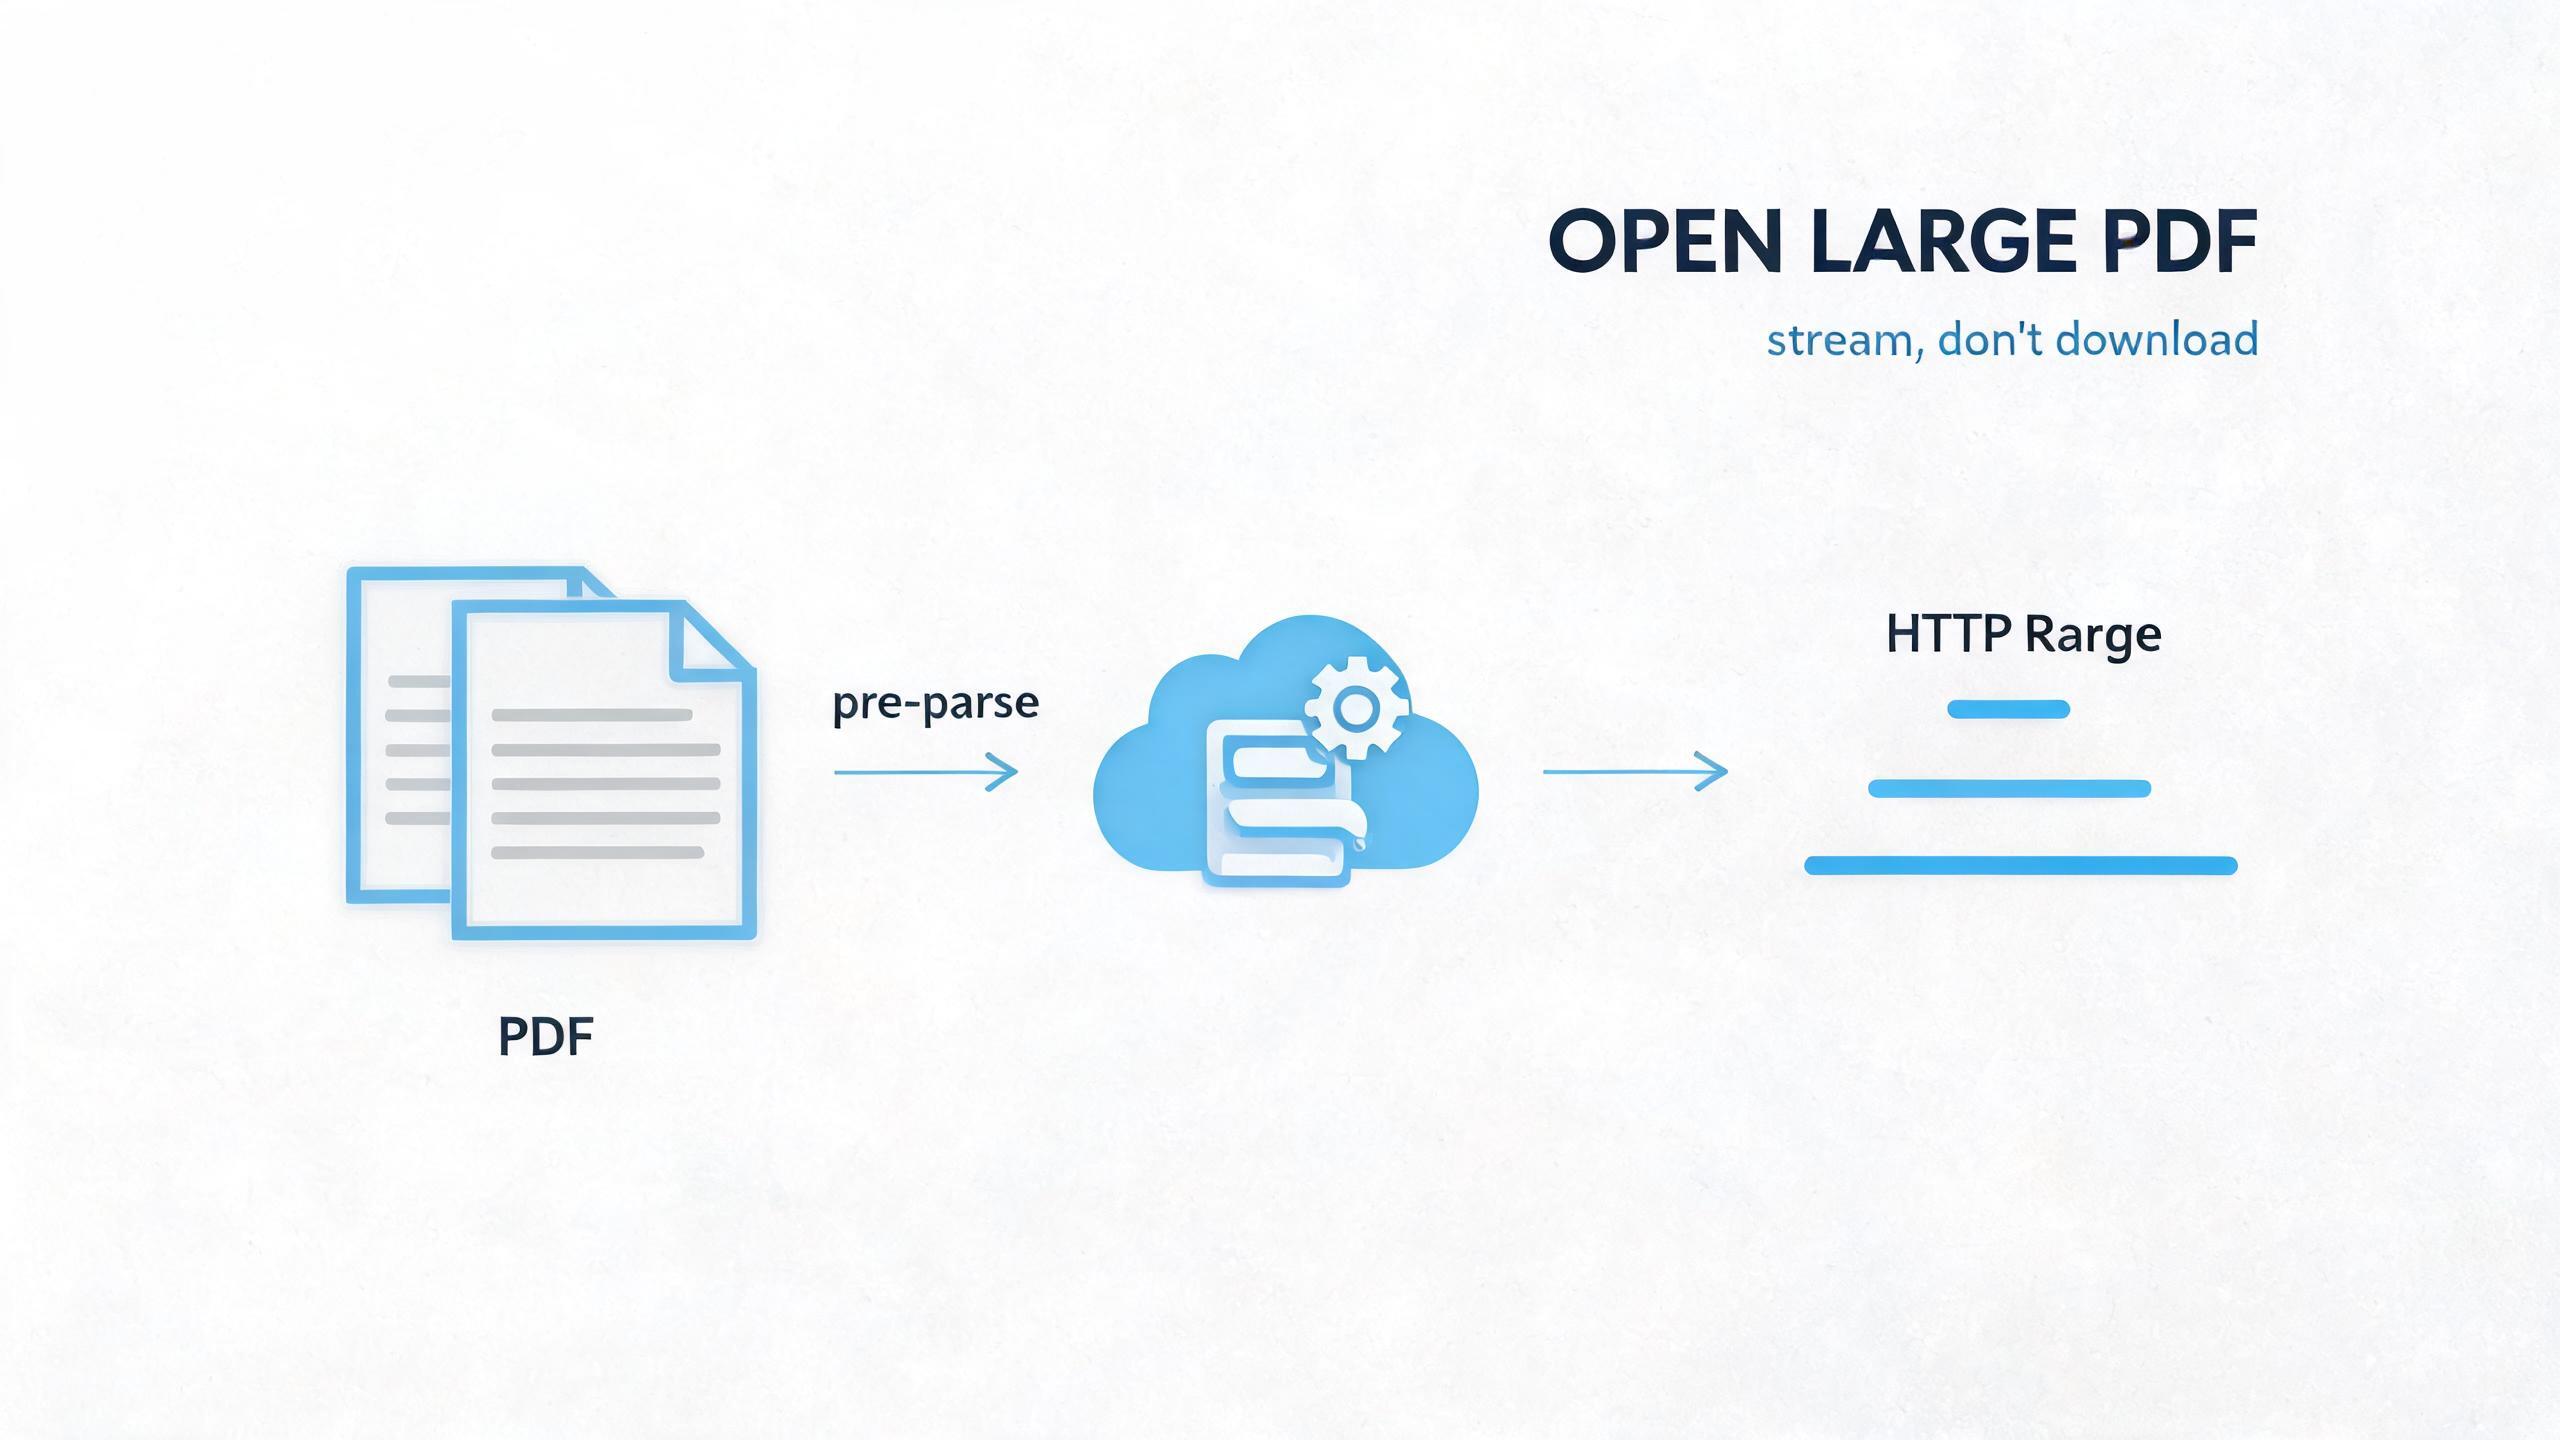
정답은 아니다. 「큰 PDF를 온라인으로 열되 전체 파일을 다운로드하지 않으려면」 핵심은 두 가지다: HTTP Range 요청 — 필요한 바이트만 가져오는 것; 그리고 서버에서 파일 구조를 사전에 파싱 — 브라우저가 스캔을 건너뛰고 각 페이지가 어디 있는지 바로 알게 하는 것.
이 글에서는 이 두 가지의 기술 원리를 분해하고, StreamPDF가 이들을 어떻게 조합해 「첫 화면은 약 1초, 1000페이지로 점프하는 것도 즉시 응답」하는 경험을 만들어냈는지 설명할 것이다.
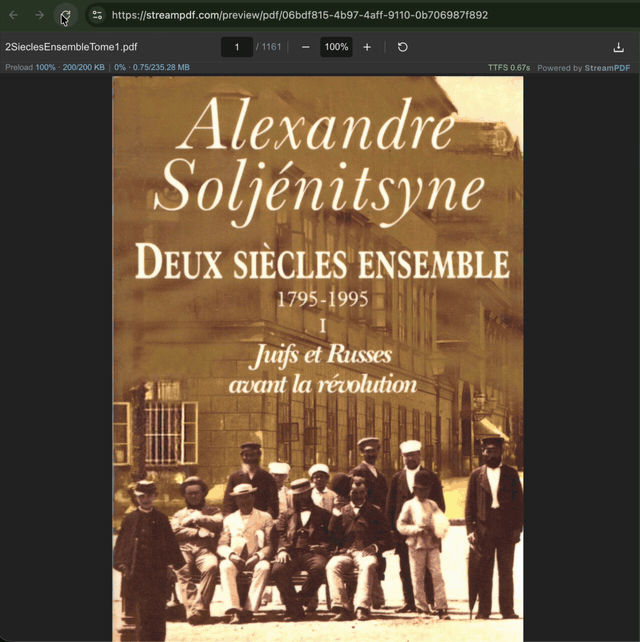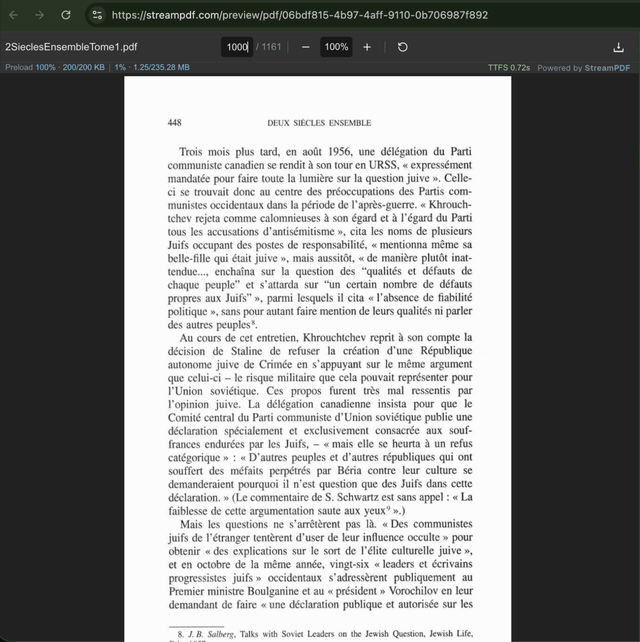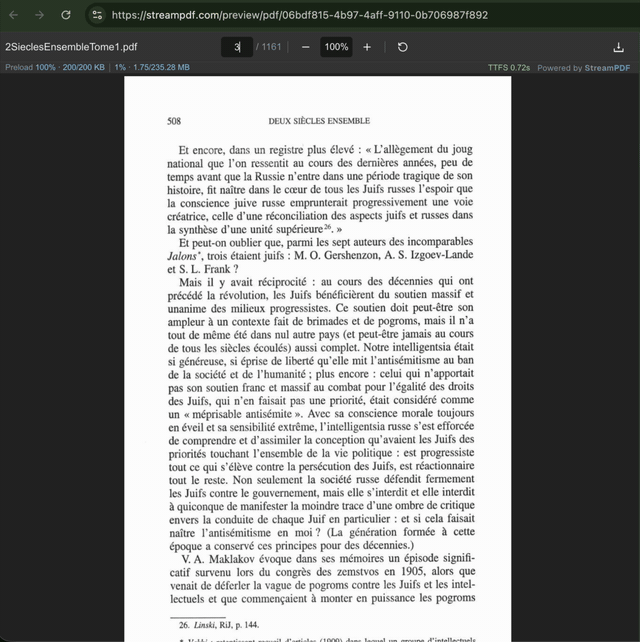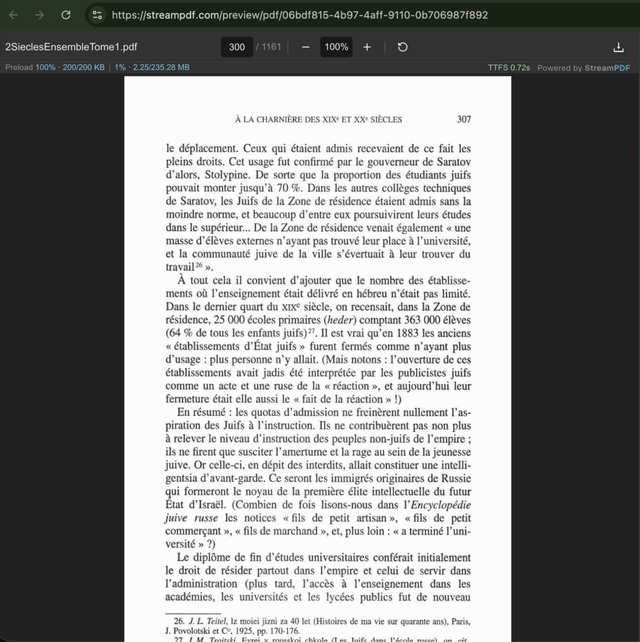
리더 주소: https://streampdf.com/preview/pdf/06bdf815-4b97-4aff-9110-0b706987f892
1. 왜 「전체 파일 다운로드」가 큰 PDF를 여는 가장 큰 장벽인가
기존 리더의 처리 흐름
대부분의 데스크톱 PDF 리더와 브라우저의 「온라인 미리보기」는 동일한 흐름을 따른다:
파일 전체 다운로드 → 파일 전체 구조 파싱 → 첫 페이지 렌더링
즉, 첫 화면 시간은 대략 「다운로드 시간 + 파싱 시간」과 같다. 파일이 클수록 다운로드가 오래 걸려 첫 화면은 느려진다. 300MB 파일은 파싱이 수백 밀리초밖에 걸리지 않더라도, 다운로드만으로 첫 화면이 분 단위로 지연될 수 있다.
더 나쁜 것은, 다운로드가 「전체 아니면 전혀 없음」이라는 점이다 — 5페이지만 보고 싶어도 1페이지부터 1000페이지까지의 바이트를 모두 로컬로 가져와야 한다.
pdf.js조차도, 처음 열 때는 파일 끝부분 스캔을 피할 수 없다
pdf.js는 현재 웹에서 가장 주류적인 PDF 렌더링 엔진으로, 이미 HTTP Range 요청을 지원해 필요한 바이트만 가져올 수 있다. 하지만 여전히 피할 수 없는 병목이 있다.
PDF 파일의 구조 색인인 **xref(교차 참조 테이블)**와 Pages tree는 보통 파일 끝부분에 위치한다. 「N페이지가 파일의 어느 바이트 오프셋에 있는지」를 알려면, 파서가 먼저 끝부분의 xref를 읽고 Pages tree를 따라 목표 페이지까지 탐색해야 한다.
여기서 간과하기 쉬운 세부 사항이 있다: 「끝부분을 요청해 구조를 가져온다」는 것은 단 한 번의 Range 요청으로 끝나지 않는다는 점이다.
PDF 초기화는 객체 참조를 따라 단계별로 내려가는 흐름이다. pdf.js의 실제 과정은 대략 다음과 같다:
- 먼저 파일 끝부분 약 1KB를 읽어
startxref마커를 찾는다 — 이것이 xref(교차 참조 테이블)의 시작 오프셋을 가리킨다 - 이 오프셋으로 Range를 보내 xref를 가져온다. xref는 각 객체 번호에서 바이트 오프셋으로의 매핑을 제공하지만, 그 자체가 일반적인 xref table일 수도 있고 압축된 xref stream일 수도 있다 — 후자는 먼저 압축을 풀어야 한다
- xref에서 Catalog 객체의 오프셋을 찾아 다시 Range를 보내 Catalog을 가져온다
- Catalog 안에 Pages tree 루트 노드 참조가 있으므로, 계속 Range를 보내 Pages 루트를 가져온다
- Pages tree는 평평한 목록이 아니라 트리다. 첫 페이지를 찾으려면 루트 노드에서 잎 노드까지 탐색해야 할 수 있으며, 각 중간 노드마다 Range 요청이 필요할 수 있다
- 마침내 첫 페이지의 페이지 객체를 가져온 후, 그것의 content stream과 리소스(폰트, 이미지 참조)를 가져와야 렌더링을 시작할 수 있다
즉, startxref에서 「첫 페이지 렌더링 가능」까지 사이에 5~10번 이상의 Range 요청이 있을 수 있으며, 매번 네트워크 왕복이 발생한다.
그리고 「구조가 제각각」이기 때문에 이 숫자는 매우 불안정하다:
- Pages tree 깊이: 어떤 PDF는 Pages tree가 2층(루트 → 모든 페이지)이지만, 어떤 것은 다층 균형 트리라 깊이가 클수록 요청이 많아진다
- xref 타입: xref table은 평문이라 한 번의 Range로 충분하다; xref stream은 압축되어 있어 가져온 후 압축을 풀어야 하며, 여러 분할을 포함할 수 있다
- 객체 스트림(ObjStm): 현대 PDF는 여러 작은 객체를 하나의 압축된 객체 스트림에 묶는 경우가 많아, pdf.js는 먼저 이 스트림을 가져와 압축을 풀어야 내부의 객체 오프셋을 파싱할 수 있다
- 교차 객체 참조: 첫 페이지의 폰트, 이미지 리소스가 파일의 여러 위치에 흩어져 있을 수 있어 추가적인 Range 요청이 발생한다
더 번거로운 것은, 이런 요청들이 병렬화하기 어렵다는 점이다 — 다음 요청의 오프셋이 이전 요청이 반환한 파싱 결과에 의존하기 때문이다. 이는 직렬 흐름이며, 지연은 더해진다.
게다가 Range 요청으로 가져오는 것은 원시 바이트이므로, 서버는 부분 콘텐츠에 대해 gzip 압축을 할 수 없어 전송 효율에 상한이 있다. 큰 파일의 경우, 한 번의 Range가 수십 KB에서 수백 KB의 원시 바이트일 수 있다.
결론은 명확하다: 브라우저 측 Range만으로는 진정한 「즉시 열기 + 임의 페이지 점프」를 할 수 없다. 초기화 단계의 여러 직렬 Range 요청이 첫 화면 속도의 천장이다.
2. 기술 기둥 1: HTTP Range 요청 — 필요한 바이트만 가져오기
StreamPDF의 솔루션을 말하기 전에, Range 요청 자체를 명확히 하자. 그것이 「전체 파일을 다운로드하지 않는」 기반 능력이다.
Range 요청이란 무엇인가
HTTP 프로토콜은 클라이언트가 Range 요청 헤더를 통해 리소스의 특정 바이트 구간만 가져올 수 있게 한다:
GET /large.pdf HTTP/1.1
Range: bytes=0-65535
서버가 지원한다면 206 Partial Content를 반환하고, Content-Range 헤더에서 이번에 반환하는 바이트 구간을 명시한다:
HTTP/1.1 206 Partial Content
Content-Range: bytes 0-65535/314572800
Content-Length: 65536
이것은 클라이언트에게 「필요한 바이트만 가져오는」 능력을 준다 — 파일 시작 부분의 64KB만 필요하다면 300MB 전체를 다 가져올 필요가 없다.
pdf.js의 두 경로 병렬 전략
pdf.js는 Range 능력을 철저하게 활용한다. 두 개의 데이터 경로를 동시에 유지한다:
- 점진적 전체 스트림: 파일 헤더부터 순차적으로 다운로드하면서 다운로드와 동시에 파싱한다. 이 경로는 데이터가 순서대로 도착하도록 보장해, 처음부터 읽는 연속적인 열람에 적합하다.
- 필요 시 Range: 파서가 현재 아직 다운로드되지 않은 바이트를 만나면
MissingDataException을 던진 후, 64KB chunk 경계에 정렬해 한 번의 Range 요청을 보내 누락된 구간을 채운다.
두 경로의 데이터는 결국 동일한 ChunkedStream으로 합쳐지며, _loadedChunks 집합으로 어느 chunk가 도착했는지 기록해 중복 다운로드를 피한다.
이 부분의 소스 세부 사항은 PDF.js Deep Dive: Network Streams and Range Requests를 참고할 수 있다 — 여기서 PDFFetchStream → PDFWorkerStream → NetworkPdfManager → ChunkedStreamManager 호출 체인을 완벽하게 따라간다.
여전히 해결되지 않은 문제: 구조 위치 파악
Range는 「어떻게 필요한 바이트만 가져올지」를 해결하지만, 「어느 구간의 바이트를 가져와야 할지」는 해결하지 못한다.
Range를 정확하게 보내려면 각 페이지에 해당하는 바이트 오프셋을 먼저 알아야 한다. 그리고 Pages tree와 xref는 파일 끝부분에 있으므로 — 처음 열 때는 반드시 끝부분을 먼저 스캔해야 하고, 이 단계 자체가 추가적인 네트워크 왕복이어 첫 화면이 정말 빨라질 수 없게 한다.
다시 말해, Range는 「탄약」이지만, 어디에 쏠지 알려면 「지도」가 필요하다.
3. 기술 기둥 2: StreamPDF, 파일 구조를 서버로 앞당기다
StreamPDF의 핵심 아이디어는 「지도를 그리는」 일을 서버에서 미리 끝내버리는 것이다.
업로드 후 서버 사전 파싱
사용자가 PDF를 StreamPDF에 업로드하면, 파일은 R2 객체 스토리지로 직접 전송되어 바이트가 애플리케이션 서버를 거치지 않는다. 그 후 Modal 백엔드가 이 PDF에 대해 한 번 사전 파싱을 수행한다:
- xref를 파싱해 객체 번호에서 바이트 오프셋으로의 매핑을 구축한다
- Pages tree를 탐색해 각 페이지의 객체 참조와 바이트 범위를 추출한다
- 렌더링에 필요한 메타데이터(페이지 크기, 리소스 참조 등)를 수집한다
파싱이 완료되면, 이 「구조 산출물」은 원본 PDF 파일과 함께 R2에 다시 기록된다. 다시 말해, 파일을 한 번 업로드하면 구조는 영구적으로 「그려지게」 된다.
리더가 열 때 바로 구조를 받는다
사용자가 브라우저에서 이 PDF를 열 때, 리더가 먼저 가져오는 것은 원본 파일이 아니라 서버가 사전 파싱한 구조 데이터다.
이 구조 데이터는 부피가 작아(보통 수십 KB에 불과하지만), 「N페이지 → 바이트 오프셋」 매핑을 직접 제공한다. 리더는 이것을 받은 후 첫 페이지가 어느 위치에 있는지, 1200페이지가 어느 위치에 있는지 바로 알게 되어, 파일 전체를 스캔할 필요도 없고 끝부분의 xref를 요청할 필요도 없다.
구조 + Range = 임의 페이지 즉시 열기
지도(구조 데이터)와 탄약(Range 요청)이 생기면 경험은 이렇게 바뀐다:
- 첫 화면: 첫 페이지가 속한 바이트 구간만 가져와 약 1초 만에 렌더링된다
- 점프: 1200페이지를 보고 싶으면 오프셋에 맞춰 한 번의 Range를 보내 즉시 응답하며, 「뒤로 갈수록 느려지는」 현상이 없다
- 스크롤: 가시 영역 밖의 페이지는 필요 시 로드되며, 수백 MB를 미리 다운로드하지 않는다
이것이 StreamPDF가 「큰 PDF 온라인 즉시 열기」를 할 수 있는 이유다 — 브라우저 측에서 가장 시간이 오래 걸리는 「구조 스캔」을 서버로 앞당겼고, 브라우저는 「구조 받기 + 바이트 가져오기 + 렌더링」만 하면 된다.
4. 경험 측면의 엔지니어링 세부 사항
기술 원리를 설명했으니, 실제 경험으로 와닿는 몇 가지 세부 사항을 말하자.
첫 화면 즉시 열기(Time to First Screen)
StreamPDF는 첫 화면 시간을 핵심 지표로 삼아 최적화한다. 구조 데이터가 극도로 작기 때문에, 첫 화면은 실제로 첫 페이지의 바이트 구간만 가져온다 — 보통 수백 KB에서 몇 MB 수준이며, 파일 전체가 아니다.
기존 리더의 「파일 전체를 다운로드해야만 렌더링할 수 있다」는 방식과 비교해, StreamPDF의 첫 화면 시간은 파일 전체 크기와 거의 무관하며 첫 페이지의 복잡도와만 관련된다. 메인 페이지의 벤치마크 영역에서 첫 화면 타이머(Time to First Screen)를 실시간으로 볼 수 있으며, 400MB 이상의 PDF도 약 1초 만에 첫 화면이 뜬다.
임의 페이지 번호 즉시 점프
페이지 번호에서 바이트 오프셋으로의 매핑이 서버에서 이미 계산되어 있기 때문에, 임의 페이지로 점프하는 것은 상수 시간의 조회 + 한 번의 Range 요청이다.
많은 리더가 뒤쪽 페이지로 점프할 때 뚜렷하게 느려지는데, 이는 앞쪽 Pages tree 노드를 순차적으로 파싱해야 하기 때문이다. StreamPDF에는 이 문제가 없다 — 1페이지와 1000페이지의 점프 지연이 거의 동일하다.
보이는 페이지만 다운로드
열람 과정에서 리더는 현재 가시 영역 내의 페이지 바이트만 요청한다. 아래로 스크롤할 때만 필요에 따라 뒤 콘텐츠를 로드하고, 특정 페이지에 머물러 있으면 백그라운드에서 남은 수백 MB를 몰래 다운로드하지 않는다.
이는 메모리와 대역폭 모두에 친절하며, 휴대폰에서 뜨거워지지 않고 데이터가 낭비되지 않는 핵심이다.
CDN 엣지 가속
모든 바이트 요청은 CDN(cdn-stream-pdf.streampdf.com)을 거쳐 R2로 회귀한다. 엣지 노드는 인기 페이지의 바이트 구간을 캐시해, 같은 페이지를 반복해서 방문할 때 거의 제로 지연이다.
5. 확장 토론(개방형 주제)
아래 주제에는 정답을 제시하지 않으며, 댓글로 의견을 나눠 보시길 바란다.
서버 사전 파싱의 경계는 어디인가?
서버 사전 파싱의 전제는 「파싱할 수 있다」는 것이다. 그렇다면:
- 동적 양식(AcroForm / XFA)을 포함한 PDF에서, 사전 파싱한 정적 구조만으로 상호작용을 충분히 지원할 수 있을까? 양식 필드의 상태는 「전체 파일을 다운로드하지 않는」 전제 하에 어떻게 동기화할까?
- 페이지 수가 극도로 많은(수만 페이지) PDF에서, 사전 파싱 산출물 자체가 새로운 병목이 되지는 않을까? 구조 데이터의 부피와 조회 효율은 어떻게 제어할까?
- 리니어화(Linearized)된 PDF는 이미 「빠른 첫 화면」에 맞춰 최적화되어 있는데, 서버 사전 파싱이 이 PDF에 얼마나 더 큰 이득을 줄까?
순수 클라이언트 방식에도 미래가 있을까?
StreamPDF는 「서버에 구조를 앞당기는」 방식을 택했지만, 순수 클라이언트 방식이 의미가 없는 것은 아니다:
- 미래에 브라우저가 「PDF 구조 색인」(EPUB의 nav 문서와 유사)을 네이티브로 지원해 구조 정보가 파일 헤더에 내장된다면, 여전히 서버 사전 파싱이 필요할까?
- pdf.js의 점진적 전체 스트림 + Range는 이미 강력한데, 「앞 몇 페이지만 보고 닫는」 시나리오에서는 순수 클라이언트 방식으로 이미 충분할까? 어떤 시나리오에서 서버 방식이 여전히 대체 불가능할까?
「온라인에서 다운로드하지 않는」 것의 프라이버시 트레이드오프
파일이 클라우드에 존재하는 것은 자연스럽게 프라이버시와 컴플라이언스 문제를 가져온다. 이는 몇 가지 논의할 만한 방향을 이끌어낸다:
- 「구조는 서버에, 바이트는 클라이언트에」인 하이브리드 방식은 가능할까? 즉 서버는 구조 색인만 저장하고 원본 파일은 여전히 사용자 로컬이나 프라이빗 스토리지에 남겨두는 방식이다.
- 기업 내부의 큰 PDF는 공용 클라우드에 적재할 수 없는 경우가 많다. 「적재하지 않는」 전제 하에 서버 수준의 즉시 열기 경험을 어떻게 만들까?
6. 적합한 활용 시나리오
이제까지 말한 StreamPDF가 누구에게 가장 적합한지:
- 큰 PDF를 자주 받는 사람: 기술 규격서, 법률 계약서, 제품 매뉴얼, 학술 논문집 — 몇 페이지 보려고 전체 파일을 다운로드할 필요가 없다
- 로컬 저장소를 차지하고 싶지 않은 사람: 파일은 클라우드에 있어 언제든 온라인으로 열 수 있고, 보고 나면 끝이라 정리할 필요가 없다
- 휴대폰 사용자: 데이터가 낭비되지 않고 저장소를 차지하지 않으며 기기도 뜨거워지지 않는다 — 큰 PDF도 휴대폰에서 부드럽게 볼 수 있다
- 큰 PDF를 공유해야 하는 사람: 링크 하나를 보내면 상대방이 바로 열어 읽을 수 있어, 수백 MB를 다운로드시킬 필요가 없다
7. 지금 바로 체험해 보자
이렇게 말했으니 직접 확인해 보는 게 좋다:
- StreamPDF 공식 웹사이트 를 연다
- 큰 PDF를 업로드하거나 PDF 링크를 직접 붙여넣는다
- 몇 초 처리 후 온라인 즉시 열리고 페이지를 자유롭게 넘길 수 있다
- 첫 화면 시간이 실시간으로 보이며, 임의 페이지로 점프하는 것도 즉시 응답한다
마무리
「다운로드하지 않는」 것의 본질은 사실 필요한 바이트만 가져오는 것이다.
이것을 실현하려면 두 기둥이 필요하다: HTTP Range가 필요한 바이트를 가져오는 능력을 제공하고, 서버 사전 파싱이 브라우저가 스캔을 건너뛰고 각 페이지를 정확하게 위치시키게 한다. 둘이 결합되면, 수백 MB PDF도 웹페이지처럼 바로 열어볼 수 있다.
만약 당신도 「다운로드 → 기다림 → 정리」의 순환에 지쳤다면, 지금 바로 streampdf.com 에 가서 당신의 큰 PDF를 체험해 보시길 바란다.
저에 대해: StreamPDF 창업자, AI와 PDF 분야의 연구와 개발에 몰두하고 있습니다.