Không muốn tải xuống PDF hàng trăm MB? Chúng tôi đã làm được việc mở tức thì trực tuyến bằng HTTP Range + phân tích trước phía máy chủ
3 tháng 11, 2026 · StreamPDF Team
Mở đầu
Đồng nghiệp gửi một bản quy phạm kỹ thuật hơn 200MB, bạn nhấp vào liên kết, thanh tiến trình tải xuống bật lên ở cuối trình duyệt — và rồi là một sự chờ đợi kéo dài.
PDF bắt đầu từ 200MB, tải xuống trên mạng thông thường có thể mất một hoặc hai phút; sau khi tải về máy còn chiếm dung lượng lưu trữ, sau khi đọc xong còn phải dọn dẹp thủ công; nếu mở trên điện thoại, lưu lượng chạy hết, dung lượng đầy, máy cũng nóng lên.
Câu hỏi đặt ra: Để đọc PDF, có nhất thiết phải tải xuống toàn bộ tệp không?
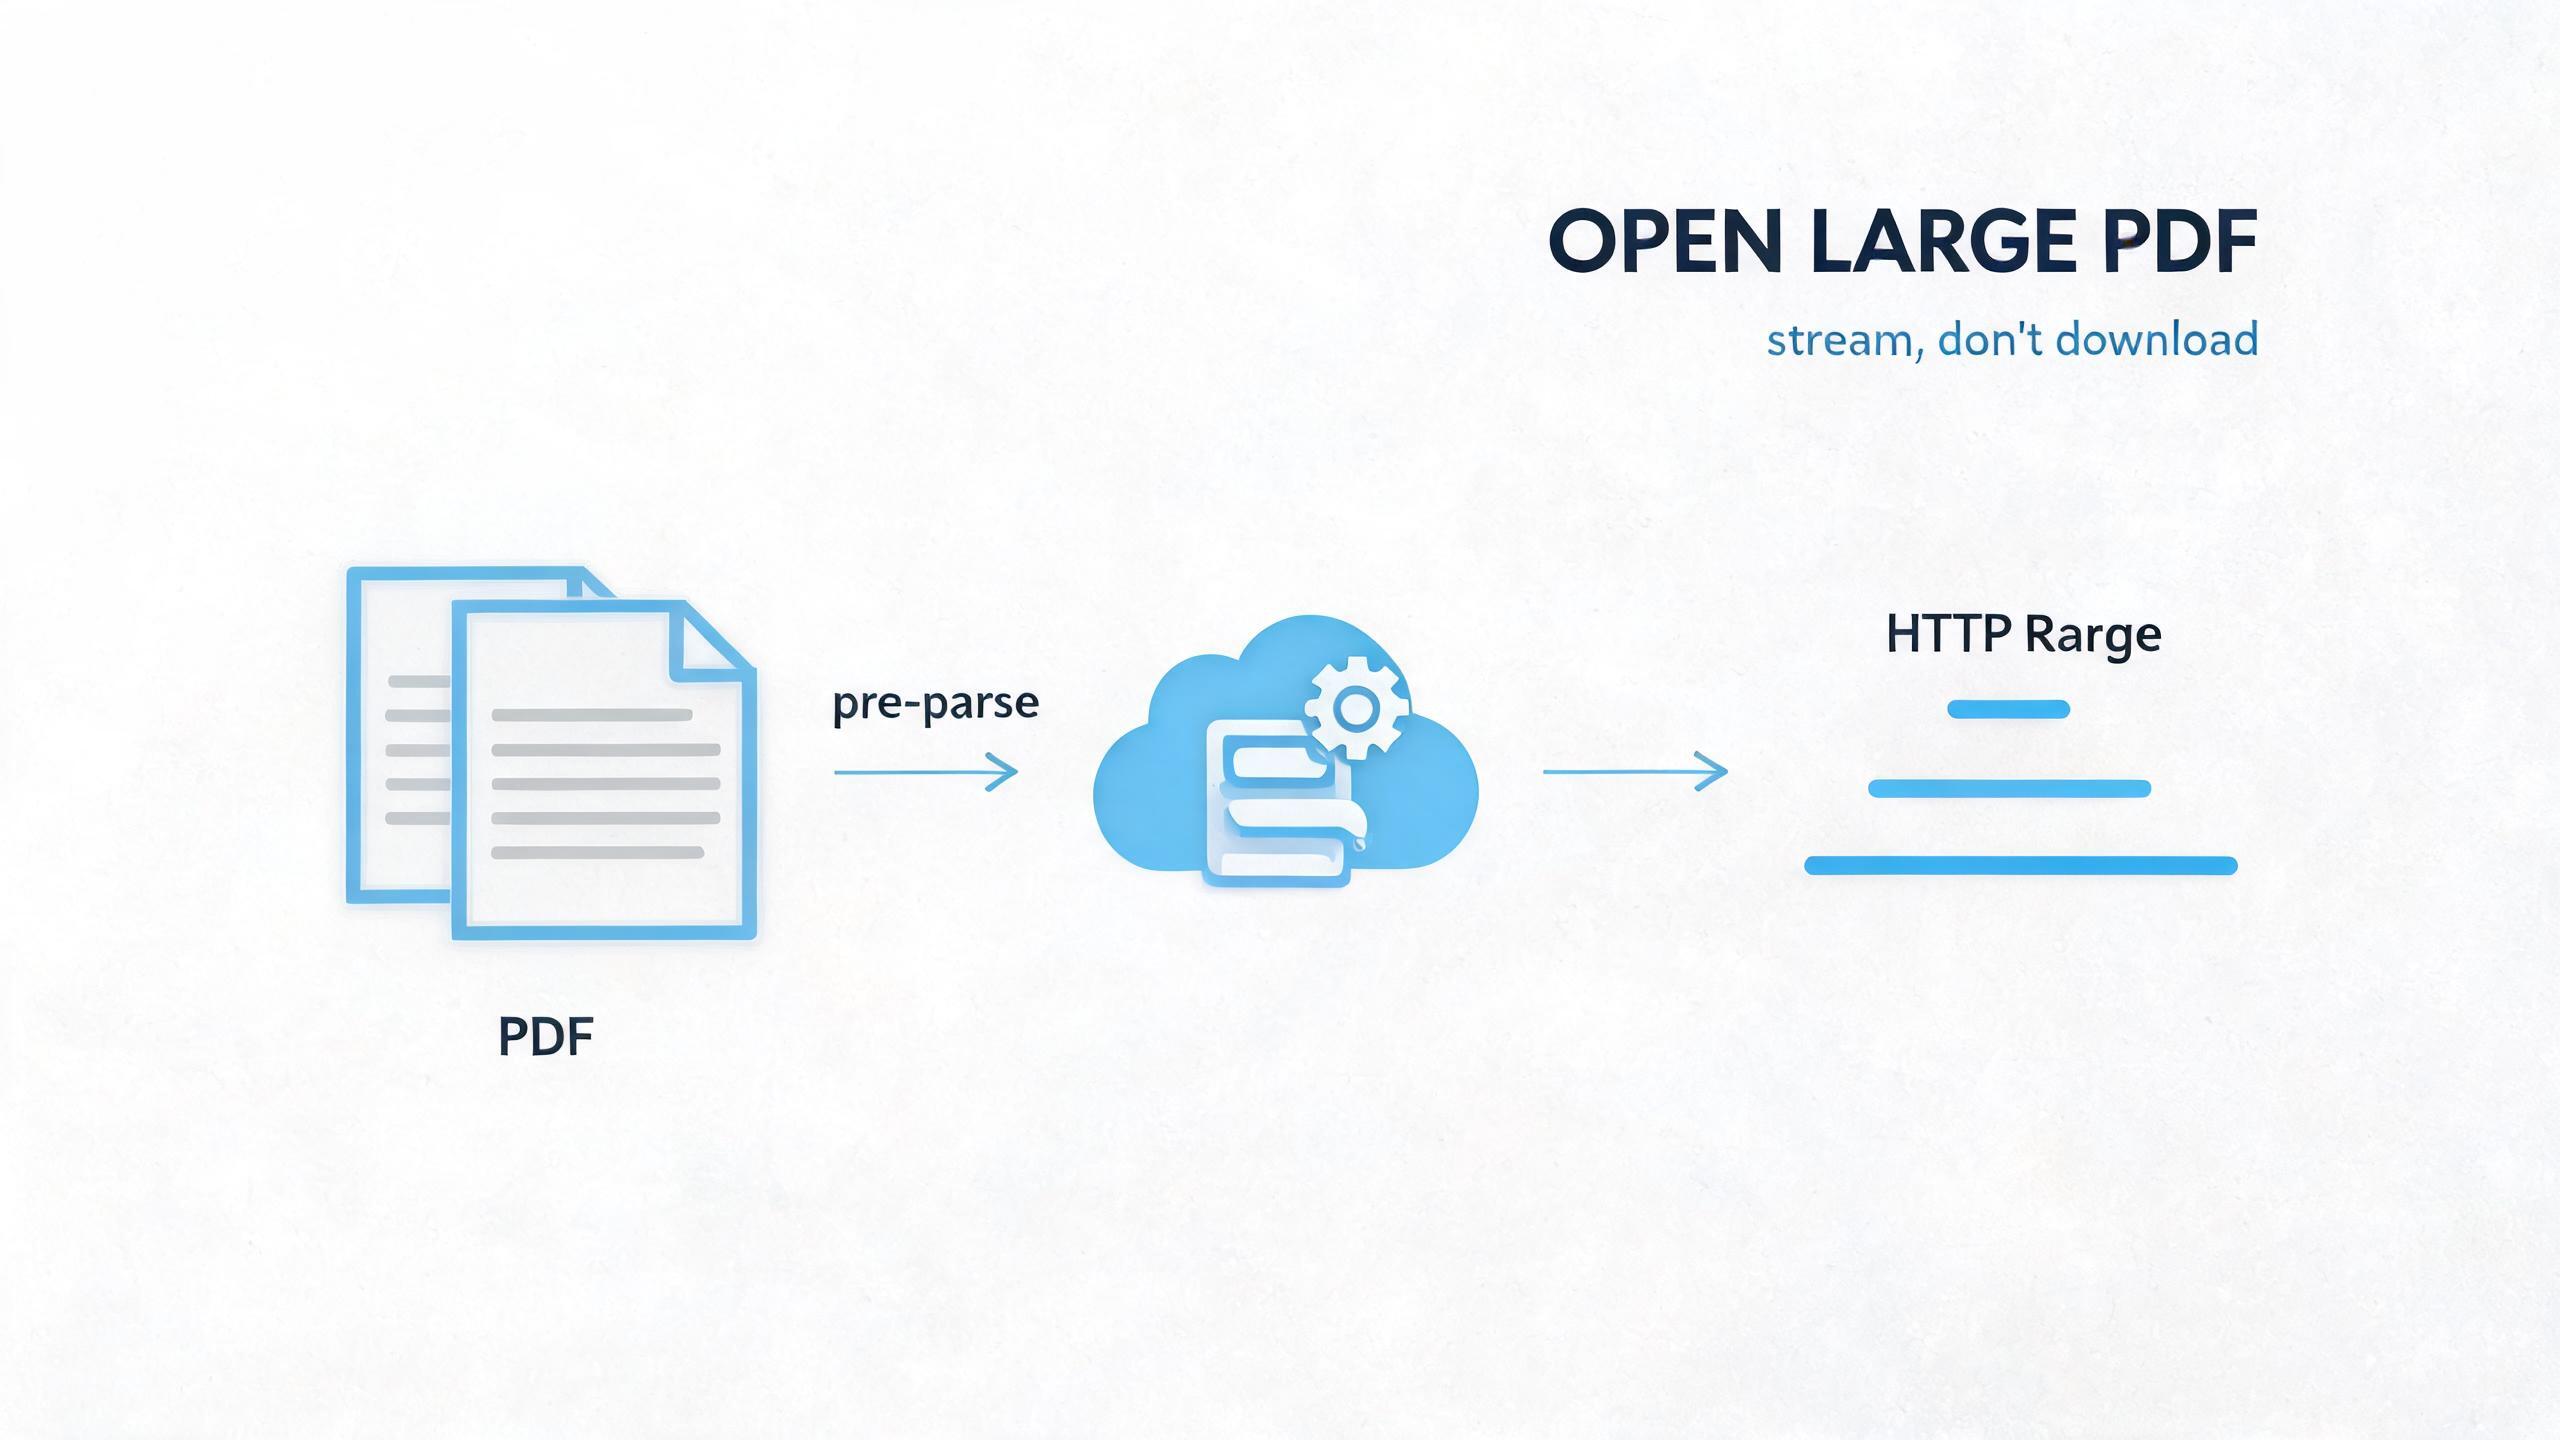
Câu trả lời là không cần. Để đạt được "mở PDF lớn trực tuyến mà không tải xuống toàn bộ tệp", cốt lõi là hai việc: Yêu cầu HTTP Range — chỉ lấy các byte cần thiết; và Phân tích trước cấu trúc tệp phía máy chủ — để trình duyệt bỏ qua việc quét, trực tiếp biết mỗi trang nằm ở đâu.
Bài viết này sẽ phân tích nguyên lý kỹ thuật của hai việc này, cùng cách StreamPDF kết hợp chúng thành trải nghiệm "màn hình đầu tiên khoảng 1 giây, nhảy đến trang thứ 1000 cũng phản hồi tức thì".
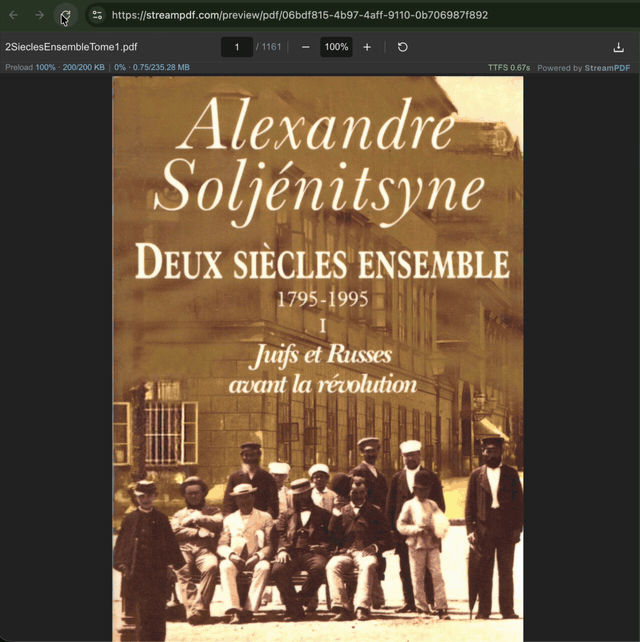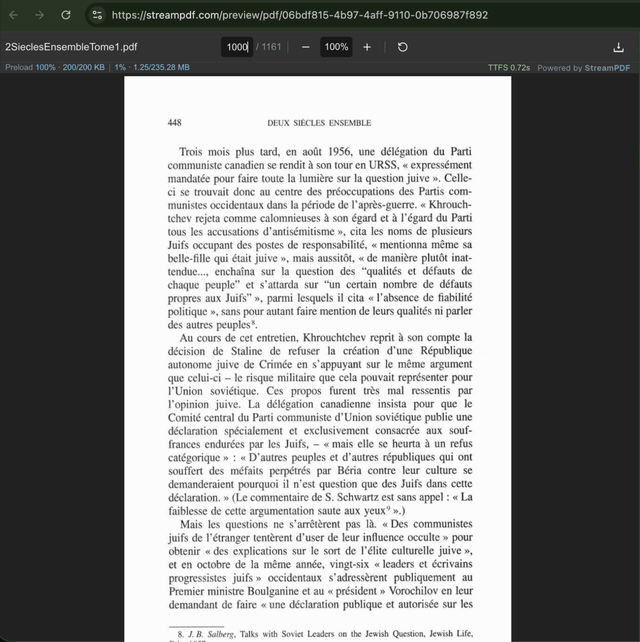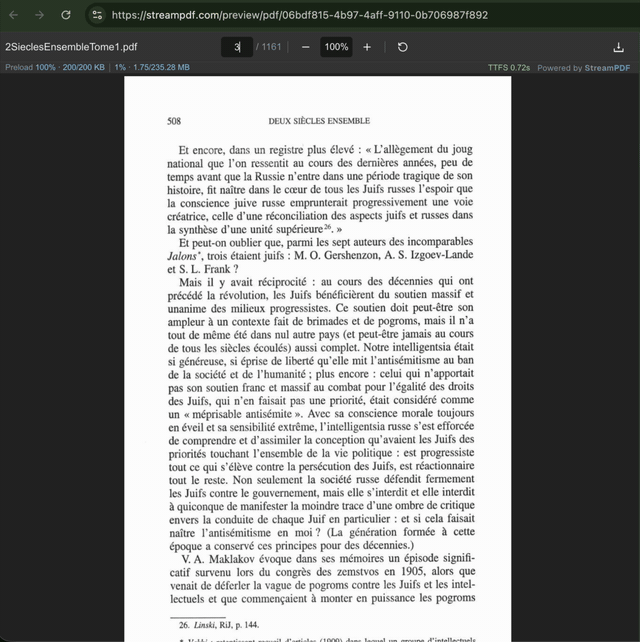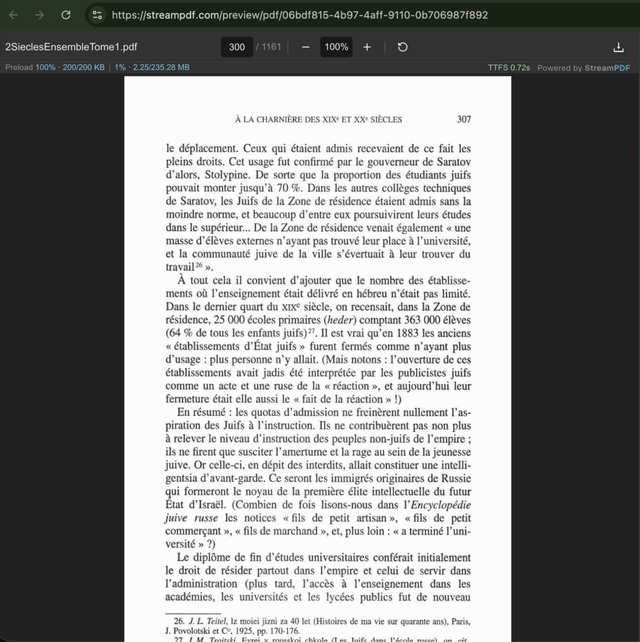
Địa chỉ trình đọc: https://streampdf.com/preview/pdf/06bdf815-4b97-4aff-9110-0b706987f892
I. Tại sao "tải xuống toàn bộ tệp" là rào cản lớn nhất khi mở PDF lớn
Chuỗi hoạt động của trình đọc truyền thống
Hầu hết trình đọc PDF trên máy tính để bàn và chức năng "xem trước trực tuyến" của trình duyệt, phía sau đều đi theo cùng một chuỗi hoạt động:
Tải xuống hoàn toàn tệp → Phân tích toàn bộ cấu trúc tệp → Vẽ trang đầu tiên
Nghĩa là thời gian màn hình đầu tiên xấp xỉ bằng "thời gian tải xuống + thời gian phân tích". Tệp càng lớn, tải xuống càng lâu, màn hình đầu tiên càng chậm. Một tệp 300MB, dù phân tích chỉ mất vài trăm mili giây, chỉ riêng việc tải xuống cũng có thể kéo màn hình đầu tiên lên phút.
Còn tệ hơn, việc tải xuống là kiểu "có hết hay không có gì" — bạn chỉ muốn xem trang thứ 5, cũng phải kéo tất cả byte của trang 1 đến trang 1000 về máy.
Ngay cả pdf.js, lần mở đầu tiên cũng không thể tránh việc quét cuối tệp
pdf.js là công cụ vẽ PDF chính thống nhất trên Web hiện nay, bản thân nó đã hỗ trợ yêu cầu HTTP Range, có thể lấy byte theo nhu cầu. Nhưng nó vẫn có một điểm nghẽn không thể tránh được.
Chỉ mục cấu trúc của tệp PDF — xref (bảng tham chiếu chéo) và cây trang (Pages tree) — thường nằm ở cuối tệp. Để biết "trang thứ N nằm ở offset byte nào trong tệp", trình phân tích phải đọc xref ở cuối trước, sau đó theo cây trang duyệt đến trang đích.
Ở đây có một chi tiết dễ bị bỏ qua: cái gọi là "yêu cầu cuối tệp để lấy cấu trúc", không phải một yêu cầu Range là xong.
Khởi tạo PDF là một chuỗi xuống sâu từng lớp theo tham chiếu đối tượng. Quá trình thực tế của pdf.js gần như như sau:
- Đọc khoảng 1KB cuối tệp trước, tìm dấu hiệu
startxref, nó chỉ ra offset bắt đầu của xref (bảng tham chiếu chéo) - Gửi Range theo offset này, lấy xref. xref đưa ra ánh xạ từ số hiệu mỗi đối tượng đến offset byte, nhưng bản thân nó có thể là xref table thông thường, cũng có thể là xref stream nén — cái sau cần giải nén trước
- Tìm offset của đối tượng Catalog từ xref, sau đó gửi một Range nữa để lấy Catalog
- Trong Catalog có tham chiếu đến nút gốc của cây Pages, tiếp tục gửi Range để lấy gốc Pages
- Cây Pages là một cây, không phải danh sách phẳng. Để định vị trang đầu tiên, có thể phải duyệt từ nút gốc xuống nút lá, mỗi nút trung gian đều có thể cần một yêu cầu Range
- Cuối cùng lấy được đối tượng trang của trang đầu tiên, sau đó lấy luồng nội dung (content stream) và tài nguyên (tham chiếu phông chữ, hình ảnh) của nó, mới có thể bắt đầu vẽ
Nghĩa là, từ startxref đến "trang đầu tiên có thể vẽ", có thể có 5~10 lần thậm chí nhiều yêu cầu Range hơn ở giữa, mỗi lần đều là một vòng đi lại mạng.
Và "cấu trúc đa dạng" quyết định con số này rất không ổn định:
- Độ sâu cây trang: Có PDF cây trang hai lớp (gốc → tất cả trang), có PDF là cây cân bằng nhiều lớp, độ sâu càng lớn yêu cầu càng nhiều
- Loại xref: xref table là văn bản thuần túy, một Range là xong; xref stream là nén, sau khi lấy còn phải giải nén, và có thể chứa nhiều phân đoạn
- Luồng đối tượng (ObjStm): PDF hiện đại thường đóng gói nhiều đối tượng nhỏ vào một luồng đối tượng nén, pdf.js cần lấy được luồng này và giải nén trước, mới có thể phân tích ra offset của các đối tượng bên trong
- Tham chiếu chéo đối tượng: Phông chữ, tài nguyên hình ảnh của trang đầu tiên có thể rải rác ở các vị trí khác nhau trong tệp, lại sẽ kích hoạt các yêu cầu Range bổ sung
Còn phiền phức hơn, các yêu cầu này khó song song hóa — bởi vì offset của yêu cầu sau, phụ thuộc vào kết quả phân tích mà yêu cầu trước trả về. Đây là một chuỗi tuần tự, độ trễ là cộng dồn.
Thêm vào đó, yêu cầu Range lấy được là byte gốc, máy chủ không thể nén gzip một phần nội dung, hiệu quả truyền tải bản thân nó có giới hạn. Đối với tệp lớn, một lần Range có thể là từ vài chục KB đến vài trăm KB byte gốc.
Kết luận rất rõ ràng: Chỉ dựa vào Range ở phía trình duyệt, không thể đạt được "mở tức thì + nhảy trang bất kỳ" thực sự. Nhiều lần Range tuần tự ở giai đoạn khởi tạo, chính là trần của tốc độ màn hình đầu tiên.
II. Trụ kỹ thuật một: Yêu cầu HTTP Range — chỉ lấy các byte cần thiết
Trước khi nói về giải pháp của StreamPDF, hãy làm rõ vấn đề về yêu cầu Range. Đây là khả năng cơ bản để "không tải xuống toàn bộ tệp".
Yêu cầu Range là gì
Giao thức HTTP cho phép máy khách qua tiêu đề yêu cầu Range, chỉ lấy một đoạn byte của tài nguyên, thay vì toàn bộ tệp:
GET /large.pdf HTTP/1.1
Range: bytes=0-65535
Nếu máy chủ hỗ trợ, sẽ trả về 206 Partial Content, và trong tiêu đề Content-Range sẽ chỉ ra khoảng byte trả về lần này:
HTTP/1.1 206 Partial Content
Content-Range: bytes 0-65535/314572800
Content-Length: 65536
Điều này cho máy khách khả năng "lấy byte theo nhu cầu" — tôi chỉ cần 64KB đầu của tệp, thì không cần kéo toàn bộ 300MB xuống.
Chiến lược song song hai đường của pdf.js
pdf.js sử dụng khả năng của Range rất triệt để. Nó đồng thời duy trì hai kênh dữ liệu:
- Luồng toàn bộ tiến bộ: Tải xuống tuần tự từ đầu tệp, vừa tải vừa phân tích. Kênh này đảm bảo dữ liệu đến theo thứ tự, phù hợp với việc đọc liên tục từ đầu.
- Range theo nhu cầu: Khi trình phân tích gặp byte mà hiện tại chưa tải xuống, sẽ ném ra
MissingDataException, sau đó căn chỉnh về ranh giới chunk 64KB, khởi tạo một yêu cầu Range để bù lại khoảng bị thiếu.
Dữ liệu từ hai kênh cuối cùng đều đổ vào cùng một ChunkedStream, nhờ tập hợp _loadedChunks ghi lại những chunk nào đã đến, tránh tải xuống lặp lại.
Chi tiết mã nguồn phần này có thể tham khảo PDF.js sâu sắc: Luồng mạng và yêu cầu Range, trong đó đã đi qua đầy đủ chuỗi gọi PDFFetchStream → PDFWorkerStream → NetworkPdfManager → ChunkedStreamManager.
Vấn đề vẫn chưa giải quyết: Định vị cấu trúc
Range giải quyết vấn đề "làm thế nào để lấy byte theo nhu cầu", nhưng không giải quyết vấn đề "lấy đoạn byte nào".
Để gửi Range chính xác, phải biết trước offset byte tương ứng của mỗi trang. Cây trang và xref nằm ở cuối tệp — lần mở đầu tiên phải quét cuối tệp trước, bước này bản thân nó là một vòng đi lại mạng bổ sung, quyết định màn hình đầu tiên không thể thực sự nhanh.
Nói cách khác, Range là "đạn dược", nhưng bạn còn cần một "bản đồ" mới biết bắn vào đâu.
III. Trụ kỹ thuật hai: StreamPDF đưa cấu trúc tệp lên trước phía máy chủ
Ý tưởng cốt lõi của StreamPDF, chính là đưa việc "vẽ bản đồ" này lên trước và hoàn thành ở phía máy chủ.
Phân tích trước phía máy chủ sau khi tải lên
Sau khi người dùng tải PDF lên StreamPDF, tệp được truyền trực tiếp đến kho đối tượng R2, byte không đi qua máy chủ ứng dụng. Sau đó Modal nền sẽ thực hiện một lần phân tích trước cho PDF này:
- Phân tích xref, xây dựng ánh xạ từ số hiệu đối tượng đến offset byte
- Duyệt cây trang, trích xuất tham chiếu đối tượng và khoảng byte của mỗi trang
- Thu thập siêu dữ liệu cần thiết cho việc vẽ (kích thước trang, tham chiếu tài nguyên, v.v.)
Sau khi phân tích hoàn thành, các "sản phẩm cấu trúc" này sẽ được ghi trở lại R2, cùng tồn tại với tệp PDF gốc. Nói cách khác, tệp tải lên một lần, cấu trúc sẽ được "vẽ xong" vĩnh viễn.
Trình đọc trực tiếp lấy được cấu trúc khi mở
Khi người dùng mở PDF này trong trình duyệt, cái mà trình đọc lấy được đầu tiên không phải tệp gốc, mà là dữ liệu cấu trúc đã được phân tích trước phía máy chủ.
Dữ liệu cấu trúc này có dung lượng nhỏ (thường chỉ vài chục KB), nhưng nó trực tiếp đưa ra ánh xạ "trang thứ N → offset byte". Sau khi lấy được nó, trình đọc lập tức biết trang đầu tiên ở vị trí nào, trang thứ 1200 ở vị trí nào, hoàn toàn không cần quét toàn bộ tệp, cũng không cần yêu cầu xref ở cuối.
Cấu trúc + Range = Mở tức thì bất kỳ trang nào
Với bản đồ (dữ liệu cấu trúc) và đạn dược (yêu cầu Range), trải nghiệm sẽ trở thành:
- Màn hình đầu tiên: Chỉ kéo khoảng byte mà trang đầu tiên nằm trong đó, khoảng 1 giây là có thể vẽ ra
- Nhảy trang: Muốn xem trang thứ 1200, trực tiếp gửi một Range theo offset, phản hồi tức thì, không tồn tại "càng về sau càng chậm"
- Cuộn: Các trang ngoài vùng nhìn thấy được tải theo nhu cầu, không tải trước hàng trăm MB
Đây chính là lý do StreamPDF có thể làm được việc "mở PDF lớn trực tuyến tức thì" — đưa việc "quét cấu trúc" tốn thời gian nhất ở phía trình duyệt lên trước phía máy chủ, trình duyệt chỉ chịu trách nhiệm "lấy cấu trúc + lấy byte + vẽ".
IV. Chi tiết kỹ thuật ở cấp độ trải nghiệm
Nguyên lý kỹ thuật đã nói xong, đi vào trải nghiệm, còn có vài chi tiết đáng nói.
Màn hình đầu tiên tức thì (Time to First Screen)
StreamPDF tối ưu hóa thời gian màn hình đầu tiên làm chỉ số cốt lõi. Vì dữ liệu cấu trúc cực nhỏ, màn hình đầu tiên thực tế chỉ lấy khoảng byte của trang đầu tiên — thường là từ vài trăm KB đến vài MB, chứ không phải toàn bộ tệp.
So với cách "phải tải xong toàn bộ tệp mới có thể vẽ" của trình đọc gốc, thời gian màn hình đầu tiên của StreamPDF cơ bản không liên quan đến tổng kích thước tệp, chỉ liên quan đến độ phức tạp của trang đầu tiên. Ở khu vực benchmark trên trang chủ, bạn có thể xem bộ đếm thời gian màn hình đầu tiên (Time to First Screen) theo thời gian thực, PDF hơn 400MB cũng có thể xuất hiện màn hình đầu tiên trong khoảng 1 giây.
Nhảy tức thì đến bất kỳ số trang nào
Vì ánh xạ từ số trang đến offset byte đã được tính toán sẵn ở phía máy chủ, nhảy đến bất kỳ trang nào đều là một truy vấn thời gian hằng số + một yêu cầu Range.
Nhiều trình đọc sẽ rõ ràng chậm lại khi nhảy đến trang ở phía sau, vì chúng cần phân tích tuần tự các nút cây trang phía trước. StreamPDF không có vấn đề này — độ trễ nhảy của trang 1 và trang 1000 gần như giống nhau.
Chỉ tải xuống các trang đang nhìn thấy
Trong quá trình duyệt, trình đọc chỉ yêu cầu byte của các trang trong vùng nhìn thấy hiện tại. Bạn cuộn xuống, nó mới tải nội dung phía sau theo nhu cầu; bạn dừng ở một trang nào đó, nó sẽ không lén lút tải xong hàng trăm MB còn lại ở nền.
Điều này rất thân thiện với bộ nhớ và băng thông, cũng là chìa khóa để trên điện thoại không nóng máy, không chạy hết lưu lượng.
Tăng tốc cạnh CDN
Tất cả yêu cầu byte đều đi qua CDN (cdn-stream-pdf.streampdf.com) quay nguồn R2. Các nút cạnh sẽ cache khoảng byte của các trang phổ biến, khi truy cập lại cùng một trang thì gần như độ trễ bằng không.
V. Thảo luận mở rộng (Chủ đề mở)
Các chủ đề sau đây không đưa ra đáp án chuẩn, mời bạn để lại bình luận trao đổi.
Biên giới của việc phân tích trước phía máy chủ ở đâu?
Tiền đề của việc phân tích trước phía máy chủ là "có thể phân tích". Vậy thì:
- PDF chứa biểu mẫu động (AcroForm / XFA), cấu trúc tĩnh được phân tích trước có đủ để hỗ trợ tương tác không? Trạng thái trường biểu mẫu được đồng bộ như thế nào dưới tiền đề "không tải xuống toàn bộ tệp"?
- PDF có số trang cực lớn (vài chục nghìn trang), bản thân sản phẩm phân tích trước có trở thành điểm nghẽn mới không? Dung lượng và hiệu quả truy vấn của dữ liệu cấu trúc được kiểm soát như thế nào?
- PDF đã được tuyến tính hóa (Linearized) vốn đã được tối ưu hóa cho "màn hình đầu tiên nhanh", việc phân tích trước phía máy chủ còn có lợi ích bao nhiêu đối với nó?
Giải pháp thuần phía máy khách còn có tương lai không?
StreamPDF đi theo đường "đưa cấu trúc lên trước phía máy chủ", nhưng giải pháp thuần phía máy khách không phải không có ý nghĩa:
- Nếu trong tương lai trình duyệt gốc hỗ trợ "chỉ mục cấu trúc PDF" (tương tự tài liệu nav của EPUB), nhúng thông tin cấu trúc vào đầu tệp, thì còn cần phân tích trước phía máy chủ không?
- Luồng toàn bộ tiến bộ + Range của pdf.js đã rất mạnh, đối với trường hợp "chỉ xem vài trang đầu rồi đóng", giải pháp thuần phía máy khách có phải đã đủ dùng không? Trường hợp nào thì giải pháp phía máy chủ vẫn không thể thay thế?
Đánh đổi riêng tư của "trực tuyến không tải xuống"
Tệp tồn tại trên đám mây, tự nhiên mang lại vấn đề riêng tư và tuân thủ. Điều này dẫn đến một vài hướng đáng thảo luận:
- Có thể làm được giải pháp kết hợp "cấu trúc ở phía máy chủ, byte ở phía máy khách" không? Tức là máy chủ chỉ lưu chỉ mục cấu trúc, tệp gốc vẫn lưu trên máy tính người dùng hoặc lưu trữ riêng.
- PDF lớn trong nội bộ doanh nghiệp, thường không thể đặt lên đám mây công cộng. Làm sao để đạt được trải nghiệm mở tức thì cấp phía máy chủ dưới tiền đề "không đặt lên đám mây công cộng"?
VI. Trường hợp phù hợp
Nói nhiều thế này, StreamPDF phù hợp với ai nhất?
- Người thường xuyên nhận PDF lớn: Quy phạm kỹ thuật, hợp đồng pháp luật, sổ tay sản phẩm, tuyển tập bài báo học thuật, không cần tải xuống toàn bộ tệp chỉ để xem vài trang
- Người không muốn chiếm dung lượng lưu trữ cục bộ: Tệp tồn tại trên đám mây, mở trực tuyến bất cứ lúc nào, xem xong đi ngay, không cần dọn dẹp
- Người dùng điện thoại: Không chạy hết lưu lượng, không chiếm dung lượng, không nóng máy, PDF lớn cũng có thể xem mượt mà trên điện thoại
- Người cần chia sẻ PDF lớn: Gửi một liên kết, đối phương mở là có thể đọc, không cần bắt đối phương tải xuống hàng trăm MB
VII. Trải nghiệm ngay bây giờ
Nói nhiều thế này, thì hãy tự mình thử:
- Mở Trang chủ StreamPDF
- Tải lên một PDF lớn, hoặc trực tiếp dán một liên kết PDF
- Sau vài giây xử lý hoàn thành, mở tức thì trực tuyến, lật trang tùy ý
- Thời gian màn hình đầu tiên nhìn thấy theo thời gian thực, nhảy đến bất kỳ trang nào cũng phản hồi tức thì
Lời kết
Bản chất của "không tải xuống", thực ra là chỉ lấy các byte cần thiết.
Để làm được điều này, cần hai trụ: HTTP Range cung cấp khả năng lấy byte theo nhu cầu, đưa cấu trúc lên trước phía máy chủ để trình duyệt bỏ qua việc quét, định vị chính xác mỗi trang. Khi hai điều này kết hợp, PDF hàng trăm MB cũng có thể mở xem tức thì như trang web.
Nếu bạn cũng đã chán ngán vòng lặp "tải xuống → chờ đợi → dọn dẹp", bây giờ hãy vào streampdf.com thử xem PDF lớn của bạn nhé.
Về tôi: Người tạo ra StreamPDF, tập trung vào nghiên cứu và phát triển trong lĩnh vực AI và PDF.