
PDF.js 源码解读: 网络流
2026年10月27日 · StreamPDF Team
前言
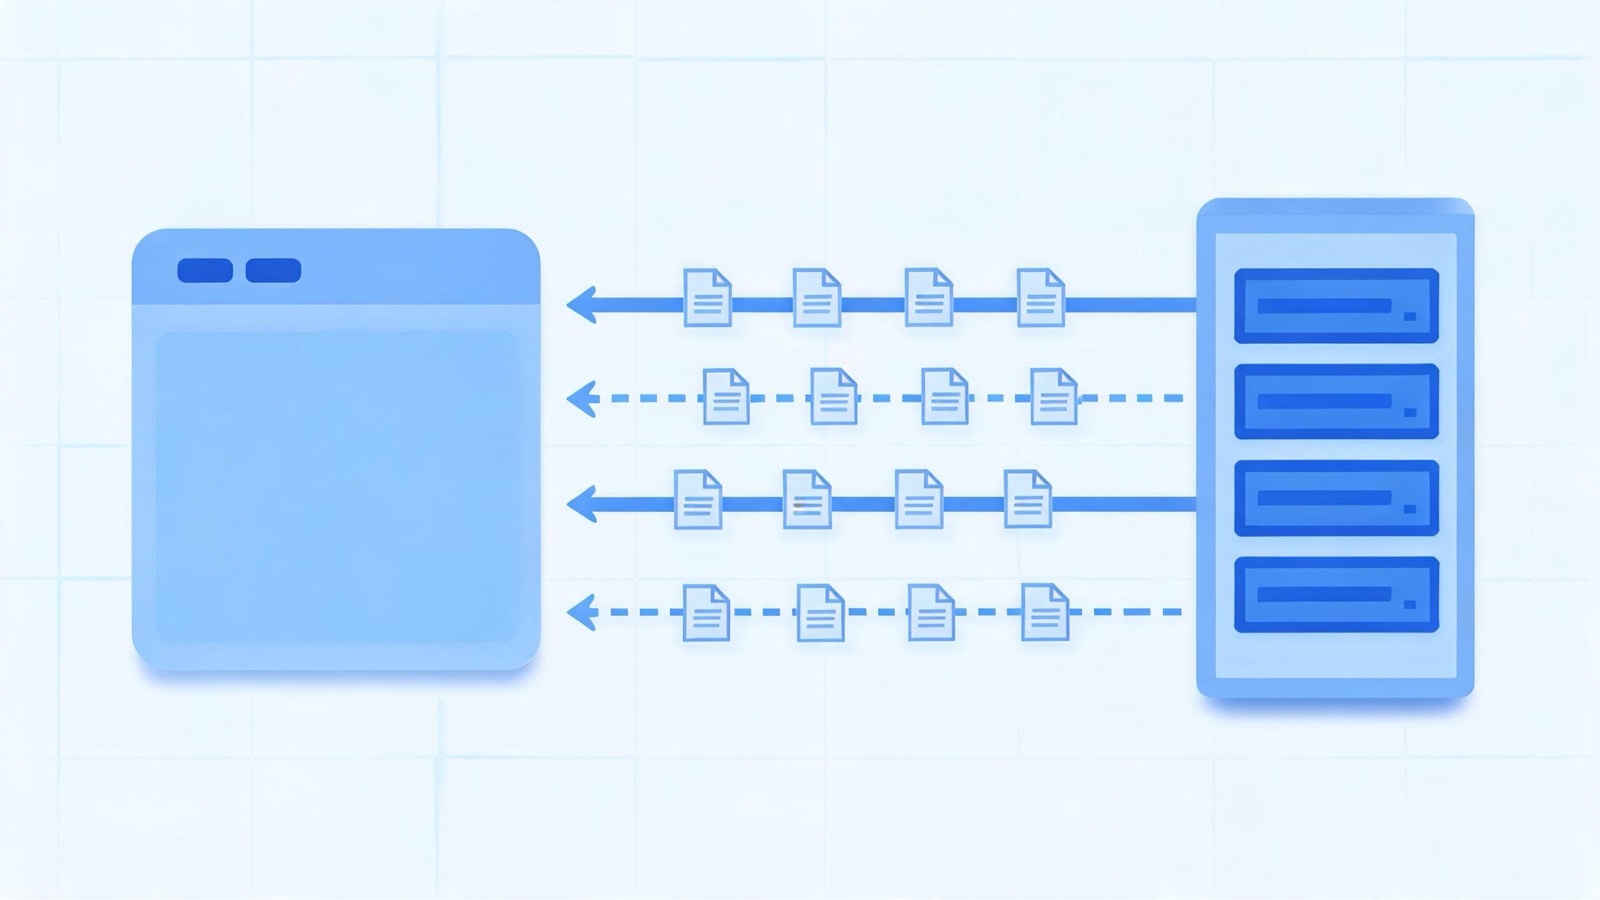
这是 PDF.js 源码解读系列中关于「数据供给层」的一篇,一次覆盖七个文件:
src/shared/base_pdf_stream.js(约 240 行)——三个抽象基类src/display/network_stream.js(约 30 行)——实现选择器src/display/fetch_stream.js(约 150 行)——fetch 实现src/display/network.js(约 385 行)——XMLHttpRequest 回退实现src/display/node_stream.js(约 142 行)——Node.js 的 file:// 实现src/display/transport_stream.js(约 230 行)——用户推送实现src/display/network_utils.js(约 133 行)——公共校验工具
七个文件合起来不足 1200 行,却是 worker 线程全部 PDF 字节的唯一来源。MessageHandler 篇末尾说过「GetReader / GetRangeReader 消息跑在 stream 通道上,网络流是它们的下一篇」——本篇就是那一篇。
前序文章的伏笔在这里汇合:
- api.js 篇的「网络流三分支」(
data/range/url)决定了用不用这组文件、用哪个实现; - demo 系列第 2 篇埋下的
rangeChunkSize = 64KB伏笔,本篇揭晓它在哪里生效; - MessageHandler 篇的
sendWithStream通道,是这组文件把字节送往 worker 的传送带。
一句话概括这组文件的职责:把「PDF 字节从哪来」抽象成两类 reader(全量 / range),主线程按环境选择 fetch、XHR、Node fs、用户推送四种实现之一,worker 通过 GetReader / GetRangeReader 流消息按需拉动。
模块总览
| 文件 | 导出 | 职责 |
|---|---|---|
base_pdf_stream.js | BasePDFStream 等三个基类 | reader 契约:全量 reader 唯一、range reader 可多个 |
network_stream.js | getNetworkStream | 按 URL 协议与运行环境挑选实现类 |
fetch_stream.js | PDFFetchStream | 现代浏览器默认路径:fetch + ReadableStream |
network.js | PDFNetworkStream | 旧环境回退:XMLHttpRequest |
node_stream.js | PDFNodeStream | Node.js 的 file:// 本地文件 |
transport_stream.js | PDFDataTransportStream | 推模式:用户继承 PDFDataRangeTransport 自己喂数据 |
network_utils.js | 七个工具函数 | range 能力校验、响应头解析、origin 校验 |
四种实现与底层 API 的对应关系:
| 实现 | 底层 | 字节来源 |
|---|---|---|
PDFFetchStream | fetch + response.body.getReader() | http(s) 服务器 |
PDFNetworkStream | XMLHttpRequest(arraybuffer) | http(s)/file/ftp 等 |
PDFNodeStream | fs.createReadStream → Web Stream | 本地文件系统 |
PDFDataTransportStream | 无——用户代码调用 onDataRange 等方法推入 | 任意(自定义协议、解密、拼接……) |
四个类都继承 BasePDFStream,结构完全同构:一个 stream 类带两个 reader 类(全量 + range)。看懂一个,另外三个只看差异。
基类:三层契约
base_pdf_stream.js 定义了整个子系统的接口面。
BasePDFStream:reader 的登记处
class BasePDFStream {
  _fullReader = null;
  _rangeReaders = new Set();

  getFullReader() {
    assert(!this._fullReader, "... can only be called once.");
    return (this._fullReader = new this.#PDFStreamReader(this));
  }

  getRangeReader(begin, end) {
    if (end <= this._progressiveDataLength) {
      return null; // 全量 reader 已经读过这段,不再发 range 请求
    }
    const reader = new this.#PDFStreamRangeReader(this, begin, end);
    this._rangeReaders.add(reader);
    return reader;
  }
}
两个值得记住的决策:
- 全量 reader 全局唯一,重复索取直接 assert 失败。整个系统里只有一个「从头读到尾」的字节流。
getRangeReader可能返回null。_progressiveDataLength是全量 reader 已加载的字节数——要的范围整段落在已加载区间内时,数据会随全量流自然送达,发 range 请求纯属浪费。调用方(api.js 的GetRangeReader处理器)必须处理这个 null。
BasePDFStreamReader:面向 worker 的能力声明
class BasePDFStreamReader {
  onProgress = null;
  _contentLength = 0;
  _headersCapability = Promise.withResolvers();
  _isRangeSupported = false;
  _isStreamingSupported = false;
  _loaded = 0;

  get headersReady() { return this._headersCapability.promise; }
  get contentLength() { return this._contentLength; }
  get isRangeSupported() { return this._isRangeSupported; }
  get isStreamingSupported() { return this._isStreamingSupported; }

  async read() { unreachable("Abstract method `read` called"); }
  cancel(reason) { unreachable("Abstract method `cancel` called"); }
}
接口形状对齐 WHATWG ReadableStream 的 reader:read() 返回 Promise<{ value, done }>。这个对齐不是巧合——WorkerTransport 的 sink.onPull 回调(见下文「与 worker 的接线」)按 ReadableStream 的拉模式工作,reader 契约与之严丝合缝,四种实现可以任意替换。
headersReady 是这个子系统里最重要的 promise:worker 在发任何 range 请求前,必须先等它就绪,拿到 contentLength / isRangeSupported / isStreamingSupported 三个能力值。能力不由用户参数直接决定,而由响应头探测出来——这是本篇反复出现的主题。
BasePDFStreamRangeReader:刻意留白
range reader 基类只有 read() / cancel() 两个抽象方法,连 begin/end 都不存(构造参数原样传给 super 后丢弃)。各实现按需自理:fetch 版不记、transport 版要拿 _begin 找回对应的 reader。
选择器:network_stream.js
function getNetworkStream(url) {
  return isValidFetchUrl(url)
    ? PDFFetchStream
    : typeof PDFJSDev !== "undefined" && PDFJSDev.test("GENERIC") && isNodeJS
      ? PDFNodeStream
      : PDFNetworkStream;
}
三层嵌套三元,优先级即顺序:
- URL 协议是 http(s)(
isValidFetchUrl只查协议)→PDFFetchStream。fetch 是现代浏览器的默认路径; - 否则,GENERIC 构建且跑在 Node.js →
PDFNodeStream。覆盖 Node 下file://读本地文件的场景; - 其余 →
PDFNetworkStream(XHR)。包括浏览器里的file://、ftp://,以及 fetch 不可用的旧环境。
注意这是能力检测而非配置开关:用户没有任何参数能强制选择某个实现。另外 fetch_stream.js、network.js、node_stream.js 三个文件开头都有 MOZCENTRAL 守卫——Firefox 内置 viewer 走浏览器自己的网络通道,这三个模块在 MOZCENTRAL 构建下直接抛错。
fetch 实现:fetch_stream.js
构造即发请求,then 链里做全部决策
PDFFetchStream 本身几乎无逻辑:断言 URL 是 http(s)、用 createHeaders 合并用户 httpHeaders。真正的动作在全量 reader 的构造函数里:
class PDFFetchStreamReader extends BasePDFStreamReader {
  _abortController = new AbortController();
  _reader = null;

  constructor(stream) {
    super(stream);
    const { disableRange, disableStream, rangeChunkSize, url, withCredentials } =
      stream._source;

    this._isStreamingSupported = !disableStream;
    const headers = new Headers(stream.headers); // 永远复制一份

    fetchUrl(url, headers, withCredentials, this._abortController)
      .then(response => {
        stream._responseOrigin = getResponseOrigin(response.url);
        ensureResponseStatus(response.status, url); // 只接受 200 / 206
        this._reader = response.body.getReader();

        const { contentLength, isRangeSupported } =
          validateRangeRequestCapabilities({
            responseHeaders: response.headers,
            isHttp: true, rangeChunkSize, disableRange,
          });
        this._contentLength = contentLength;
        this._isRangeSupported = isRangeSupported;
        this._filename = extractFilenameFromHeader(response.headers);

        // 流式被禁用且支持 range:中止全量请求,之后全部走 range
        if (!this._isStreamingSupported && this._isRangeSupported) {
          this.cancel(new AbortException("Streaming is disabled."));
        }
        this._headersCapability.resolve();
      })
      .catch(this._headersCapability.reject);
  }
}
then 链里的七步顺序有讲究:
- 先记
_responseOrigin——response.url是重定向后的最终 URL,后续 range 响应的 origin 要与它比对(下文详述); - 状态码只认 200 / 206,其余直接
createResponseError; - 拿到
response.body的 reader——流式读取的物理基础; validateRangeRequestCapabilities探测 range 能力(下一节细拆);- 从
Content-Disposition提取文件名(下载时用); - 中止决策:流式被禁用且支持 range 时,当场
cancel全量请求。disableStream: true的语义不是「不建全量流」,而是「建了就扔」——因为不发这个请求就拿不到响应头,无法探测能力; - 最后才 resolve
headersCapability,此时三个能力值全部就位。
read 与 cancel
async read() {
  await this._headersCapability.promise;
  const { value, done } = await this._reader.read();
  if (done) return { value, done };
  this._loaded += value.byteLength;
  this._callOnProgress();
  return { value: getArrayBuffer(value), done: false };
}

cancel(reason) {
  this._reader?.cancel(reason);
  this._abortController.abort();
}
read() 先等 headers 就绪——响应头没到手之前读不到任何字节,这是 fetch 的自然时序,capability 只是把它显式化。_loaded 只在全量 reader 上累计:进度汇报是全量流的专属语义,range reader 不记进度(按需拉取的字节对「整体进度」没有线性意义)。
cancel 双管齐下:reader.cancel() 停读流,abortController.abort() 断网络。两者幂等,重复调用无副作用。
range reader:一个 Range 头 + 一次 origin 校验
class PDFFetchStreamRangeReader extends BasePDFStreamRangeReader {
  _readCapability = Promise.withResolvers();

  constructor(stream, begin, end) {
    super(stream, begin, end);
    const headers = new Headers(stream.headers);
    headers.append("Range", `bytes=${begin}-${end - 1}`);

    fetchUrl(url, headers, withCredentials, this._abortController)
      .then(response => {
        const responseOrigin = getResponseOrigin(response.url);
        ensureResponseOrigin(responseOrigin, stream._responseOrigin);
        ensureResponseStatus(response.status, url);
        this._reader = response.body.getReader();
        this._readCapability.resolve();
      })
      .catch(this._readCapability.reject);
  }
}
两个细节:
end - 1:PDF.js 内部的 range 语义是左闭右开[begin, end),HTTP Range 头是闭区间bytes=begin-end,转换点就在这里。ensureResponseOrigin:range 响应的最终 origin 必须等于全量响应记录下的_responseOrigin。服务器或 CDN 把 range 请求重定向到另一个源时,字节偏移的语义可能完全对不上(不同源的回源策略、压缩差异),与其解析出错乱数据,不如当场抛错。
还有一个不对称值得一提:PDFNetworkStream(XHR 版)和 PDFDataTransportStream(推模式版)的 range reader 用完会回调把自己从 stream._rangeReaders 里删掉;fetch 版没有这个回调,已完成的 range reader 留在 Set 里,直到 cancelAllRequests 统一清理。条目只有 reader 对象本身(chunk 数据不在上面),代价有界,属于实现取舍而非缺陷。
公共校验:network_utils.js 的四道闸门
validateRangeRequestCapabilities 是整个子系统的「range 开关总闸」,fetch 版与 XHR 版共用:
function validateRangeRequestCapabilities({
  responseHeaders, isHttp, rangeChunkSize, disableRange,
}) {
  const rv = { contentLength: 0, isRangeSupported: false };

  const length = parseInt(responseHeaders.get("Content-Length"), 10);
  if (!Number.isInteger(length)) return rv;          // 闸门 1
  rv.contentLength = length;

  if (length <= 2 * rangeChunkSize) return rv;       // 闸门 2
  if (disableRange || !isHttp) return rv;            // 闸门 3
  if (responseHeaders.get("Accept-Ranges") !== "bytes") return rv; // 闸门 4

  const contentEncoding = responseHeaders.get("Content-Encoding") || "identity";
  if (contentEncoding === "identity") {
    rv.isRangeSupported = true;                      // 闸门 5
  }
  return rv;
}
五道闸门顺序通过才置 isRangeSupported = true:
Content-Length必须是整数。长度未知就无法规划 range;- 文件必须大于两个 chunk(
2 * rangeChunkSize,默认 128KB)。demo 系列第 2 篇的 64KB 伏笔在这里生效——小文件中止全量请求、改发 range 的代价比直接读完还大,不如不折腾; - 用户没禁 range 且确属 http(s)。
disableRange在这里且仅在这里行使否决权; - 服务器声明
Accept-Ranges: bytes; Content-Encoding必须是 identity。gzip/br 压缩后,响应字节的偏移与 PDF 原始字节偏移不再对应,range 请求切出来的块毫无意义。
注意返回值的分层:contentLength 在闸门 1 通过后就有了(即使 range 不支持,进度条还需要它);isRangeSupported 要过全部五道。
文件里另外六个工具各管一件事:createHeaders(非 http 丢弃用户头)、getResponseOrigin(URL.parse(url)?.origin ?? null,注意 null 与 "null" 字符串不同——file: URL 的 origin 是字符串 "null")、ensureResponseOrigin、extractFilenameFromHeader(Content-Disposition → 百分号解码 → isPdfFile 过滤)、createResponseError(404 或 file: 的 status 0 标记 missing = true,触发 viewer 的「文件不存在」UI 而非通用错误)、trimHeadersEnd(反向扫描去尾部空白——注释明说不让 $ 锚定正则把复杂度搞成二次方)。
XHR 回退:network.js
XHR 不支持流式读取(responseType = "arraybuffer" 的字节在 readyState === 4 时整包到达),这决定了 PDFNetworkStream 与 fetch 版的所有差异。
_request:状态机藏在回调里
_request(args) {
  const xhr = new XMLHttpRequest();
  const pendingRequest = {
    validateStatus: null,
    onHeadersReceived: args.onHeadersReceived,
    onDone: args.onDone, onError: args.onError, onProgress: args.onProgress,
  };
  this.#pendingRequests.set(xhr, pendingRequest); // WeakMap

  xhr.open("GET", this.url);
  xhr.withCredentials = this._source.withCredentials;
  for (const [key, val] of this.headers) xhr.setRequestHeader(key, val);
  if (this.isHttp && "begin" in args && "end" in args) {
    xhr.setRequestHeader("Range", `bytes=${args.begin}-${args.end - 1}`);
    // RFC 2616: "A server MAY ignore the Range header"——可能收到 200 而非 206
    pendingRequest.validateStatus = status =>
      status === PARTIAL_CONTENT_RESPONSE || status === OK_RESPONSE;
  } else {
    pendingRequest.validateStatus = status => status === OK_RESPONSE;
  }
  xhr.responseType = "arraybuffer";
  // ...
}
与 fetch 版的一个关键差异:range 请求容忍 200。服务器可以合法地无视 Range 头返回整份文件,此时拿到的全量数据同样是有效结果(reader 会把它当一个 chunk 交出去)。fetch 版的 ensureResponseStatus 也接受 200/206 两个码,逻辑上对齐。
#onStateChange 里两个时点:
readyState >= 2(HEADERS_RECEIVED)→ 触发一次onHeadersReceived(触发后即从 pendingRequest 删除,防止 state 3 再触发一次);readyState === 4(DONE)→ 校验状态码;206 还要再验Content-Range头格式(/bytes \d+-\d+\/\d+/),格式不对按出错处理——状态码会撒谎的情况少见,但代理服务器改写响应的情况不少见。
全量 reader:到手即弃
#onHeadersReceived() {
  // ... 手动把 getAllResponseHeaders() 的字符串解析成 Headers 对象
  const { contentLength, isRangeSupported } = validateRangeRequestCapabilities({ ... });
  this._contentLength = contentLength;
  this._isRangeSupported = isRangeSupported;

  if (this._isRangeSupported) {
    // 注释:对"只允许请求一次"的服务器这会出问题——
    // 但那种服务器本来就不该声明支持 range
    stream._abortRequest(fullRequestXhr);
  }
  this._headersCapability.resolve();
}
XHR 版的中止决策与 fetch 版不同:只要支持 range 就无条件中止全量请求。原因简单——XHR 没有流式,disableStream 的区分对它无意义,留着全量请求只会把整份文件再下载一遍。
中止后 read() 靠什么返回数据?capability 队列模式:
async read() {
  await this._headersCapability.promise;
  if (this._storedError) throw this._storedError;
  if (this._cachedChunks.length > 0) {
    return { value: this._cachedChunks.shift(), done: false };
  }
  if (this._done) return { value: undefined, done: true };
  const capability = Promise.withResolvers();
  this._requests.push(capability);
  return capability.promise;
}
_cachedChunks 与 _requests 互补:数据先于 read() 到达则入缓存,read() 先于数据到达则挂 promise。这套「谁先到谁等」的双缓冲模式在 transport_stream.js 里还会再见一次。
range reader:用完即删
XHR 版的 range reader 带一个 onClosed 回调,PDFNetworkStream.getRangeReader 覆写基类方法挂上它:
getRangeReader(begin, end) {
  const reader = super.getRangeReader(begin, end);
  if (reader) {
    reader.onClosed = () => this._rangeReaders.delete(reader);
  }
  return reader;
}
#onDone 与 cancel 都会触发 onClosed——range reader 生命周期结束即从 _rangeReaders 摘除,让 cancelAllRequests 的遍历集合保持干净。
推模式:transport_stream.js
用户继承 PDFDataRangeTransport(api.js 篇已介绍过这个抽象类)自己控制数据供给时,PDFDataTransportStream 负责把「用户推过来的 chunk」适配成标准的 reader 契约。
数据入口:一个 listener 三类消息
const listener = args => {
  switch (args.type) {
    case "range":
    case "progressiveRead":
      this.#onReceiveData(args.begin, args.chunk);
      break;
    case "progressiveDone":
      this._fullReader?.progressiveDone();
      this._progressiveDone = true;
      break;
  }
};
pdfDataRangeTransport.transportReady(listener);
#onReceiveData 按 begin 有无分流:
#onReceiveData(begin, chunk) {
  const buffer = getArrayBuffer(chunk);
  if (begin === undefined) {
    // 渐进数据:给全量 reader(还没建就先排队在 stream 上)
    if (this._fullReader) this._fullReader._enqueue(buffer);
    else this._queuedChunks.push(buffer);
  } else {
    // range 数据:按 begin 找到对应的 range reader
    const rangeReader = this._rangeReaders.keys().find(r => r._begin === begin);
    assert(rangeReader, "...");
    rangeReader._enqueue(buffer);
  }
}
与 fetch/XHR 的拉模式相反,这里是推模式:reader 不发起任何请求,数据由用户那边的事件驱动送达。所以 range reader 的创建伴随着一次主动通知:
getRangeReader(begin, end) {
  const reader = super.getRangeReader(begin, end);
  if (reader) {
    reader.onDone = () => this._rangeReaders.delete(reader);
    this._source.pdfDataRangeTransport.requestDataRange(begin, end); // 通知子类去拉
  }
  return reader;
}
「建 reader」与「通知用户拉这段数据」是同一个动作的两面。
全量 reader:能力由声明而来
this._contentLength = length;                          // 来自 transport 构造参数
this._isStreamingSupported = !disableStream;
this._isRangeSupported = !disableRange;对比网络实现就能看出本质差异:推模式下能力完全由用户参数声明,没有响应头可探测——因为根本没有「响应」。_headersCapability 同步 resolve,headersReady 不等任何异步事件。
还有个小时序处理:构造时若有 initialData,_loaded 已经非零,但用户还没来得及注册 onProgress。代码用 Promise.resolve().then(...) 推迟一个微任务再补报一次进度——只补「这期间没有新数据入队」的情况(_loaded === loaded),避免重复汇报。
range reader:单发即完成
_enqueue(chunk) {
  if (this._done) return;
  if (this._requests.length === 0) {
    this._queuedChunk = chunk;
  } else {
    const capability = this._requests.shift();
    capability.resolve({ value: chunk, done: false });
    this.#endRequests(); // 其余挂起的 read 全部以 done:true 了结
  }
  this._done = true;
  this.onDone?.();
}
推模式的 range reader 是单发的:requestDataRange(begin, end) 对应一次 onDataRange(begin, chunk),一个 chunk 到达即 _done = true,reader 随即从 stream 的集合里删除。fetch/XHR 版的 range reader 可以反复 read() 直到流尽(服务器可能把 206 响应分多帧送),推模式没这个概念——用户给的就是整段。
getArrayBuffer 也比网络版严格:只接受「完全利用底层 buffer」的 Uint8Array,否则复制一份。这些字节稍后要以 Transferable 跨线程转移,带偏移量的视图会在转移时带上无关内存。
与 worker 的接线:GetReader / GetRangeReader
reader 契约的最终消费者在 api.js 的 WorkerTransport.setupMessageHandler 里——两条流消息把上述全部机制接到 worker 上:
messageHandler.on("GetReader", (data, sink) => {
  this.#fullReader = this.#networkStream.getFullReader();
  this.#fullReader.onProgress = evt => this.#onProgress(evt);

  sink.onPull = () => {
    this.#fullReader.read().then(({ value, done }) => {
      if (done) { sink.close(); return; }
      sink.enqueue(new Uint8Array(value), 1, [value]); // ArrayBuffer 转移给 worker
    });
  };
  sink.onCancel = reason => this.#fullReader.cancel(reason);
});

messageHandler.on("GetRangeReader", (data, sink) => {
  const rangeReader = this.#networkStream.getRangeReader(data.begin, data.end);
  if (!rangeReader) {
    sink.close(); // 数据已在全量流里,直接关流,worker 等全量流送达
    return;
  }
  // onPull / onCancel 与 GetReader 同构
});
三层机制在这里咬合:
- 拉模式端到端贯通。
sink.onPull只在 worker 侧desiredSize > 0时触发(MessageHandler 篇的背压环),read()再从 fetch 的 ReadableStream 拉——worker 消化多快,网络就读多快,任何一环都不会积压。 - 零拷贝转移。
sink.enqueue(chunk, size, [value])的第三个参数把ArrayBuffer列入 transfer 列表,所有权移交 worker,主线程侧那份随即失效——这也是各实现里getArrayBuffer归一化的原因。 - null reader 的优雅处理。基类判断「这段数据全量流已覆盖」返回 null 时,
sink.close()直接关闭流。worker 收到一个空流,转而从全量流里等这段数据——不发重复请求。
另有 ReaderHeadersReady 消息把三个能力值回给 worker:
messageHandler.on("ReaderHeadersReady", async data => {
  await this.#fullReader.headersReady;
  const { isStreamingSupported, isRangeSupported, contentLength } = this.#fullReader;
  if (isStreamingSupported && isRangeSupported) {
    this.#fullReader.onProgress = null; // range 模式下进度改由别处汇报
  }
  return { isStreamingSupported, isRangeSupported, contentLength };
});
worker 拿到这三个值后决定加载策略:range 支持则按 rangeChunkSize 切片发 GetRangeReader(worker 侧的调度在 src/core/pdf_manager.js,本系列已有专篇);不支持则顺着全量流线性解析。
两个开关 × 能力探测的组合行为
disableStream / disableRange 与用户环境组合后的实际路径:
| disableStream | disableRange | 探测到 range 支持 | 实际行为 |
|---|---|---|---|
| false(默认) | false(默认) | 是 | 全量流继续渐进读 + range 按需并行(fetch 默认路径) |
| false | false | 否 | 全量流一路读完 |
| true | false | 是 | 全量请求发出即中止("Streaming is disabled."),纯 range |
| * | true | 否(被否决) | 一次性整读 |
XHR 实现的语义略简:不支持流式,只要探测到 range 支持就中止全量请求,等价于上表第三行。
总结
这组文件是 PDF.js 的数据供给层:对上(api.js)只暴露「建流、取 reader」两个动作,对下把四种天差地别的字节来源抹平成同一契约。
四种实现能力对照
| 实现 | 底层 | streaming | range | 进度来源 |
|---|---|---|---|---|
PDFFetchStream | fetch ReadableStream | 支持 | Range 头 + 206 | fullReader._loaded 累计 |
PDFNetworkStream | XMLHttpRequest | 不支持(整包到达) | Range 头,容忍 200 | onprogress 事件 |
PDFNodeStream | fs.ReadStream | 支持 | start/end 选项 | fullReader._loaded 累计 |
PDFDataTransportStream | 用户推送 | 由 disableStream 声明 | 由 disableRange 声明 | fullReader._loaded 累计 |
六条设计原则
- 一个契约,四种实现。
read() → Promise<{ value, done }>对齐 ReadableStream reader 接口,WorkerTransport的onPull完全不关心字节来自 fetch、XHR、文件系统还是用户回调。 - 能力探测优于配置。
isRangeSupported由响应头五道闸门算出,disableRange/disableStream只有否决权,没有指定权。 - 中止即优化。确认 range 支持后果断中止全量请求,把带宽让给按需加载——「发一个请求只为读它的响应头」是合理的代价。
- 跨重定向的原点校验。range 响应 origin 必须等于全量响应 origin,防止重定向换源后字节偏移语义错乱。
- 拉模式天然有序,推模式必须排队。网络实现的 reader 主动拉;推模式用
_requests/_queuedChunks双缓冲消化「数据与 read 谁先谁后」的乱序,range reader 单发即完成。 - 背压一路到底。worker 的
desiredSize→sink.onPull→reader.read()→ fetch ReadableStream,读取速度始终被消费速度牵制,内存里不会堆积未消费的字节。
读懂这组文件之后,getDocument({ url }) 到 worker 拿到第一个字节之间的全部路径就闭环了:选择器挑实现 → 全量 reader 探测能力 → worker 按能力值选策略 → GetReader / GetRangeReader 流消息把字节以零拷贝方式泵过去。worker 侧如何按 range 策略调度这些请求,见 core 层的 pdf_manager 篇。
StreamPDF 的设计原则: 能前置处理的绝对不放到解析的时候才做, 由服务端一次解决所有性能问题. 浏览器只获取&渲染必须数据.
相关文章
- PDF.js 从 demo 深入浅出 10: CanvasGraphics 与 operatorList 绘制2026年10月27日
- PDF.js 从 demo 深入浅出 9: 网络流与 Range 请求2026年10月27日
- PDF.js 从 demo 深入浅出 8: PDFWorker.create 与真假 Worker 握手2026年10月27日
- PDF.js 从 demo 深入浅出 7: WorkerTransport 初始化2026年10月27日
- PDF.js 从 demo 深入浅出 6: MessageHandler 跨线程通讯2026年10月27日
- PDF.js 从 demo 深入浅出 5: render 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 4: getViewport 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 3: getPage 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 2: getDocument 方法全貌2026年10月27日
- PDF.js 源码解读: TextLayer2026年10月27日
- PDF.js 源码解读: font_loader2026年10月27日
- PDF.js 源码解读: obj_bin_transform_display2026年10月27日
- PDF.js 源码解读: PDFObjects2026年10月27日
- PDF.js 源码解读: internal_evt.js2026年10月27日
- PDF.js 源码解读: math_clamp.js2026年10月27日
- PDF.js 源码解读: css_utils.js2026年10月27日
- PDF.js 源码解读: scripting_utils2026年10月27日
- PDF.js 源码解读: MurmurHash3_642026年10月27日
- PDF.js 源码解读: obj_bin_transform_utils2026年10月27日
- PDF.js 源码解读: image_utils.js2026年10月27日
- PDF.js 源码解读: BasePDFStream2026年10月27日
- PDF.js 源码解读: 共享工具层2026年10月27日
- PDF.js 源码解读: MessageHandler2026年10月27日
- PDF.js 源码解读: api2026年10月27日
- PDF.js 源码解读: fonts2026年10月27日
- PDF.js 源码解读: glyphlist2026年10月27日
- PDF.js 源码解读: binary_cmap2026年10月27日
- PDF.js 源码解读: cmap2026年10月27日
- PDF.js 源码解读: encodings2026年10月27日
- PDF.js 源码解读: metrics2026年10月27日
- PDF.js 源码解读: standard_fonts2026年10月27日
- PDF.js 源码解读: fonts_utils2026年10月27日
- PDF.js 源码解读: default_appearance2026年10月27日
- PDF.js 源码解读: metadata_parser2026年10月27日
- PDF.js 源码解读: name_number_tree2026年10月27日
- PDF.js 源码解读: struct_tree2026年10月27日
- PDF.js 源码解读: catalog2026年10月27日
- PDF.js 源码解读: pdf_manager2026年10月27日
- PDF.js 源码解读: object_loader2026年10月27日
- PDF.js 源码解读: obj_bin_transform_core2026年10月27日
- PDF.js 源码解读: crypto2026年10月27日
- PDF.js 源码解读: core_utils2026年10月27日
- PDF.js 源码解读: primitives2026年10月27日
- PDF.js 源码解读: worker_stream2026年10月27日
- PDF.js 源码解读: ccitt_stream2026年10月27日
- PDF.js 源码解读: jpx_stream2026年10月27日
- PDF.js 源码解读: jbig2_stream2026年10月27日
- PDF.js 源码解读: jpeg_stream2026年10月27日
- PDF.js 源码解读: decrypt_stream2026年10月27日
- PDF.js 源码解读: brotli_stream2026年10月27日
- PDF.js 源码解读: run_length_stream2026年10月27日
- PDF.js 源码解读: ascii_hex_stream2026年10月27日
- PDF.js 源码解读: ascii_85_stream2026年10月27日
- PDF.js 源码解读: lzw_stream2026年10月27日
- PDF.js 源码解读: predictor_stream2026年10月27日
- PDF.js 源码解读: flate_stream2026年10月27日
- PDF.js 源码解读: decode_stream2026年10月27日
- PDF.js 源码解读: chunked_stream2026年10月27日
- PDF.js 源码解读: stream2026年10月27日
- PDF.js 源码解读: base_stream2026年10月27日
- PDF.js 深入浅出 11: Parser2026年10月26日
- PDF.js 深入浅出 10: XRef2026年10月26日
- PDF.js 深入浅出 9: CanvasGraphics2026年10月26日
- PDF.js 深入浅出 8: Document 与 Page2026年10月26日
- AI 时代, 我们到底应该做什么才能活下去(StreamPDF 创立有感)2026年10月26日
- PDF.js 深入浅出 7: PartialEvaluator2026年10月25日
- PDF.js 深入浅出 6: PDFManager.initDocument2026年10月25日
- PDF.js 深入浅出 5: PDFFetchStream 和 PDFWorkerStream2026年10月25日
- PDF.js 深入浅出 4: MessageHandler2026年10月22日
- PDF.js 深入浅出 3: getViewport & render2026年10月22日
- PDF.js 从 demo 深入浅出 1: 自定义 viewer 渲染 PDF2026年10月19日
- PDF.js 深入浅出 2: getDocument & getPage2026年10月19日
- PDF.js 深入浅出 1: PDF.js 的架构设计2026年10月16日