
PDF.js 源码解读: obj_bin_transform_display
2026年10月27日 · StreamPDF Team
前言
上一篇 core/obj_bin_transform_core.js 讲的是写入端:Worker 如何把字体、图案与字形路径编译成 ArrayBuffer。本篇接着看这些字节到达主线程之后发生了什么,源码是 441 行的 src/display/obj_bin_transform_display.js。
这里不再讨论结构化克隆为什么丢原型,也不重复五个 compile 函数。真正的问题是读取端如何解释同一份字节协议:字符串怎样定位,三态布尔怎样 unpack,可选区段怎样跳过,哪些 getter 返回副本,哪些只返回视图,以及字体程序挂到 DOM 后怎样释放大块数据。
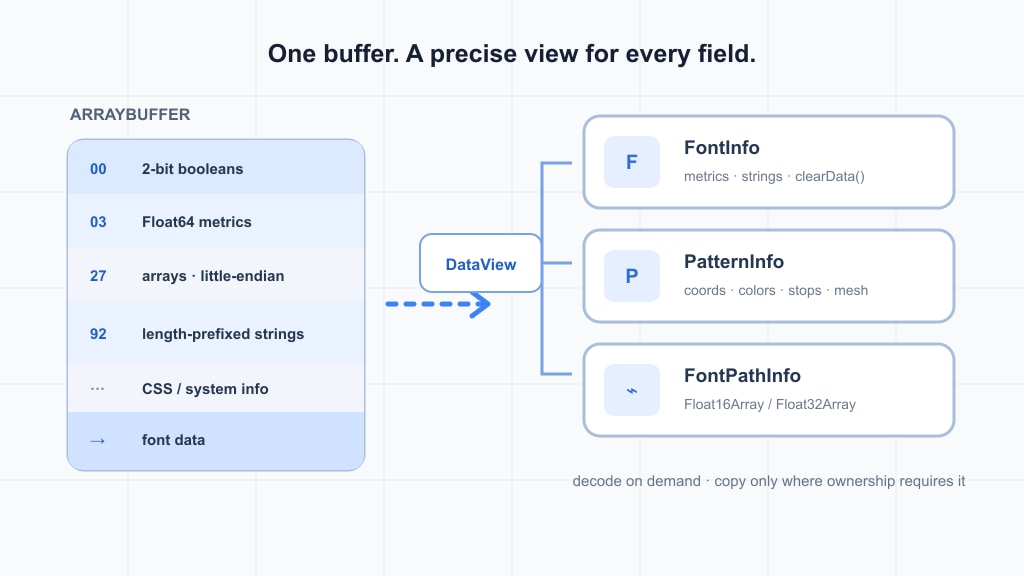
这个文件不是一次性的 deserialize(buffer) -> object。它导出五个轻量包装类,把原始 buffer 留在实例里,再通过 getter 或 getIR() 按需读取。理解它要同时看三个维度:字段布局、读取时机、buffer 所有权。
模块总览
五个导出类并不都在 api.js 中直接实例化。FontInfo、PatternInfo、FontPathInfo 对应三类 commonobj;CssFontInfo 与 SystemFontInfo 则由 FontInfo 的嵌套 info getter 创建。
| 类 | 输入 | 对外结果 | 主要消费方 |
|---|---|---|---|
FontInfo | { buffer, extra } | 字体度量、名称、数据与嵌套 info | FontFaceObject、FontLoader |
CssFontInfo | 独立的 CSS info buffer | fontFamily、fontWeight、italicAngle | 创建 FontFace 或 @font-face |
SystemFontInfo | 独立的系统字体 info buffer | 回退标志、CSS、来源与样式 | FontLoader.loadSystemFont、canvas.js |
PatternInfo | 图案 buffer | 轴向、径向或 Mesh IR 数组 | commonObjs,随后进入绘制路径 |
FontPathInfo | 字形路径 buffer | Float16Array 或 Float32Array 视图 | makePathFromDrawOPS |
共享 schema 仍然来自 src/shared/obj_bin_transform_utils.js。读取端没有另写字段顺序:
class CSS_FONT_INFO {
  static strings = ['fontFamily', 'fontWeight', 'italicAngle'];
}

class SYSTEM_FONT_INFO {
  static strings = ['css', 'loadedName', 'baseFontName', 'src'];
}

class FONT_INFO {
  static bools = [
    'black',
    'bold',
    'disableFontFace',
    'fontExtraProperties',
    'isInvalidPDFjsFont',
    'isType3Font',
    'italic',
    'missingFile',
    'remeasure',
    'vertical',
  ];

  static numbers = ['ascent', 'defaultWidth', 'descent'];
  static strings = ['fallbackName', 'loadedName', 'mimetype', 'name'];

  static OFFSET_NUMBERS = Math.ceil((this.bools.length * 2) / 8);
  static OFFSET_BBOX = this.OFFSET_NUMBERS + this.numbers.length * 8;
  static OFFSET_FONT_MATRIX = this.OFFSET_BBOX + 1 + 2 * 4;
  static OFFSET_DEFAULT_VMETRICS = this.OFFSET_FONT_MATRIX + 1 + 8 * 6;
  static OFFSET_STRINGS = this.OFFSET_DEFAULT_VMETRICS + 1 + 2 * 3;
}
十个布尔占三字节,因此固定段的边界依次是:
| 区段 | 起始偏移 | 长度 | 读取方式 |
|---|---|---|---|
| 布尔 | 0 | 3 | 每字段 2 bit |
三个 Float64 | 3 | 24 | DataView 默认大端 |
bbox | 27 | 9 | 1 字节长度 + 4 个小端 Int16 |
fontMatrix | 36 | 49 | 1 字节长度 + 6 个小端 Float64 |
defaultVMetrics | 85 | 7 | 1 字节长度 + 3 个小端 Int16 |
| 字符串区段 | 92 | 可变 | 总长度后接四条长度前缀字符串 |
InfoUtils.decoder 本身通过 shadow 缓存一个 TextDecoder,但这不等于属性值有缓存。下面会看到,字符串 getter 每次都重新扫描并调用这个共享 decoder。
方法级源码块与分析
commonobj:三条二进制分支,三种交付粒度
api.js 收到消息后,Font 分支保留 FontInfo 包装器,Pattern 分支立即还原 IR,FontPath 分支则把路径包装器放进 commonObjs:
case "Font":
  const fontData = new FontInfo(exportedData);
  const font = new FontFaceObject(
    fontData,
    inspectFont,
    exportedData.charProcOperatorList,
    exportedData.extra
  );

  this.fontLoader
    .bind(font)
    .catch(() => messageHandler.sendWithPromise("FontFallback", { id }))
    .finally(() => {
      if (!font.fontExtraProperties) {
        font.clearData();
      }
      this.commonObjs.resolve(id, font);
    });
  break;
case "FontPath":
  this.commonObjs.resolve(id, new FontPathInfo(exportedData));
  break;
case "Pattern":
  const pattern = new PatternInfo(exportedData);
  this.commonObjs.resolve(id, pattern.getIR());
  break;
Font.exportData() 送来的 exportedData 不是裸 buffer,而是包含 buffer、charProcOperatorList 与 extra 的对象。后两者没有编入二进制;FontInfo 构造函数只解构 buffer 和 extra,api.js 再把另外两个值交给 FontFaceObject。
fontLoader.bind(font) 无论成功还是进入 fallback,都会走到 finally。只要没有开启 fontExtraProperties,就调用 clearData(),避免嵌入字体程序在已经完成加载尝试后继续占用内存。调试所需的额外属性开启时则保留数据。
FontFaceObject 是稳定的外层对象,它把大多数属性访问转发给 #fontData。因此 FontInfo 的 getter 行为会直接影响字体加载与后续渲染,而不是只在初始化时运行一次。
createNativeFontFace() {
  if (!this.data || this.disableFontFace) {
    return null;
  }
  let nativeFontFace;
  if (!this.cssFontInfo) {
    nativeFontFace = new FontFace(this.loadedName, this.data, {});
  } else {
    const css = {
      weight: this.cssFontInfo.fontWeight,
    };
    if (this.cssFontInfo.italicAngle) {
      css.style = `oblique ${this.cssFontInfo.italicAngle}deg`;
    }
    nativeFontFace = new FontFace(
      serializeFontFamily(this.cssFontInfo.fontFamily),
      this.data,
      css
    );
  }
  this._inspectFont?.(this);
  return nativeFontFace;
}
注意这里多次访问 this.cssFontInfo。由于底层 getter 不缓存,每次访问都会重新复制嵌套 buffer 并创建包装器;这不是一个被缓存的 css 对象。data 则相反,每次得到的是同一底层 buffer 上的新 Uint8Array 视图,直到 clearData() 替换内部 buffer。
系统字体路径最终消费 loadedName、src 与 style,加载失败时用 baseFontName 打警告;canvas.js 还会读取 systemFontInfo?.css 作为 canvas 字体的 typeface。这些字段都来自下面的解码器,而不是 Worker 类实例的原型属性。
CssFontInfo:从 0 开始的顺序字符串扫描
CSS info 是三段连续的「大端 Uint32 字节长度 + UTF-8 字节」,没有总长度头。fontFamily、fontWeight、italicAngle 分别对应索引 0、1、2。
class CssFontInfo {
  #buffer;
  #view;

  constructor(buffer) {
    this.#buffer = buffer;
    this.#view = new DataView(buffer);
  }

  #readString(index) {
    assert(index < CSS_FONT_INFO.strings.length, 'Invalid string index');
    const { decoder } = InfoUtils;
    let offset = 0;
    for (let i = 0; i < index; i++) {
      offset += this.#view.getUint32(offset) + 4;
    }
    const length = this.#view.getUint32(offset);
    return decoder.decode(new Uint8Array(this.#buffer, offset + 4, length));
  }
}
三个公开 getter 只是分别调用 #readString(0)、#readString(1)、#readString(2)。读取第 index 条时,循环只跳过它前面的字符串。每跳过一条,偏移增加 4 + byteLength;随后在目标字符串的长度前缀处读取 length,再从 offset + 4 建立 UTF-8 字节视图。
这里的长度是 UTF-8 字节数,不是 JavaScript 字符串的 UTF-16 code unit 数。getUint32(offset) 没传第二个参数,所以使用 DataView 默认的大端序,与 core 的 setUint32(offset, length) 完全对应。
三个 getter 都没有缓存。读取 italicAngle 要跳过前两条;下一次再读仍会重新扫描、重新建立视图并 decode。只有 TextDecoder 实例被复用。
SystemFontInfo:偏移 1 的总长度与特殊 style 定位
系统字体 info 在字符串前多一个字节 guessFallback,并在偏移 1 放一个未按 4 字节对齐的 Uint32 字符串总长度。DataView 支持非对齐访问,因此偏移 1 不是错误。
普通字符串从偏移 5 开始,布局仍是四条长度前缀字符串:
get guessFallback() {
  return this.#view.getUint8(0) !== 0;
}

#readString(index) {
  assert(index < SYSTEM_FONT_INFO.strings.length, "Invalid string index");
  const { decoder } = InfoUtils;
  let offset = 5;
  for (let i = 0; i < index; i++) {
    offset += this.#view.getUint32(offset) + 4;
  }
  const length = this.#view.getUint32(offset);
  return decoder.decode(new Uint8Array(this.#buffer, offset + 4, length));
}| 区域 | 位置 | 含义 |
|---|---|---|
| 标志 | 0 | 非 0 即 guessFallback === true |
| 字符串总长度 | 1..4 | 四条字符串的长度前缀与内容总字节数,大端 |
| 字符串内容 | 5 | css、loadedName、baseFontName、src |
| 样式块 | 5 + stringsLength | 依次是 style.style、style.weight |
style 没有复用 #readString,因为它不扫描四条普通字符串,而是利用总长度直接跳转:
get style() {
  const { decoder } = InfoUtils;
  let offset = 1;
  offset += 4 + this.#view.getUint32(offset);
  const styleLength = this.#view.getUint32(offset);
  const style = decoder.decode(
    new Uint8Array(this.#buffer, offset + 4, styleLength)
  );
  offset += 4 + styleLength;
  const weightLength = this.#view.getUint32(offset);
  const weight = decoder.decode(
    new Uint8Array(this.#buffer, offset + 4, weightLength)
  );
  return { style, weight };
}
初始 offset = 1 指向字符串总长度。表达式 offset += 4 + stringsLength 先加总长字段自身的四字节,再加字符串内容,结果正好是 5 + stringsLength,即样式长度前缀的位置。这个偏移看似跳跃,实际与 core 在偏移 1 回填总长度的写入逻辑一一对应。
读取完 style 后,偏移前进 4 + styleLength,落到 weight 的长度前缀;最后返回一个新对象 { style, weight }。所有长度仍按默认大端读取。
这里有一个必须按源码理解的读写不对称:core 的 if (info.style) 允许不写样式块,但 display 的 style getter 没有存在标志或空值分支。它假定当前系统字体信息带有样式;正常字体替换数据提供这一字段。如果手工给一个无样式 buffer 调用该 getter,源码不会返回 null,而可能因越界读取抛错。不能擅自把协议解释成「style 可空且读取端会安全处理」。
FontInfo:extra 在 buffer 外,字段在 getter 中解码
构造函数保存 buffer 并创建一个覆盖全量的 DataView。extra 若存在,就直接合并为实例自身的普通属性;这些调试或渲染附加字段不参与下面的二进制寻址。
constructor({ buffer, extra }) {
  this.#buffer = buffer;
  this.#view = new DataView(buffer);
  if (extra) {
    Object.assign(this, extra);
  }
}
构造阶段没有预先读出所有字体属性,也没有构造嵌套 info。除了 extra,其余字段都等到 getter 被访问时才解码。
三态布尔:每字段 2 bit,而不是真正布尔的一字节
#readBoolean(index) {
  assert(index < FONT_INFO.bools.length, "Invalid boolean index");
  const byteOffset = Math.floor(index / 4);
  const bitOffset = (index * 2) % 8;
  const value = (this.#view.getUint8(byteOffset) >> bitOffset) & 0x03;
  return value === 0x00 ? undefined : value === 0x02;
}
一个字节容纳四个字段,索引 0 使用最低两位,索引 1 使用接下来的两位,以此类推。byteOffset 每四个索引前进一字节,bitOffset 则依次是 0、2、4、6。
| 写入值 | 2 bit 表示 | getter 结果 |
|---|---|---|
undefined | 00 | undefined |
false | 01 | false |
true | 10 | true |
因此 undefined 与 false 没有在传输中合并。当前 core 不会产生 11;display 的三元表达式对非 00、非 10 的值都会得到 false,源码并没有额外拒绝 11 的分支。
字段索引依次是 black、bold、disableFontFace、fontExtraProperties、isInvalidPDFjsFont、isType3Font、italic、missingFile、remeasure、vertical。前八个占字节 0 和 1,后两个占字节 2 的低四位。
数字与定长数组:固定偏移,但两种字节序
三个数字直接按 schema 中的索引读取,每项八字节:
#readNumber(index) {
  assert(index < FONT_INFO.numbers.length, "Invalid number index");
  return this.#view.getFloat64(FONT_INFO.OFFSET_NUMBERS + index * 8);
}ascent(0)、defaultWidth(1)、descent(2) 分别位于偏移 3、11、19。getFloat64 没传 littleEndian,所以是大端;core 的 setFloat64(offset, value) 同样使用默认大端。
数组读取则统一显式传 true,即小端:
#readArray(offset, arrLen, lookupName, increment) {
  const len = this.#view.getUint8(offset);
  if (len === 0) {
    return undefined;
  }
  assert(len === arrLen, "Invalid array length.");
  offset += 1;
  const arr = new Array(len);
  for (let i = 0; i < len; i++) {
    arr[i] = this.#view[lookupName](offset, true);
    offset += increment;
  }
  return arr;
}| getter | 长度标记位置 | 期望长度 | 元素读取 | 每项字节数 |
|---|---|---|---|---|
bbox | 27 | 4 | getInt16(..., true) | 2 |
fontMatrix | 36 | 6 | getFloat64(..., true) | 8 |
defaultVMetrics | 85 | 3 | getInt16(..., true) | 2 |
长度 0 表示字段不存在,返回 undefined;非 0 必须等于固定长度,否则断言失败。即使字段不存在,写入端也保留了载荷空间,所以后续固定偏移不会移动。每次成功读取都会新建普通 JavaScript Array,不是 typed array,也不缓存。
这里最能说明为什么不能凭直觉统一字节序:同在 FontInfo 中,三个独立数字是大端,fontMatrix 的六个 Float64 却是小端,bbox 与 defaultVMetrics 的整数也显式小端。读取端与写入端一致,不代表整个 buffer 只有一种序。
字符串区段:总长度用于跳过,单条长度用于 decode
FONT_INFO.strings 的顺序是 fallbackName、loadedName、mimetype、name。与 CSS info 不同,整个字符串区段在偏移 92 先有一个总长度,第一条字符串自己的长度前缀则从偏移 96 开始。
#readString(index) {
  assert(index < FONT_INFO.strings.length, "Invalid string index");
  const { decoder } = InfoUtils;
  let offset = FONT_INFO.OFFSET_STRINGS + 4;
  for (let i = 0; i < index; i++) {
    offset += this.#view.getUint32(offset) + 4;
  }
  const length = this.#view.getUint32(offset);
  return decoder.decode(new Uint8Array(this.#buffer, offset + 4, length));
}
OFFSET_STRINGS + 4 不是多跳了一个字段:它跳过的正好是区段总长度,不是第一条字符串的长度。循环中的 getUint32(offset) 则读取当前要跳过字符串自己的长度。
设四条字符串总载荷为 S,它包含每条的 4 字节长度前缀和 UTF-8 内容,但不包含偏移 92 的总长字段自身。尾部各区段可写成:
| 区段 | 长度前缀位置 | 内容起点 |
|---|---|---|
| 四条字体字符串 | 92 存总长 S | 96 |
systemFontInfo | 96 + S | 100 + S |
cssFontInfo | 100 + S + Ls | 104 + S + Ls |
data | 104 + S + Ls + Lc | 108 + S + Ls + Lc |
其中 Ls、Lc 分别是 system 与 css 嵌套 buffer 的实际字节长度。每个长度字段都是大端 Uint32,0 长度表示对应嵌套 info 或 data 不存在。
data 与尾部定位:先顺序跳过,再建立零拷贝视图
#getDataOffsets() 不关心各字符串内容,只利用三级长度顺序前进:
#getDataOffsets() {
  let offset = FONT_INFO.OFFSET_STRINGS;
  const stringsLength = this.#view.getUint32(offset);
  offset += 4 + stringsLength;
  const systemFontInfoLength = this.#view.getUint32(offset);
  offset += 4 + systemFontInfoLength;
  const cssFontInfoLength = this.#view.getUint32(offset);
  offset += 4 + cssFontInfoLength;
  const length = this.#view.getUint32(offset);

  return { offset, length };
}

get data() {
  const { offset, length } = this.#getDataOffsets();
  return length === 0
    ? undefined
    : new Uint8Array(this.#buffer, offset + 4, length);
}
返回的 offset 指向 data 长度字段,不是字体字节本身,所以 data 从 offset + 4 建视图。length === 0 同时覆盖「原本没有 data」与「已经 clearData」两种状态。
这个 getter 不复制字体程序,只创建 Uint8Array 视图。重复访问会重复定位并创建视图,但所有视图共享当前 #buffer。如果把某个旧视图保存到外部,它也不会因为 FontInfo 后来替换 #buffer 而自动改指向。
clearData:保留尾部之前的内容,复制成更小的 buffer
clearData() {
  const { offset, length } = this.#getDataOffsets();
  if (length === 0) {
    return;
  }
  this.#view.setUint32(offset, 0);

  this.#buffer = new Uint8Array(this.#buffer, 0, offset + 4).slice().buffer;
  this.#view = new DataView(this.#buffer);
}
第一步把旧 buffer 中的 data 长度写成 0。第二步建立从字节 0 到 offset + 4 的视图,范围包含固定头、字符串、两个嵌套 info 以及四字节的 data 长度,但不包含 data 载荷;.slice() 复制这段内容,再取新 buffer。
因此清理后:
- 新的
datagetter 读到长度 0,返回undefined。 - 字符串、布尔、数字、数组以及嵌套 info 的长度字段都被保留,仍然可读。
- 内部
#buffer的物理长度缩短到offset + 4,旧大 buffer 在没有其他引用时可以回收。 - 第二次调用会重新定位到同一个末尾长度字段,发现 0 后直接返回,不会再次缩短或抛错;原本无 data 时也走同一分支,所以操作幂等。
这不是安全擦除。旧 data 字节没有被逐字节清零,而且清理前已返回的 Uint8Array 仍引用旧 buffer,仍可能读到数据并让旧内存保持存活。clearData() 的目的,是切断 FontInfo 自己对大块字节的持有,而不是撤销已经发出去的视图。
cssFontInfo / systemFontInfo:为什么必须复制子 buffer
两个嵌套 getter 都先顺序定位,0 长度返回 null,非 0 则分配精确大小的新数组并复制:
get cssFontInfo() {
  let offset = FONT_INFO.OFFSET_STRINGS;
  const stringsLength = this.#view.getUint32(offset);
  offset += 4 + stringsLength;
  const systemFontInfoLength = this.#view.getUint32(offset);
  offset += 4 + systemFontInfoLength;
  const cssFontInfoLength = this.#view.getUint32(offset);
  if (cssFontInfoLength === 0) {
    return null;
  }
  const cssFontInfoData = new Uint8Array(cssFontInfoLength);
  cssFontInfoData.set(
    new Uint8Array(this.#buffer, offset + 4, cssFontInfoLength)
  );
  return new CssFontInfo(cssFontInfoData.buffer);
}

get systemFontInfo() {
  let offset = FONT_INFO.OFFSET_STRINGS;
  const stringsLength = this.#view.getUint32(offset);
  offset += 4 + stringsLength;
  const systemFontInfoLength = this.#view.getUint32(offset);
  if (systemFontInfoLength === 0) {
    return null;
  }
  const systemFontInfoData = new Uint8Array(systemFontInfoLength);
  systemFontInfoData.set(
    new Uint8Array(this.#buffer, offset + 4, systemFontInfoLength)
  );
  return new SystemFontInfo(systemFontInfoData.buffer);
}复制首先满足构造器的坐标系:CssFontInfo 从 0 读第一条字符串,SystemFontInfo 从 0 读标志、从 1 读总长。如果只把父 buffer 传进去,嵌套内容并不在父 buffer 的 0 偏移;如果只保存视图,当前构造器又没有接收 byteOffset 的参数。
复制还隔离了生命周期。保留下来的嵌套包装器只持有自己的精确小 buffer,不会因为引用父 buffer 而顺带留住尾部可能达数 MB 的字体程序;在 FontInfo.clearData() 替换父 buffer 后,已经创建的嵌套包装器也不受影响。
这份独立性有代价:两个 getter 都没有缓存,每次访问都重新复制并新建包装器。源码选择让调用方决定是否需要保存结果,而不是在 FontInfo 内增加一套缓存失效规则。
PatternInfo:20 字节头后按顺序解码五段数据
构造器保留三种视图:buffer 用于 typed array,view 用于显式数值读取,data 用于单字节标志。getIR() 一次完成读取,不像字体属性那样拆成多个 getter。
getIR() {
  const dataView = this.view;
  const kind = this.data[PATTERN_INFO.KIND];
  const hasBBox = !!this.data[PATTERN_INFO.HAS_BBOX];
  const hasBackground = !!this.data[PATTERN_INFO.HAS_BACKGROUND];
  const nCoord = dataView.getUint32(PATTERN_INFO.N_COORD, true);
  const nColor = dataView.getUint32(PATTERN_INFO.N_COLOR, true);
  const nStop = dataView.getUint32(PATTERN_INFO.N_STOP, true);

  let offset = 20;
  const coords = new Float32Array(this.buffer, offset, nCoord * 2);
  offset += nCoord * 8;
  const colors = new Uint8Array(this.buffer, offset, nColor * 4);
  offset += nColor * 4;
  const stops = [];
  for (let i = 0; i < nStop; ++i) {
    const p = dataView.getFloat32(offset, true);
    offset += 4;
    const rgb = dataView.getUint32(offset, true);
    offset += 4;
    stops.push([p, `#${rgb.toString(16).padStart(6, "0")}`]);
  }
  let bbox = null;
  if (hasBBox) {
    bbox = [];
    for (let i = 0; i < 4; ++i) {
      bbox.push(dataView.getFloat32(offset, true));
      offset += 4;
    }
  }

  let background = null;
  if (hasBackground) {
    background = new Uint8Array(this.buffer, offset, 3);
    offset += 3;
  }
  // The kind-specific return value follows.
}
头部布局如下,所有多字节计数都显式小端:
| 偏移 | 字段 | 读取结果 |
|---|---|---|
| 0 | KIND | 1 axial、2 radial、3 mesh |
| 1 | HAS_BBOX | 是否存在四个 Float32 |
| 2 | HAS_BACKGROUND | 是否存在三字节背景 |
| 3 | SHADING_TYPE | mesh 的 shadingType |
| 4 | N_COORD | 坐标对数量 |
| 8 | N_COLOR | 四字节步长颜色项数量 |
| 12 | N_STOP | 色标数量 |
| 16 | N_FIGURES | core 当前写 0;display 不读取它 |
从 20 开始,coords 含 nCoord * 2 个 Float32,即每对坐标 8 字节;colors 含 nColor * 4 个原始字节;每个 stop 含一个小端 Float32 位置和一个小端 Uint32 RGB 数值;可选 bbox 是四个小端 Float32;可选 background 是三个原始字节。
coords 与 colors 都是原 buffer 上的零拷贝视图。stops 是新建的普通数组,每个颜色通过 toString(16).padStart(6, "0") 还原成 #rrggbb;十六进制字母会变成小写,位置也已经是单精度值。bbox 存在时新建普通数组,background 则是三字节视图。
一个容易漏掉的字节序细节:coords 使用 new Float32Array(...),不是 getFloat32(..., true)。typed array 按运行平台的原生字节序解释字节,core 也用原生 Float32Array 写这一段;它不属于「显式 little-endian」字段。Pattern 的计数、stop、bbox 才是显式小端。
三类返回值在同一个尾部开关中构造:
if (kind === 1) {
  return [
    'RadialAxial',
    'axial',
    bbox,
    stops,
    Array.from(coords.slice(0, 2)),
    Array.from(coords.slice(2, 4)),
    null,
    null,
  ];
}
if (kind === 2) {
  return [
    'RadialAxial',
    'radial',
    bbox,
    stops,
    [coords[0], coords[1]],
    [coords[3], coords[4]],
    coords[2],
    coords[5],
  ];
}
if (kind === 3) {
  const shadingType = this.data[PATTERN_INFO.SHADING_TYPE];
  let bounds = null;
  if (coords.length > 0) {
    bounds = BBOX_INIT.slice();
    for (let i = 0, ii = coords.length; i < ii; i += 2) {
      Util.pointBoundingBox(coords[i], coords[i + 1], bounds);
    }
  }
  return ['Mesh', shadingType, coords, colors, nCoord, bounds, bbox, background];
}
throw new Error(`Unsupported pattern kind: ${kind}`);
轴向图案把四个坐标还原为两个普通点数组,半径位置固定为 null。径向图案读取六元组 [x0, y0, r0, x1, y1, r1],重新组成两个圆心与两个半径。这里的小坐标数组都复制成普通数组,不把底层 typed array 暴露给渐变 IR。
Mesh 则保留 coords、colors 大视图,并把 nCoord 放在 IR 索引 4 作为顶点数。索引 5 的 bounds 不是上传字段,而是从 [Infinity, Infinity, -Infinity, -Infinity] 的副本开始,逐点计算最小最大 x/y;没有坐标时为 null。索引 6 的 bbox 是 buffer 中可选的声明包围盒,不能与重算的 bounds 混为一谈。索引 7 是可选背景。
getIR() 本身不缓存结果。不过 api.js 的 Pattern 分支只调用一次,并把返回的 IR 而非 PatternInfo 包装器放进 commonObjs。IR 中的 typed array 视图继续持有底层 buffer,所以包装器不再被引用也不会让数据失效。
FontPathInfo:没有字段头,类型由构建与运行环境决定
路径 buffer 就是一段扁平类型化数组的原始字节,没有元素数量、精度标记或字节序标记:
class FontPathInfo {
  #buffer;

  constructor(buffer) {
    this.#buffer = buffer;
  }

  get path() {
    if (
      (typeof PDFJSDev !== 'undefined' && PDFJSDev.test('MOZCENTRAL')) ||
      FeatureTest.isFloat16ArraySupported
    ) {
      return new Float16Array(this.#buffer);
    }
    return new Float32Array(this.#buffer);
  }
}
MOZCENTRAL 构建或运行环境支持 Float16Array 时,按半精度建立视图;否则回退到 Float32Array。FeatureTest.isFloat16ArraySupported 实际检查 typeof Float16Array !== "undefined",并用 shadow 缓存这个能力判断。
这个条件与 Worker 端 Commands.getPath() 选择写入数组类型的条件一致。compileFontPathInfo 只做 path.slice().buffer,不会进行 16/32 位转换;display 端也没有手工解码 half float,而是选择匹配的类型化数组构造器。
path 每次访问都新建一个覆盖整个 buffer 的视图,不复制字节,也不缓存视图。FontFaceObject.getPathGenerator 后续把 cmds?.path 交给 makePathFromDrawOPS,生成路径函数后才由 compiledGlyphs 缓存;那是另一层缓存,不能误以为 FontPathInfo.path 自己缓存。
与 Pattern 的 coords 一样,这里没有 DataView 的字节序参数,数组按平台原生序解释原始字节。buffer 的字节长度也必须符合所选元素宽度,这是写入端合法输入所保证的协议前提。
设计要点
1. getter 是按需读取,不是自动缓存
这个文件的「懒」主要体现在构造时不把完整对象物化;它并没有为每个属性配套 memoization。
| 访问 | 每次调用的工作 | 是否复制数据 | 是否缓存结果 |
|---|---|---|---|
| 布尔、数字 | 再读当前字节 | 否 | 否 |
| 普通字符串 | 重新定位并 UTF-8 decode | 生成解码后的字符串 | 否 |
bbox 等数组 | 重新读取元素并新建数组 | 是,生成普通数组 | 否 |
data | 重新定位并新建视图 | 否 | 否 |
| CSS/System info | 重新复制嵌套区段并新建包装器 | 是 | 否 |
PatternInfo.getIR() | 重建 stops、bbox、bounds 与 IR | 部分 | 否 |
FontPathInfo.path | 新建同类型视图 | 否 | 否 |
被缓存的是共享 TextDecoder 和 FeatureTest 能力值,不是上述属性结果。commonObjs 与 compiledGlyphs 也属于更外层对象管理,不应记到这些 getter 名下。
2. 字节序是逐字段协议,不是文件级开关
| 数据 | 读取 API | 字节序 |
|---|---|---|
| 字符串长度、区段长度、data 长度 | getUint32(offset) | 默认大端 |
ascent 等三个数字 | getFloat64(offset) | 默认大端 |
bbox、defaultVMetrics | getInt16(offset, true) | 小端 |
fontMatrix | getFloat64(offset, true) | 小端 |
| Pattern 计数、stop、bbox | getUint32/getFloat32(..., true) | 小端 |
Pattern coords | Float32Array | 平台原生序 |
| FontPath 全部元素 | Float16Array / Float32Array | 平台原生序 |
DataView 的 littleEndian 参数缺省为 false,所以缺省就是 big-endian。单字节标志没有字节序问题。阅读或修改这份协议时,必须逐行对照 core 的 setter,不能用一处 true 推断全文件,也不能把 typed array 当成显式小端读取。
3. 长度字段同时承担寻址与存在性
固定头让高频小字段可以直接寻址;可变尾部则通过「读取长度、前进 4 + length」跳过。这样无需为每个字符串保存绝对偏移,也无需扫描 UTF-8 内容寻找分隔符。
0 长度在不同上下文有不同返回约定:数组长度 0 得到 undefined,嵌套 info 长度 0 得到 null,data 长度 0 得到 undefined。这些差异是源码 API 的一部分,不应为了表面统一而改写。
4. 视图与复制的选择同时考虑成本和所有权
大字体 data、Pattern 大坐标/颜色数组、FontPath 都优先返回视图,避免再次复制。轴向/径向的小坐标、stops、bbox 和普通数组字段则直接物化为绘制代码易用的结构。
CSS/System info 的复制看似例外,实则同时解决子 buffer 从 0 寻址与独立生命周期两个问题。clearData() 也复制,但它只保留 data 之前的短前缀,用一次小复制换取释放大字体程序的机会。
5. 释放的是当前持有者,不是所有既有引用
FontInfo 替换私有 buffer 后,未来的 getter 使用新 buffer;旧视图、旧嵌套对象以及已经交给其他代码的 typed array 不会因私有字段改变而被重写。分析内存是否真正下降时,必须继续追踪 FontFace、data 临时视图或调试工具是否还持有旧数据。
总结
obj_bin_transform_display.js 是 core 二进制协议的主线程解释器。FontInfo 用三字节位组、固定数值区和长度前缀尾部还原字体;CssFontInfo 与 SystemFontInfo 在独立子 buffer 中扫描 UTF-8 字符串;PatternInfo.getIR() 把 20 字节头与五段载荷还原成三类 IR;FontPathInfo 则按共同的环境假设选择半精度或单精度视图。
这份实现的核心不是「把 buffer 转回对象」这句话,而是四条更具体的约束:字段顺序与 core 完全一致;大端、小端和 typed array 原生序逐字段区分;getter 按需执行且大多不缓存;视图、子 buffer 复制和 clearData() 共同管理内存所有权。
StreamPDF 的设计原则: 能前置处理的绝对不放到解析的时候才做, 由服务端一次解决所有性能问题. 浏览器只获取&渲染必须数据.
相关文章
- PDF.js 从 demo 深入浅出 10: CanvasGraphics 与 operatorList 绘制2026年10月27日
- PDF.js 从 demo 深入浅出 9: 网络流与 Range 请求2026年10月27日
- PDF.js 从 demo 深入浅出 8: PDFWorker.create 与真假 Worker 握手2026年10月27日
- PDF.js 从 demo 深入浅出 7: WorkerTransport 初始化2026年10月27日
- PDF.js 从 demo 深入浅出 6: MessageHandler 跨线程通讯2026年10月27日
- PDF.js 从 demo 深入浅出 5: render 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 4: getViewport 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 3: getPage 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 2: getDocument 方法全貌2026年10月27日
- PDF.js 源码解读: TextLayer2026年10月27日
- PDF.js 源码解读: font_loader2026年10月27日
- PDF.js 源码解读: PDFObjects2026年10月27日
- PDF.js 源码解读: 网络流2026年10月27日
- PDF.js 源码解读: internal_evt.js2026年10月27日
- PDF.js 源码解读: math_clamp.js2026年10月27日
- PDF.js 源码解读: css_utils.js2026年10月27日
- PDF.js 源码解读: scripting_utils2026年10月27日
- PDF.js 源码解读: MurmurHash3_642026年10月27日
- PDF.js 源码解读: obj_bin_transform_utils2026年10月27日
- PDF.js 源码解读: image_utils.js2026年10月27日
- PDF.js 源码解读: BasePDFStream2026年10月27日
- PDF.js 源码解读: 共享工具层2026年10月27日
- PDF.js 源码解读: MessageHandler2026年10月27日
- PDF.js 源码解读: api2026年10月27日
- PDF.js 源码解读: fonts2026年10月27日
- PDF.js 源码解读: glyphlist2026年10月27日
- PDF.js 源码解读: binary_cmap2026年10月27日
- PDF.js 源码解读: cmap2026年10月27日
- PDF.js 源码解读: encodings2026年10月27日
- PDF.js 源码解读: metrics2026年10月27日
- PDF.js 源码解读: standard_fonts2026年10月27日
- PDF.js 源码解读: fonts_utils2026年10月27日
- PDF.js 源码解读: default_appearance2026年10月27日
- PDF.js 源码解读: metadata_parser2026年10月27日
- PDF.js 源码解读: name_number_tree2026年10月27日
- PDF.js 源码解读: struct_tree2026年10月27日
- PDF.js 源码解读: catalog2026年10月27日
- PDF.js 源码解读: pdf_manager2026年10月27日
- PDF.js 源码解读: object_loader2026年10月27日
- PDF.js 源码解读: obj_bin_transform_core2026年10月27日
- PDF.js 源码解读: crypto2026年10月27日
- PDF.js 源码解读: core_utils2026年10月27日
- PDF.js 源码解读: primitives2026年10月27日
- PDF.js 源码解读: worker_stream2026年10月27日
- PDF.js 源码解读: ccitt_stream2026年10月27日
- PDF.js 源码解读: jpx_stream2026年10月27日
- PDF.js 源码解读: jbig2_stream2026年10月27日
- PDF.js 源码解读: jpeg_stream2026年10月27日
- PDF.js 源码解读: decrypt_stream2026年10月27日
- PDF.js 源码解读: brotli_stream2026年10月27日
- PDF.js 源码解读: run_length_stream2026年10月27日
- PDF.js 源码解读: ascii_hex_stream2026年10月27日
- PDF.js 源码解读: ascii_85_stream2026年10月27日
- PDF.js 源码解读: lzw_stream2026年10月27日
- PDF.js 源码解读: predictor_stream2026年10月27日
- PDF.js 源码解读: flate_stream2026年10月27日
- PDF.js 源码解读: decode_stream2026年10月27日
- PDF.js 源码解读: chunked_stream2026年10月27日
- PDF.js 源码解读: stream2026年10月27日
- PDF.js 源码解读: base_stream2026年10月27日
- PDF.js 深入浅出 11: Parser2026年10月26日
- PDF.js 深入浅出 10: XRef2026年10月26日
- PDF.js 深入浅出 9: CanvasGraphics2026年10月26日
- PDF.js 深入浅出 8: Document 与 Page2026年10月26日
- AI 时代, 我们到底应该做什么才能活下去(StreamPDF 创立有感)2026年10月26日
- PDF.js 深入浅出 7: PartialEvaluator2026年10月25日
- PDF.js 深入浅出 6: PDFManager.initDocument2026年10月25日
- PDF.js 深入浅出 5: PDFFetchStream 和 PDFWorkerStream2026年10月25日
- PDF.js 深入浅出 4: MessageHandler2026年10月22日
- PDF.js 深入浅出 3: getViewport & render2026年10月22日
- PDF.js 从 demo 深入浅出 1: 自定义 viewer 渲染 PDF2026年10月19日
- PDF.js 深入浅出 2: getDocument & getPage2026年10月19日
- PDF.js 深入浅出 1: PDF.js 的架构设计2026年10月16日