
PDF.js 源码解读: TextLayer
2026年10月27日 · StreamPDF Team
前言
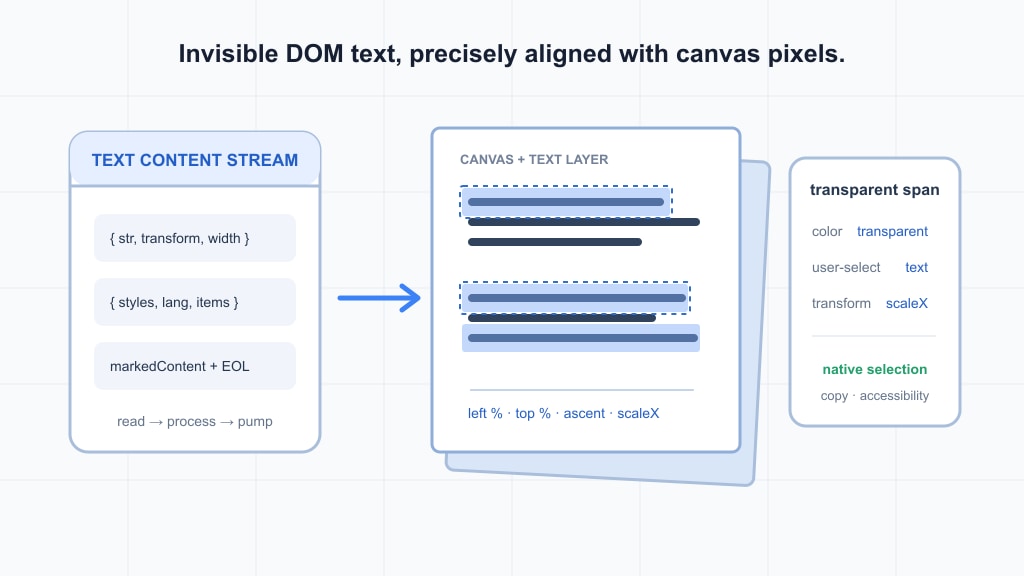
这是 PDF.js 渲染闭环的文本侧续篇。CanvasGraphics 已经把字形画成像素,但 canvas 本身不知道哪些像素构成一个字符,更不能原生提供文本选择、复制与语义结构。
src/display/text_layer.js 接手另一条数据流:PDFPageProxy.streamTextContent() 或 getTextContent() 把 Worker 求值后的文本 item 送到主线程,TextLayer 再把这些 item 变成覆盖在 canvas 上的透明 DOM。用户选中的是 DOM 文本,看见的却是 canvas 字形;两者必须共享同一套位置、方向、字号与宽度。
本篇完整拆解这个 564 行文件:流式泵、坐标变换、marked content 容器、透明 span、横向缩放、旋转更新、取消与全局测量缓存。需要划清边界:这里提供查找和无障碍所需的对齐结构,但不实现搜索、匹配或高亮;TextLayerImages 也只是可选的图片右键占位能力,不是文本定位的一部分。
模块总览
TextLayer 位于「文本数据」与「浏览器原生文本能力」之间:
PDF text operators
  -> worker-side text items and styles
  -> streamTextContent(): ReadableStream
  -> getTextContent(): one aggregated TextContent
  -> TextLayer.render()
  -> transparent spans + markedContent containers + br
  -> native selection/copy and external accessibility consumers
文件虽然只有一个导出类,内部可以分成六组职责:
| 区块 | 关键成员 | 职责 |
|---|---|---|
| 输入归一化 | 构造函数 | 接受 ReadableStream,或把一次性 TextContent 包成单 chunk 流 |
| 生命周期 | render / update / cancel | 流式渲染、已有 DOM 的缩放与旋转更新、中止读取 |
| 结构生成 | #processItems / #appendText | marked content 容器栈、文本 span、EOL |
| 几何布局 | #appendText / #layout | 基线与 ascent 定位、百分比坐标、旋转和横向缩放 |
| 浏览器测量 | #getCtx / #getAscent / #ensureMinFontSizeComputed | 字体宽度、ascent、最小字号探测 |
| 公共输出 | textDivs / textContentItemsStr | 给外部消费者提供与输入 item 对应的 live 数组 |
实例状态按生命周期也能清楚分层:#reader 与 #capability 管流,#container 与 #rootContainer 管 DOM,#transform、#pageWidth、#pageHeight 管页面坐标,#scale 与 #rotation 记录已布局视口,#styleCache 聚合字体样式,#layoutTextParams 复用布局参数,#textDivProperties 用 WeakMap 保存更新时仍需的几何数据。
五个静态成员则是跨实例共享的浏览器资源:
static #ascentCache = new Map();
static #canvasContexts = new Map();
static #canvasCtxFonts = new WeakMap();
static #minFontSize = null;
static #pendingTextLayers = new Set();
它们分别缓存字体 ascent、按语言划分的 DOM canvas 2D context、每个 context 当前字体、浏览器最小字号,以及尚未结束的 TextLayer 实例。后文会看到,它们为什么不能随意清理,又为什么这里坚持使用 DOM canvas。
方法级源码块与分析
数据入口:streamTextContent 与 getTextContent
streamTextContent 不直接返回整页对象,而是通过 MessageHandler.sendWithStream 建立流:
streamTextContent({
  includeMarkedContent = false,
  disableNormalization = false,
} = {}) {
  const TEXT_CONTENT_CHUNK_SIZE = 100;

  return this._transport.messageHandler.sendWithStream(
    "GetTextContent",
    {
      pageId: this.#pagesMapper.getPageId(this._pageIndex + 1) - 1,
      pageIndex: this._pageIndex,
      includeMarkedContent: includeMarkedContent === true,
      disableNormalization: disableNormalization === true,
    },
    {
      highWaterMark: TEXT_CONTENT_CHUNK_SIZE,
      size(textContent) {
        return textContent.items.length;
      },
    }
  );
}
highWaterMark: 100 配合 size 表示排队背压按 item 数计算,不是说每个 chunk 固定有 100 个 item。includeMarkedContent 决定结构标记是否进入 items;disableNormalization 控制 Worker 端文本规范化。
getTextContent 是同一条流的聚合器,而不是另一套提取实现:
async getTextContent(params = {}) {
  if (this._transport._htmlForXfa) {
    return this.getXfa().then(xfa => XfaText.textContent(xfa));
  }
  const readableStream = this.streamTextContent(params);
  const textContent = {
    items: [], styles: Object.create(null), lang: null,
  };

  for await (const value of readableStream) {
    textContent.lang ??= value.lang;
    Object.assign(textContent.styles, value.styles);
    textContent.items.push(...value.items);
  }
  return textContent;
}
普通 PDF 路径中,它消费完流后返回 { items, styles, lang };XFA 是独立分支。lang ??= 只采用第一个非 null/undefined 的语言值,样式按 chunk 顺序合并。这与 TextLayer.render 的聚合方式完全同构。
每个普通文本 item 提供 str、dir、transform、width、height、fontName、hasEOL;styles[fontName] 提供 fontFamily、vertical,以及可用于回退的 ascent / descent。结构 item 则没有 str,用 type 表达 marked content 的开始或结束。
构造函数:统一输入,建立页面坐标系
两个常量分别限制 DOM 数量与规定字体探测字号:
const MAX_TEXT_DIVS_TO_RENDER = 100000;
const DEFAULT_FONT_SIZE = 30;
构造函数首先把两种输入统一成 ReadableStream,再保存几何与视口状态:
constructor({ textContentSource, images, container, viewport }) {
  if (textContentSource instanceof ReadableStream) {
    this.#textContentSource = textContentSource;
  } else if (typeof textContentSource === "object") {
    this.#textContentSource = new ReadableStream({
      start(controller) {
        controller.enqueue(textContentSource);
        controller.close();
      },
    });
  } else {
    throw new Error('No "textContentSource" parameter specified.');
  }
  this.#container = this.#rootContainer = container;
  this.#imagesHandler = images;
  this.#scale = viewport.scale * OutputScale.pixelRatio;
  this.#rotation = viewport.rotation;
  const { pageWidth, pageHeight, pageX, pageY } = viewport.rawDims;
  this.#transform = [1, 0, 0, -1, -pageX, pageY + pageHeight];
  this.#pageWidth = pageWidth;
  this.#pageHeight = pageHeight;
  // Minimum-font setup, setLayerDimensions, and capability cleanup follow.
}
真实源码还给对象包装分支加了 GENERIC 构建条件,并把 #layoutTextParams 初始化为 { div: null, properties: null, ctx: null } 供各 item 复用。于是 streamTextContent() 可以逐 chunk 渲染,await getTextContent() 也能作为一次性输入;后者只是在 start 中 enqueue 一次并 close,不会让后续 pump 拥有两条处理路径。
#scale 是 viewport.scale * devicePixelRatio,其中 OutputScale.pixelRatio 读取 globalThis.devicePixelRatio || 1。它服务于 canvas 字体测量;#rotation 则用于判断已有文本层是否需要更新旋转状态。
#transform 是理解定位的关键。PageViewport.rawDims 直接从未缩放的 viewBox = [xMin, yMin, xMax, yMax] 得出:
get rawDims() {
  const dims = this.viewBox;
  return shadow(this, "rawDims", {
    pageWidth: dims[2] - dims[0],
    pageHeight: dims[3] - dims[1],
    pageX: dims[0],
    pageY: dims[1],
  });
}
所以 TextLayer 自己的矩阵把 PDF 页面点 (x, y) 映射为 (x - pageX, pageY + pageHeight - y):先减去页面原点,再把 PDF 的 y 向上改成 DOM 的 y 向下。它没有 viewport 的缩放、旋转和偏移;这些由外层尺寸与 CSS 状态处理,不能在这里重复应用。
这也是 TextLayer 不直接采用 viewport.transform 的原因。PageViewport.transform 把缩放、90 度旋转、y 翻转与 offset 合成给 canvas 使用;文本 span 则以未缩放页面坐标记录百分比位置,外层再统一缩放和旋转。两者路径不同,但最终页面几何一致。
初始容器尺寸由 setLayerDimensions(container, viewport) 设置。它同样使用 rawDims,而不是把像素尺寸写死:
function setLayerDimensions(div, viewport, mustFlip = false, mustRotate = true) {
  if (viewport instanceof PageViewport) {
    const { pageWidth, pageHeight } = viewport.rawDims;
    const { style } = div;
    const widthStr = `round(down, var(--total-scale-factor) * ${pageWidth}px, var(--scale-round-x))`;
    const heightStr = `round(down, var(--total-scale-factor) * ${pageHeight}px, var(--scale-round-y))`;
    style.width = widthStr;
    style.height = heightStr;
  }
  if (mustRotate) {
    div.setAttribute('data-main-rotation', viewport.rotation);
  }
}
上面省略了 mustFlip 的宽高互换分支;TextLayer 使用默认 mustFlip = false。--total-scale-factor 与取整粒度由外层 CSS 提供,data-main-rotation 则把页面旋转暴露给样式系统。
构造函数还会完成三件收尾工作:探测并写入 --min-font-size;给 capability 挂 finally,在成功或失败后从 #pendingTextLayers 删除实例、释放 #layoutTextParams 与 #styleCache;在 TESTING 构建中暴露只读 pageWidth / pageHeight。finally 派生 promise 上的空 catch 只避免未处理拒绝日志,不会把 render() 返回的原 promise 变成成功。
静态 fontFamilyMap 是另一个懒初始化公共入口:
static get fontFamilyMap() {
  const { isWindows, isFirefox } = FeatureTest.platform;
  return shadow(this, "fontFamilyMap", new Map([
    ["sans-serif", `${isWindows && isFirefox ? "Calibri, " : ""}sans-serif`],
    ["monospace", `${isWindows && isFirefox ? "Lucida Console, " : ""}monospace`],
  ]));
}
shadow 把计算结果写回静态属性,因此映射只创建一次。Windows Firefox 下给两类 generic family 加特定前置字体,是 bug 1922063 的兼容处理;其他环境仍使用原 family。
CSS 合约:透明不等于不存在
TextLayer 只写内联几何变量,透明与最终变换由 web/text_layer_builder.css 配合完成:
.textLayer {
  position: absolute;
  inset: 0;
  line-height: 1;
  transform-origin: 0 0;
}
.textLayer :is(span, br) {
  color: transparent;
  position: absolute;
  white-space: pre;
  transform-origin: 0% 0%;
  user-select: text;
}
.textLayer > :not(.markedContent),
.textLayer .markedContent span:not(.markedContent) {
  --font-height: 0;
  font-size: calc(var(--text-scale-factor) * var(--font-height));
  --scale-x: 1;
  --rotate: 0deg;
  transform: rotate(var(--rotate)) scaleX(var(--scale-x)) scale(var(--min-font-size-inv));
}
.textLayer .markedContent {
  display: contents;
}
四个自定义属性分工明确:
--font-height是 item 矩阵第二列的长度,单位是未缩放页面 px;CSS 再乘--text-scale-factor得到实际字号。--scale-x校正 DOM 字体自然宽度与 PDF item 目标宽度之间的差异,默认 1。--rotate保存文本基线角度,默认 0;变换原点是 span 左上角,也就是计算出的 ascent 定位点。--min-font-size与倒数变量配合:先放大字号避开浏览器最小字号,再通过scale(1 / minFontSize)缩回目标视觉尺寸。
color: transparent 让字形不可见,user-select: text 与真实文本节点让选择、复制仍然发生;::selection 只显示选择背景,不会把透明文字重新涂成可见颜色。marked content 容器使用 display: contents,保留 DOM 语义嵌套而不额外生成布局盒。
render:递归 pump 流式 chunk
render() 是主生命周期入口:
render() {
  if (this.#imagesHandler) {
    this.#container.append(this.#imagesHandler.render());
  }
  const pump = () => {
    this.#reader.read().then(({ value, done }) => {
      if (done) {
        this.#capability.resolve();
        return;
      }
      this.#lang ??= value.lang;
      Object.assign(this.#styleCache, value.styles);
      this.#processItems(value.items);
      pump();
    }, this.#capability.reject);
  };
  this.#reader = this.#textContentSource.getReader();
  TextLayer.#pendingTextLayers.add(this);
  pump();
  return this.#capability.promise;
}
每次 read() 完成后才发起下一次读取,所以这里既没有并发 read,也没有同步递归栈增长;Promise 回调把每一次 pump 分到新的微任务。chunk 一到就处理 items,首屏不必等整页文本提取结束。
#lang 与 #styleCache 的合并规则和 getTextContent 一样。流结束才 resolve capability;读失败则 reject。可选 images.render() 只在泵启动前追加图片占位容器,用来支持右键从页面 canvas 取图,它不参与文本 item 的坐标或排版。
实例在调用 render 时进入全局 #pendingTextLayers,在 capability settle 后的 finally 中离开。构造了实例但从未 render,不会被这个集合跟踪。
update:旋转与缩放是两条独立路径
已经渲染的文本层不需要因视口变化而重建所有 span:
update({ viewport, onBefore = null }) {
  const scale = viewport.scale * OutputScale.pixelRatio;
  const rotation = viewport.rotation;
  if (rotation !== this.#rotation) {
    onBefore?.();
    this.#rotation = rotation;
    setLayerDimensions(this.#rootContainer, { rotation });
  }
  if (scale !== this.#scale) {
    onBefore?.();
    this.#scale = scale;
    const params = { div: null, properties: null, ctx: TextLayer.#getCtx(this.#lang) };
    for (const div of this.#textDivs) {
      params.properties = this.#textDivProperties.get(div);
      params.div = div;
      this.#layout(params);
    }
  }
}
旋转分支只更新 #rotation 与根容器的 data-main-rotation。这里故意传入普通对象 { rotation },所以 setLayerDimensions 的 instanceof PageViewport 尺寸分支不会执行;item 的 left、top、angle 也不重算。
缩放分支则遍历全部 #textDivs,从 WeakMap 取回属性并重新 #layout。真正有文本且需要宽度校正的 span 会重新 measureText;空 item 或 canvasWidth === 0 的 item 在 layout 内跳过测量。位置百分比与 --font-height 不变,外层 CSS 负责整体尺寸变化。
onBefore 在实际修改前调用;若旋转和缩放都变化,会分别调用一次。viewer 可借此先隐藏旧层,避免用户看到中间状态,但隐藏与显示策略不属于 TextLayer。
cancel 与两个公共输出
取消同时处理上游流和对外 promise:
cancel() {
  const abortEx = new AbortException("TextLayer task cancelled.");
  this.#reader?.cancel(abortEx).catch(() => {});
  this.#reader = null;
  this.#capability.reject(abortEx);
}
get textDivs() { return this.#textDivs; }
get textContentItemsStr() { return this.#textContentItemsStr; }
reader.cancel(abortEx) 向上游传播取消,空 catch 只吸收取消过程自身的拒绝;capability 随即以同一个 AbortException 拒绝。构造函数注册的 finally 仍会执行 pending 清理。已经 append 的 DOM 没有在这个方法里逐节点拆除,容器的所有权仍在调用方。
两个 getter 返回内部 live 数组,不是拷贝。textContentItemsStr 按普通文本 item 顺序保存 str;textDivs 也为每个普通文本 item 保存一个 span。但 span 进入 textDivs 不等于进入 DOM:空字符串 item 也有 textDiv 和字符串项,只是不会 append。marked content item 不进入这两个数组,它们只改变容器结构。
#processItems:上限与 marked content 容器栈
每个 chunk 都交给这个方法:
#processItems(items) {
  if (this.#disableProcessItems) return;
  this.#layoutTextParams.ctx ??= TextLayer.#getCtx(this.#lang);
  for (const item of items) {
    if (this.#textDivs.length > MAX_TEXT_DIVS_TO_RENDER) {
      warn("Ignoring additional textDivs for performance reasons.");
      this.#disableProcessItems = true;
      return;
    }
    if (item.str === undefined) {
      if (item.type === "beginMarkedContentProps" || item.type === "beginMarkedContent") {
        const parent = this.#container;
        this.#container = document.createElement("span");
        this.#container.classList.add("markedContent");
        if (item.id) this.#container.setAttribute("id", item.id);
        if (item.tag === "Artifact") this.#container.ariaHidden = true;
        parent.append(this.#container);
      } else if (item.type === "endMarkedContent") {
        this.#container = this.#container.parentNode;
      }
      continue;
    }
    this.#textContentItemsStr.push(item.str);
    this.#appendText(item);
  }
}
#container 就是容器栈的栈顶。begin 创建 span.markedContent 并 append 到旧栈顶,再把它设为当前容器;beginMarkedContentProps 可带 id,tag === "Artifact" 时设置 ariaHidden = true,让装饰性内容退出无障碍树。end 通过 parentNode 回到上一层,后续文本自然落入正确的嵌套结构。
数量保护在处理每个 item 前检查。超过约 100000 个 textDiv 后,当前及后续 items 被忽略,并设置 #disableProcessItems 防止后续 chunk 重复警告;render 仍会继续把流读完。源码判断是 > 而非 >=,因此它是以 100000 为阈值的实用保护,不应理解成数学上绝不超过 100000 的硬断言。
空字符串与 marked content 要区分:前者有 str,会进入两个输出数组并创建 textDiv;后者 str === undefined,只操作容器。只有前者中的 str !== "" 才会最终 append 文本 span。
#appendText:从 item 矩阵到 span 几何
方法开头总是创建 span 与属性记录,并先把 span 放进 #textDivs:
const textDiv = document.createElement('span');
const textDivProperties = {
  angle: 0,
  canvasWidth: 0,
  hasText: geom.str !== '',
  hasEOL: geom.hasEOL,
  fontSize: 0,
};
this.#textDivs.push(textDiv);

const tx = Util.transform(this.#transform, geom.transform);
let angle = Math.atan2(tx[1], tx[0]);
const style = this.#styleCache[geom.fontName];
if (style.vertical) angle += Math.PI / 2;
const fontHeight = Math.hypot(tx[2], tx[3]);
const fontAscent = fontHeight * TextLayer.#getAscent(fontFamily, style, this.#lang);
Util.transform(m1, m2) 拼接矩阵,所以 tx 是 item 文本矩阵再套上页面 y 翻转。atan2(tx[1], tx[0]) 取基线第一列的方向;vertical 字体额外旋转 90 度。字号不是只看 geom.transform[3],而是取第二列向量长度,因此旋转矩阵也能得到正的 fontHeight。
fontFamily 默认来自 style.fontFamily;FontInspector 开启时可改用 style.fontSubstitution,再经过 fontFamilyMap 兼容映射。ascent 比例由静态测量或 style 回退得到,乘 fontHeight 就是基线到 span 顶部的距离。
定位分角度为零与非零两种形式:
let left, top;
if (angle === 0) {
  left = tx[4];
  top = tx[5] - fontAscent;
} else {
  left = tx[4] + fontAscent * Math.sin(angle);
  top = tx[5] - fontAscent * Math.cos(angle);
}
divStyle.left = `${((100 * left) / this.#pageWidth).toFixed(2)}%`;
divStyle.top = `${((100 * top) / this.#pageHeight).toFixed(2)}%`;
divStyle.setProperty('--font-height', `${fontHeight.toFixed(2)}px`);
divStyle.fontFamily = fontFamily;
textDivProperties.fontSize = fontHeight;
textDiv.setAttribute('role', 'presentation');
textDiv.textContent = geom.str;
textDiv.dir = geom.dir;
tx[4], tx[5] 是基线原点,不是文字框左上角。零角度直接向上退一个 ascent;其他角度沿基线法线偏移同一个距离,因此旋转文本仍然与 canvas 的基线对齐。
left/top 使用页面宽高归一化成百分比并保留两位小数,容器随视口改变尺寸时无需重写每个坐标。role="presentation" 避免屏幕阅读器在每个小 span 上停顿;dir 保留 ltr、rtl 或 vertical 文本可能的 ttb。FontInspector 开启时还会写 dataset.fontName,非零角度则以度数存入属性记录。
横向缩放并非对所有 span 一律执行:
let shouldScaleText = false;
if (geom.str.length > 1) {
  shouldScaleText = true;
} else if (geom.str !== ' ' && geom.transform[0] !== geom.transform[3]) {
  const absScaleX = Math.abs(geom.transform[0]);
  const absScaleY = Math.abs(geom.transform[3]);
  if (
    absScaleX !== absScaleY &&
    Math.max(absScaleX, absScaleY) / Math.min(absScaleX, absScaleY) > 1.5
  ) {
    shouldScaleText = true;
  }
}
if (shouldScaleText) {
  textDivProperties.canvasWidth = style.vertical ? geom.height : geom.width;
}
this.#textDivProperties.set(textDiv, textDivProperties);
this.#layoutTextParams.div = textDiv;
this.#layoutTextParams.properties = textDivProperties;
this.#layout(this.#layoutTextParams);
if (textDivProperties.hasText) this.#container.append(textDiv);
if (textDivProperties.hasEOL) {
  const br = document.createElement('br');
  br.setAttribute('role', 'presentation');
  this.#container.append(br);
}
多字符 item 总要校正宽度。单字符通常跳过,因为对选择高亮影响很小,却能显著减少大量单字符 span 文档的测量与滚动成本;例外是非空格单字符的横纵缩放差异显著,绝对值比例严格大于 1.5 时仍需校正。恰好 1.5 不触发,单个空格也不触发。
目标宽度取 geom.width,vertical 文本取 geom.height。随后无论是否有文本都会保存 WeakMap 属性并执行 layout;但只有 hasText 才把 span append 到当前 marked content 容器。hasEOL 独立追加同样为 presentation 的 <br>,所以一个空 item 不贡献 span,仍可能贡献换行。
#layout:用 measureText 求 --scale-x
真正写宽度校正值的只有这个方法:
#layout(params) {
  const { div, properties, ctx } = params;
  const { style } = div;
  if (properties.canvasWidth !== 0 && properties.hasText) {
    const { fontFamily } = style;
    const { canvasWidth, fontSize } = properties;
    TextLayer.#ensureCtxFont(ctx, fontSize * this.#scale, fontFamily);
    const { width } = ctx.measureText(div.textContent);
    if (width > 0) {
      style.setProperty("--scale-x", (canvasWidth * this.#scale) / width);
    }
  }
  if (properties.angle !== 0) {
    style.setProperty("--rotate", `${properties.angle}deg`);
  }
}
测量 canvas 的字体大小是 fontSize * #scale,目标宽度是 canvasWidth * #scale,二者处于同一个有效坐标尺度。比例 target / measured 交给 CSS scaleX,浏览器字体的自然 advance 就被拉到 PDF item 的宽度。测量结果不大于 0 时保留默认 --scale-x: 1。
角度设置与宽度测量互不依赖,所以单字符跳过横向缩放并不代表跳过旋转。update 缩放时重新调 layout,也是在更新这个比例,而不是重新解析 PDF 文本。
静态测量缓存与 cleanup
共享资源的清理入口很短:
static cleanup() {
  if (this.#pendingTextLayers.size > 0) return;
  this.#ascentCache.clear();
  for (const { canvas } of this.#canvasContexts.values()) canvas.remove();
  this.#canvasContexts.clear();
}
所谓“等待 pendingTextLayers”不是返回 Promise 或阻塞,而是仍有任意 TextLayer 正在 render 时直接拒绝清理。集合全局共享,避免清掉别的页面正在使用的 context;之后需要再次调用 cleanup。WorkerTransport.destroy() 在终止流程中调用它,startCleanup() 在页面与字体等资源清理后也调用它。
cleanup 清除 ascent 与 DOM canvas,但 #canvasCtxFonts 是 WeakMap,旧 context 随 canvas/context 失去引用后由 GC 回收;#minFontSize 属于浏览器环境能力,不在这里重置。每个实例自己的 layout 参数与 styleCache 则由 capability 的 finally 释放。
#getCtx 解释了为什么缓存键包含 lang,以及为什么不用 OffscreenCanvas:
static #getCtx(lang = null) {
  let ctx = this.#canvasContexts.get((lang ||= ""));
  if (!ctx) {
    const canvas = document.createElement("canvas");
    canvas.style.cssText =
      "position:absolute;top:0;left:0;width:0;height:0;display:none;" +
      "letter-spacing:normal;word-spacing:normal";
    canvas.lang = lang;
    document.body.append(canvas);
    ctx = canvas.getContext("2d", { alpha: false, willReadFrequently: true });
    this.#canvasContexts.set(lang, ctx);
    this.#canvasCtxFonts.set(ctx, { size: 0, family: "" });
  }
  return ctx;
}
serif/sans-serif 等 generic family 的实际字体依赖 locale。Firefox 中 <html lang> 可来自 Fluent,而 OffscreenCanvas 使用 OS locale,两者不同就会量出不同字体宽度,进而破坏文本层与 canvas 的对齐。因此这里创建带正确 lang 的隐藏 DOM canvas,并按 lang || "" 缓存,而不是为了“离屏”二字选择 OffscreenCanvas。
willReadFrequently: true 是 context 创建选项;这里主要使用 measureText,并不绘制页面。隐藏 canvas 的 letter-spacing 与 word-spacing 固定为 normal,避免继承样式干扰测量。
重复赋值 ctx.font 也有成本,所以每个 context 配一份字体状态:
static #ensureCtxFont(ctx, size, family) {
  const cached = this.#canvasCtxFonts.get(ctx);
  if (size === cached.size && family === cached.family) return;
  ctx.font = `${size}px ${family}`;
  cached.size = size;
  cached.family = family;
}
只有 size 或 family 变化才重设字体。这个方法同时服务普通宽度测量与 ascent 探测,WeakMap 键正是 #getCtx 返回的 context。
最小字号同样只探测一次:
static #ensureMinFontSizeComputed() {
  if (this.#minFontSize !== null) return;
  const div = document.createElement("div");
  div.style.opacity = 0;
  div.style.lineHeight = 1;
  div.style.fontSize = "1px";
  div.style.position = "absolute";
  div.textContent = "X";
  document.body.append(div);
  this.#minFontSize = div.getBoundingClientRect().height;
  div.remove();
}
opacity: 0 只隐藏视觉,元素仍参与布局;单行 block 在 line-height: 1 下的高度反映浏览器实际采用的字号。如果请求 1px 却量到 6px,静态值就是 6,随后 CSS 用“字号乘 6、整体再乘 1/6”绕过最小字号钳制。
最后是 ascent 的三级来源:
static #getAscent(fontFamily, style, lang) {
  const cachedAscent = this.#ascentCache.get(fontFamily);
  if (cachedAscent) return cachedAscent;
  const ctx = this.#getCtx(lang);
  ctx.canvas.width = ctx.canvas.height = DEFAULT_FONT_SIZE;
  this.#ensureCtxFont(ctx, DEFAULT_FONT_SIZE, fontFamily);
  const metrics = ctx.measureText("");
  const ascent = metrics.fontBoundingBoxAscent;
  const descent = Math.abs(metrics.fontBoundingBoxDescent);
  ctx.canvas.width = ctx.canvas.height = 0;
  let ratio = 0.8;
  if (ascent) {
    ratio = ascent / (ascent + descent);
  } else {
    if (style.ascent) ratio = style.ascent;
    else if (style.descent) ratio = 1 + style.descent;
  }
  this.#ascentCache.set(fontFamily, ratio);
  return ratio;
}
优先使用浏览器 measureText("") 的 fontBoundingBoxAscent/Descent,比例是 ascent / (ascent + abs(descent))。30px 是统一探测字号,比例随后可乘任意 fontHeight;临时 canvas 尺寸用完立刻归零。
浏览器不给 ascent 时,Firefox/MOZCENTRAL 会提示开启 dom.textMetrics.fontBoundingBox.enabled。回退顺序是先 style.ascent,再用通常为非正数的 style.descent 计算 1 + descent,两者都不可用则保留 0.8。结果按 fontFamily 缓存在 #ascentCache,直到全局 cleanup。
一个文本 item 从流数据到 DOM 的完整算例与时序
下面用一个非零 viewBox 原点把关键计算串起来。假设页面 viewBox = [36, 36, 648, 756],viewport scale 为 1.5、userUnit 为 1,设备 pixelRatio 为 2;流中的 chunk 为:
const chunk = {
  lang: 'en-US',
  styles: {
    F1: { fontFamily: 'sans-serif', vertical: false, ascent: 0.8, descent: -0.2 },
  },
  items: [
    {
      str: 'PDF.js',
      dir: 'ltr',
      transform: [12, 0, 0, 12, 72, 690],
      width: 60,
      height: 12,
      fontName: 'F1',
      hasEOL: true,
    },
  ],
};
构造阶段得到 pageWidth = 612、pageHeight = 720、pageX = 36、pageY = 36,因此:
TextLayer transform = [1, 0, 0, -1, -36, 756]
scale for measurement = 1.5 * 2 = 3
tx = [12, 0, 0, -12, 36, 66]
angle = atan2(0, 12) = 0
fontHeight = hypot(0, -12) = 12
fontAscent = 12 * 0.8 = 9.6
left = 36; top = 66 - 9.6 = 56.4
left% = 100 * 36 / 612 = 5.88%
top% = 100 * 56.4 / 720 = 7.83%
这里为了突出坐标计算,ascent 取 0.8;真实运行会优先尝试浏览器 metrics。PDF.js 长度为 6,所以要测量横向宽度。若隐藏 canvas 在 36px sans-serif 下测得 108px,则目标宽度是 60 * 3 = 180px,--scale-x = 180 / 108 = 1.666666...。这个测量值只是算例,不是跨浏览器常量。
最终关键 DOM 状态等价于:
<span
  role="presentation"
  dir="ltr"
  style="left:5.88%;top:7.83%;--font-height:12.00px;
         font-family:sans-serif;--scale-x:1.6666666666666667"
  >PDF.js</span
><br role="presentation" />
span 先进入 textDivs,字符串 "PDF.js" 先进入 textContentItemsStr,随后 layout 与 append 才发生;<br> 不进入 textDivs。若 str 改为空字符串,数组里仍有对应项,也会计算几何,但这个 span 不会 append,hasEOL 仍可追加 br。
完整时序可以压缩成九步:
| 步骤 | 数据或状态变化 |
|---|---|
| 1 | streamTextContent 返回 ReadableStream;若使用 getTextContent,构造函数改为包装单 chunk 流 |
| 2 | 构造函数记录 rawDims、y 翻转矩阵、scale/rotation,并设置容器尺寸与最小字号变量 |
| 3 | render 获取 reader、加入 pendingTextLayers,启动第一次 read |
| 4 | chunk 到达,保存首个 lang、合并 styles,processItems 开始处理 |
| 5 | 普通 item 的 str 与新建 span 分别进入两个公共数组 |
| 6 | appendText 计算 tx、angle、ascent、百分比位置和目标宽度 |
| 7 | layout 在对应 lang 的 DOM canvas 上测宽,写 --scale-x 与必要的 --rotate |
| 8 | hasText 的 span 被 append,hasEOL 追加 br,pump 发起下一次 read |
| 9 | done 后 resolve;finally 移出 pending 并释放实例级测量暂存,DOM 与两个数组保留 |
当缩放变为 2 时,update 把 #scale 改为 4,并重测 48px sans-serif 与新的目标宽度;left/top/fontHeight 仍沿用上面的页面坐标。当只有 rotation 改变时,则只更新根容器旋转属性。Canvas 的字形渲染与这条文本流是并行协作的两条路径,对齐来自同一份页面几何,而不是文本层读取 canvas 像素。
设计要点
- 流式是默认路径,一次性对象只是适配器。 getTextContent 聚合同一条流,TextLayer 又把聚合对象包回单 chunk 流,因此 DOM 生成只有一套 pump、一套样式合并和一套错误路径。
- 页面坐标与视口状态分离。 span 保存 rawDims 下的百分比坐标,缩放与旋转交给外层;只有依赖实际字体测量的
--scale-x在 scale 改变时重算。 - 基线对齐比“画一个字”更重要。 y 翻转、矩阵第二列求 fontHeight、角度法线偏移和 ascent 比例共同保证透明 DOM 与 canvas 使用同一基线。
- 结构保真与视觉布局解耦。 markedContent 用
display: contents保留嵌套和 Artifact 的 ariaHidden,普通 span 用 presentation 降低屏幕阅读器碎片化,EOL 用独立 br 表达。 - 性能优化都带有正确性例外。 100000 阈值防止 DOM 失控,单字符通常跳过测宽但保留 1.5 倍差异例外,字体状态用 WeakMap 去重,ascent 与 context 跨页共享。
- 测量环境也是正确性的一部分。 按 lang 使用 DOM canvas 而非 OffscreenCanvas,是为了让 generic family 的 locale 与文档一致;浏览器最小字号探测则避免 CSS 钳制悄悄改变文本几何。
- 全局缓存需要全局生命周期保护。 pendingTextLayers 让 cleanup 在任何活动渲染期间退让;实例暂存与静态缓存分别由 finally 和 cleanup 释放,职责不混在一起。
- TextLayer 是能力底座,不是功能大全。 浏览器基于透明 DOM 提供选择与复制,外部消费者基于 textDivs/textContentItemsStr 构建其他能力;搜索、高亮与图片右键都不应混进这套文本几何核心。
总结
text_layer.js 的核心不是“把字符串塞进 span”,而是把 Worker 已求值的文本几何翻译成浏览器原生可选、可复制、可被辅助技术理解的 DOM 结构,并让它与 Canvas 的字形保持同一页面坐标。
构造函数统一两种文本来源,render 以递归 Promise pump 消费流,processItems 维护结构容器,appendText 负责基线与角度,layout 负责宽度校正,update/cancel/cleanup 则覆盖复用、中止与共享资源回收。理解这条链,就能读懂整个文本层闭环。
| 问题 | TextLayer 的回答 |
|---|---|
| 文本从哪里来 | streamTextContent 的流,或 getTextContent 的聚合对象 |
| 为什么能选择复制 | canvas 之上有真实但透明的 DOM 文本节点 |
| 为什么能与字形对齐 | rawDims + y 翻转 + ascent/angle + measureText/scaleX |
| 如何适应缩放旋转 | 百分比定位与外层尺寸;update 分开处理旋转和测量缩放 |
| 如何控制成本 | 流式 pump、textDiv 阈值、单字符测量例外与分层缓存 |
| 如何保留语义结构 | markedContent 容器栈、Artifact ariaHidden、dir 与 EOL |
这也是渲染分层的另一端:Canvas 负责视觉像素,TextLayer 负责文本几何与 DOM 语义。二者都不承担对方的工作,却通过同一份 PDF 页面模型完成一次完整的阅读体验。
StreamPDF 的设计原则: 能前置处理的绝对不放到解析的时候才做, 由服务端一次解决所有性能问题. 浏览器只获取&渲染必须数据.
相关文章
- PDF.js 从 demo 深入浅出 10: CanvasGraphics 与 operatorList 绘制2026年10月27日
- PDF.js 从 demo 深入浅出 9: 网络流与 Range 请求2026年10月27日
- PDF.js 从 demo 深入浅出 8: PDFWorker.create 与真假 Worker 握手2026年10月27日
- PDF.js 从 demo 深入浅出 7: WorkerTransport 初始化2026年10月27日
- PDF.js 从 demo 深入浅出 6: MessageHandler 跨线程通讯2026年10月27日
- PDF.js 从 demo 深入浅出 5: render 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 4: getViewport 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 3: getPage 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 2: getDocument 方法全貌2026年10月27日
- PDF.js 源码解读: font_loader2026年10月27日
- PDF.js 源码解读: obj_bin_transform_display2026年10月27日
- PDF.js 源码解读: PDFObjects2026年10月27日
- PDF.js 源码解读: 网络流2026年10月27日
- PDF.js 源码解读: internal_evt.js2026年10月27日
- PDF.js 源码解读: math_clamp.js2026年10月27日
- PDF.js 源码解读: css_utils.js2026年10月27日
- PDF.js 源码解读: scripting_utils2026年10月27日
- PDF.js 源码解读: MurmurHash3_642026年10月27日
- PDF.js 源码解读: obj_bin_transform_utils2026年10月27日
- PDF.js 源码解读: image_utils.js2026年10月27日
- PDF.js 源码解读: BasePDFStream2026年10月27日
- PDF.js 源码解读: 共享工具层2026年10月27日
- PDF.js 源码解读: MessageHandler2026年10月27日
- PDF.js 源码解读: api2026年10月27日
- PDF.js 源码解读: fonts2026年10月27日
- PDF.js 源码解读: glyphlist2026年10月27日
- PDF.js 源码解读: binary_cmap2026年10月27日
- PDF.js 源码解读: cmap2026年10月27日
- PDF.js 源码解读: encodings2026年10月27日
- PDF.js 源码解读: metrics2026年10月27日
- PDF.js 源码解读: standard_fonts2026年10月27日
- PDF.js 源码解读: fonts_utils2026年10月27日
- PDF.js 源码解读: default_appearance2026年10月27日
- PDF.js 源码解读: metadata_parser2026年10月27日
- PDF.js 源码解读: name_number_tree2026年10月27日
- PDF.js 源码解读: struct_tree2026年10月27日
- PDF.js 源码解读: catalog2026年10月27日
- PDF.js 源码解读: pdf_manager2026年10月27日
- PDF.js 源码解读: object_loader2026年10月27日
- PDF.js 源码解读: obj_bin_transform_core2026年10月27日
- PDF.js 源码解读: crypto2026年10月27日
- PDF.js 源码解读: core_utils2026年10月27日
- PDF.js 源码解读: primitives2026年10月27日
- PDF.js 源码解读: worker_stream2026年10月27日
- PDF.js 源码解读: ccitt_stream2026年10月27日
- PDF.js 源码解读: jpx_stream2026年10月27日
- PDF.js 源码解读: jbig2_stream2026年10月27日
- PDF.js 源码解读: jpeg_stream2026年10月27日
- PDF.js 源码解读: decrypt_stream2026年10月27日
- PDF.js 源码解读: brotli_stream2026年10月27日
- PDF.js 源码解读: run_length_stream2026年10月27日
- PDF.js 源码解读: ascii_hex_stream2026年10月27日
- PDF.js 源码解读: ascii_85_stream2026年10月27日
- PDF.js 源码解读: lzw_stream2026年10月27日
- PDF.js 源码解读: predictor_stream2026年10月27日
- PDF.js 源码解读: flate_stream2026年10月27日
- PDF.js 源码解读: decode_stream2026年10月27日
- PDF.js 源码解读: chunked_stream2026年10月27日
- PDF.js 源码解读: stream2026年10月27日
- PDF.js 源码解读: base_stream2026年10月27日
- PDF.js 深入浅出 11: Parser2026年10月26日
- PDF.js 深入浅出 10: XRef2026年10月26日
- PDF.js 深入浅出 9: CanvasGraphics2026年10月26日
- PDF.js 深入浅出 8: Document 与 Page2026年10月26日
- AI 时代, 我们到底应该做什么才能活下去(StreamPDF 创立有感)2026年10月26日
- PDF.js 深入浅出 7: PartialEvaluator2026年10月25日
- PDF.js 深入浅出 6: PDFManager.initDocument2026年10月25日
- PDF.js 深入浅出 5: PDFFetchStream 和 PDFWorkerStream2026年10月25日
- PDF.js 深入浅出 4: MessageHandler2026年10月22日
- PDF.js 深入浅出 3: getViewport & render2026年10月22日
- PDF.js 从 demo 深入浅出 1: 自定义 viewer 渲染 PDF2026年10月19日
- PDF.js 深入浅出 2: getDocument & getPage2026年10月19日
- PDF.js 深入浅出 1: PDF.js 的架构设计2026年10月16日