
PDF.js 从 demo 深入浅出 9: 网络流与 Range 请求
2026年10月27日 · StreamPDF Team
前言
第 7 篇已经走到 GetReader: worker 通过 PDFWorkerStream 向主线程索取 PDF 字节, 主线程创建 PDFFetchStreamReader 发起 fetch. 当时留下了两个问题:
ReaderHeadersReady返回的isRangeSupported是怎么算出来的?- worker 需要某个偏移区间时,
GetRangeReader什么时候会真正产生 HTTP Range 请求?
本篇继续跟随 demo 的实际值:
url = "https://assets.streampdf.com/PDF32000_2008.pdf";
rangeChunkSize = 65536; // 64KB
disableRange = false;
disableStream = false;
disableAutoFetch = false;
demo 服务器的响应已经确认支持 Range. 因此本文走的是渐进全量流 + 按需 Range 并行的路径, 而不是一次性下载整个文件, 也不是中止全量流后只发 Range 请求.
四种网络流实现与完整校验函数见网络流源码解读. 本篇只聚焦 demo 实际经过的
PDFFetchStream → PDFWorkerStream → NetworkPdfManager → ChunkedStreamManager调用链.
ReaderHeadersReady: range 能力探测
第 1 步, 全量 reader 先发起普通 GET
worker 的 PDFWorkerStreamReader 发送 GetReader 后, 主线程执行:
this.#fullReader = this.#networkStream.getFullReader();demo 的 networkStream 是 PDFFetchStream, 因此这里创建 PDFFetchStreamReader. 它的构造函数发出第一个请求:
fetch(url, {
  method: "GET",
  headers, // 没有 Range 头
  signal: this._abortController.signal,
  mode: "cors",
  credentials: "same-origin", // withCredentials = false
  redirect: "follow",
});
这是一个普通的全量 GET. 此时 PDF.js 还不知道服务器是否支持 Range, 必须先拿到响应头.
第 2 步, 响应头提供探测依据
demo URL 的关键响应头为:
HTTP/2 200
content-type: application/pdf
content-length: 22491828
accept-ranges: bytes
响应没有 content-encoding, 按校验逻辑视为 identity.
PDFFetchStreamReader 随后取得:
this._reader = response.body.getReader();
this._contentLength = 22491828;
this._isStreamingSupported = true;  // !disableStream
this._isRangeSupported = false;     // 等待校验
response.body.getReader() 说明全量响应可以按块读取. 是否继续保留这条流, 还要看 range 能力与 disableStream 的组合.
第 3 步, 五道闸门全部通过
validateRangeRequestCapabilities 决定 _isRangeSupported. 代入 demo 的实际响应:
| 校验 | demo 的值 | 结果 |
|---|---|---|
Content-Length 必须是整数 | 22491828 | 通过, 同时得到 contentLength |
文件必须大于 2 * rangeChunkSize | 22491828 > 131072 | 通过 |
| 用户未禁 range, 且是 http(s) | disableRange = false, HTTPS | 通过 |
Accept-Ranges 必须为 bytes | bytes | 通过 |
Content-Encoding 必须为 identity | 响应头缺失, 按 identity | 通过 |
因此:
this._contentLength = 22491828;
this._isRangeSupported = true;第二个闸门就是第 2 篇的 64KB 伏笔第一次生效: 文件必须大于两个 chunk, 才值得放弃简单全量下载、启用 range 管理.
注意
disableRange = false只是「允许使用 range」, 不是「强制使用 range」. 真正决定能力的是响应头与文件长度.
第 4 步, demo 不取消全量流
fetch 实现中只有下面这个条件成立, 才会取消全量 reader:
if (!this._isStreamingSupported && this._isRangeSupported) {
  this.cancel(new AbortException("Streaming is disabled."));
}
demo 中:
this._isStreamingSupported = true;
this._isRangeSupported = true;
!this._isStreamingSupported 为 false, 所以不取消. 全量流会继续从文件头向文件尾送数据; 后续的 Range 请求负责补上解析器立刻需要、但全量流尚未送到的区域.
最后, reader resolve headersReady. 主线程的 ReaderHeadersReady 处理器返回:
{
  isStreamingSupported: true,
  isRangeSupported: true,
  contentLength: 22491828,
}
两个能力值都为 true 时, 主线程还会把 fullReader.onProgress 置空, 后续下载进度改由 worker 的 DocProgress 按已加载 chunk 汇报.
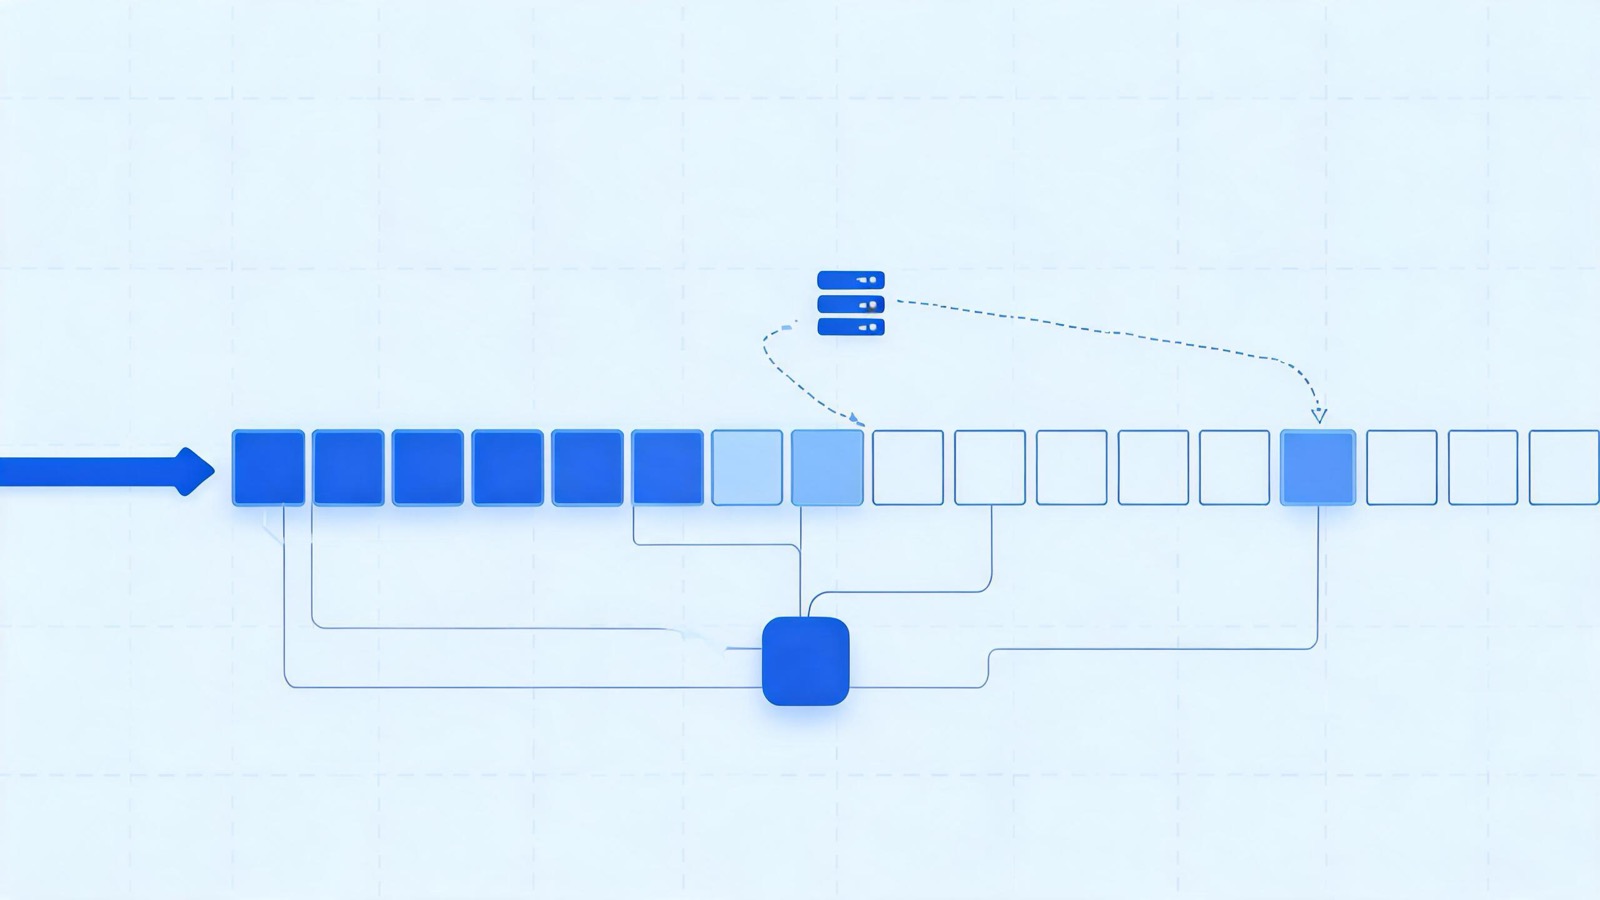
NetworkPdfManager: 把文件切成 344 块
第 5 步, worker 根据能力值选择管理器
worker 侧的 PDFWorkerStreamReader 收到上述三项能力值后, resolve 自己的 headersReady. getPdfManager 进入 range 分支:
pdfManagerArgs.source = pdfStream;
pdfManagerArgs.length = 22491828;
pdfManagerArgs.disableAutoFetch ||= fullReader.isStreamingSupported;
// false ||= true → true

newPdfManager = new NetworkPdfManager(pdfManagerArgs);
如果服务器不支持 range, 这里不会创建 NetworkPdfManager; worker 会等全量流读完后, 用完整字节创建 LocalPdfManager. demo 则走网络管理器.
还有一个容易错过的赋值:
disableAutoFetch = true;它并不关闭全量流, 而是禁止 ChunkedStreamManager 在每次收块后再自动预取其他空缺 chunk. 因为 demo 的渐进全量流本来就在持续供数, 再自动发 Range 预取会造成重复下载.
第 6 步, 22,491,828 字节切成 344 个 chunk
NetworkPdfManager 创建 ChunkedStreamManager, 后者建立:
this.chunkSize = 65536;
this.stream = new ChunkedStream(22491828, 65536, this);
this.disableAutoFetch = true;
ChunkedStream 预分配完整地址空间, 并计算 chunk 数:
this.bytes = new Uint8Array(22491828);
this.numChunks = Math.ceil(22491828 / 65536); // 344
this._loadedChunks = new Set();               // 初始为空
this.progressiveDataLength = 0;
最后一个 chunk 不是完整的 64KB:
| chunk | 起始偏移 | 结束偏移 [begin, end) | 长度 |
|---|---|---|---|
0 | 0 | 65536 | 65536 |
1 | 65536 | 131072 | 65536 |
... | ... | ... | ... |
343 | 22478848 | 22491828 | 12980 |
bytes 只是完整长度的容器, 不代表数据已经下载. _loadedChunks 才记录哪些区域真正有字节.
第 7 步, 两条数据通道汇入同一个 chunk 仓库
demo 同时存在两条供数路径:
| 路径 | 触发方式 | 写入方式 |
|---|---|---|
| 渐进全量流 | worker 持续 fullReader.read() | 从 progressiveDataLength 位置顺序写入 |
| 按需 Range | 解析器遇到缺失区域 | 按请求的 begin 偏移写入 |
全量流的数据到达 NetworkPdfManager 后:
sendProgressiveData(chunk) {
  this.streamManager.onReceiveData({ chunk }); // 没有 begin
}
ChunkedStreamManager 看到 begin === undefined, 就按渐进数据写入:
const position = stream.progressiveDataLength;
stream.onReceiveProgressiveData(chunk);
// 写入 bytes[position...], 更新 progressiveDataLength 与 _loadedChunks
Range 数据则带明确的 begin, 走 stream.onReceiveData(begin, chunk). 两条路径最终共享同一个 bytes 与 _loadedChunks, 解析器不需要关心数据来自哪条通道.
缺失字节如何变成 Range 请求
第 8 步, 解析器读到空缺 chunk 就抛 MissingDataException
PDFDocument 解析时通过 ChunkedStream 读取字节. 对渐进全量流已经覆盖的区域, 可以直接读:
ensureRange(begin, end) {
  if (end <= this.progressiveDataLength) {
    return;
  }
  // 否则逐 chunk 检查 _loadedChunks
}
如果目标区域超出渐进数据, 也不是立即读网络, 而是先检查 _loadedChunks——所需区域可能早已通过另一次 Range 请求到达.
仍缺数据时, 抛出:
throw new MissingDataException(begin, end);这里抛出的是「当前解析需要哪个字节区间」, 还不是 HTTP 请求. 例如解析 xref 时需要文件尾部, 而渐进流只到达文件前部, 就会产生这样的异常.
第 9 步, NetworkPdfManager 补块后重试原操作
NetworkPdfManager.ensure 是所有文档级读取的统一入口之一:
async ensure(obj, prop, args) {
  try {
    const value = obj[prop];
    if (typeof value === "function") {
      return await value.apply(obj, args);
    }
    return value;
  } catch (ex) {
    if (!(ex instanceof MissingDataException)) {
      throw ex;
    }
    await this.requestRange(ex.begin, ex.end);
    return this.ensure(obj, prop, args);
  }
}
它只捕获 MissingDataException:
- 请求缺失区间;
- 等待区间对应的 chunk 到齐;
- 重新执行原来的
obj[prop]; - 其他异常照常抛出, 不用网络重试掩盖真正的解析错误.
第 7 篇的 pdfManager.initDocument() 内部多次经过 ensureDoc, 而 ensureDoc 最终复用这套 ensure 逻辑, 所以文档初始化期间的缺块也走同一条路径.
第 10 步, 字节区间对齐到 64KB chunk
requestRange(begin, end) 先把区间换算成 chunk 编号:
end = Math.min(end, 22491828);
const beginChunk = Math.floor(begin / 65536);
const endChunk = Math.floor((end - 1) / 65536) + 1;
因此 Range 请求不是按异常里的任意字节数原样发送, 而是向外对齐到 64KB 边界.
_requestChunks 接着做三件事:
- 去掉已经加载的 chunk;
- 通过
_requestsByChunk合并并发请求, 同一个 chunk 不重复下载; - 用
groupChunks把连续 chunk 合成较少的大区间.
const begin = groupedChunk.beginChunk * 65536;
const end = Math.min(groupedChunk.endChunk * 65536, 22491828);
this.sendRequest(begin, end);
所以一次 HTTP Range 可能只有 64KB, 也可能包含多个连续 chunk. 若只请求最后一个 chunk, 则:
begin = 343 * 65536 = 22478848;
end = Math.min(344 * 65536, 22491828) = 22491828;
GetRangeReader: 何时真正发 HTTP 请求
第 11 步, worker 发起 GetRangeReader 流消息
ChunkedStreamManager.sendRequest(begin, end) 调用:
const rangeReader = this.pdfStream.getRangeReader(begin, end);这里的 pdfStream 是 worker 侧的 PDFWorkerStream. 它创建 range reader 时发送:
const readableStream = msgHandler.sendWithStream("GetRangeReader", {
  begin,
  end,
});
this._reader = readableStream.getReader();
到目前仍然没有新的 HTTP 请求. GetRangeReader 只是跨线程索取一个区间 reader, 是否访问网络由主线程判断.
第 12 步, 主线程先检查全量流是否已经覆盖
主线程的 GetRangeReader 处理器调用基类方法:
const rangeReader = this.#networkStream.getRangeReader(data.begin, data.end);BasePDFStream.getRangeReader 的第一段逻辑是:
if (end <= this._progressiveDataLength) {
  return null;
}
这里的 _progressiveDataLength 来自主线程 PDFFetchStreamReader._loaded, 表示全量响应已经下载到主线程的字节数.
如果 [begin, end) 已全部落在其中, 说明数据即使还没完全送到 worker, 也会随全量流到达, 没必要再发 HTTP Range. 主线程处理 null 的方式是:
if (!rangeReader) {
  sink.close();
  return;
}
worker 的 range reader 随即读到 done = true, chunks.length === 0; demo 的 disableAutoFetch = true, 所以 sendRequest 直接返回, 等渐进流补齐这块数据.
这是第一处防重复: 主线程已经下载的数据, 不再通过 Range 重复请求.
第 13 步, 未覆盖时才添加 Range 头
如果 end > _progressiveDataLength, 主线程创建 PDFFetchStreamRangeReader:
const headers = new Headers(stream.headers);
headers.append("Range", `bytes=${begin}-${end - 1}`);
fetchUrl(url, headers, withCredentials, this._abortController);
end 在 PDF.js 内部是开区间上界, HTTP Range 是闭区间, 所以请求头使用 end - 1.
以第一个 chunk 为例:
GET /PDF32000_2008.pdf
Range: bytes=0-65535
demo 服务器实际返回:
HTTP/2 206
content-length: 65536
content-range: bytes 0-65535/22491828
若请求最后一个 chunk, 对应请求头则是:
Range: bytes=22478848-22491827range reader 还会比较这次响应的最终 origin 与全量响应记录的 origin, 防止重定向到不同源后, 字节偏移语义发生变化.
第 14 步, Range 字节经流通道返回 worker
主线程同样通过 sink.onPull 读取 range reader:
sink.onPull = () => {
  rangeReader.read().then(({ value, done }) => {
    if (done) {
      sink.close();
      return;
    }
    sink.enqueue(new Uint8Array(value), 1, [value]);
  });
};
worker 的 ChunkedStreamManager.sendRequest 持续读到 done, 将可能分成多帧的响应合并:
const data = arrayBuffersToBytes(chunks);
this.onReceiveData({ chunk: data.buffer, begin });
随后 ChunkedStream 校验偏移、写入共享容器并登记 chunk:
this.bytes.set(new Uint8Array(chunk), begin);
this._loadedChunks.add(curChunk);
等待这个区间的 promise 只有在所需 chunk 全部到齐后才 resolve. 第 9 步的 ensure 随后重试原解析操作, 这次 ensureRange 成功, 解析继续.
由于 demo 的 disableAutoFetch = true, 收块后不会再自动预取下一个空缺 chunk. 下一次 Range 仍由解析器的下一次真实缺块触发.
三层去重, 让两条通道安全并行
渐进流与 Range 并行看似简单, 但要避免重复下载, 需要三层检查:
| 层级 | 检查 | 避免的问题 |
|---|---|---|
ChunkedStream.ensureRange | _loadedChunks 是否已有目标 chunk | 已写入 worker 的数据不重复请求 |
ChunkedStreamManager._requestChunks | _requestsByChunk 是否已有在途请求 | 多个解析任务不重复下载同一 chunk |
BasePDFStream.getRangeReader | 主线程全量流是否已覆盖 end | 已下载但尚未送到 worker 的数据不重复走 HTTP |
完整闭环可以压缩成:
解析器读取缺失字节
  → MissingDataException(begin, end)
  → NetworkPdfManager.ensure 捕获
  → 对齐并合并 64KB chunk
  → PDFWorkerStream 发 GetRangeReader
  → 主线程检查全量流覆盖情况
      已覆盖 → sink.close, 等渐进数据
      未覆盖 → fetch(Range: bytes=begin-end-1)
  → Range 数据返回 worker
  → 写入 bytes + _loadedChunks
  → requestRange promise resolve
  → 重试原解析操作
为什么文档就绪不必等 344 块全部下载
第 7 篇已经看到, GetDoc 只要求 pdfManager.initDocument() 与文档级元数据读取成功. 在 range 模式下, 这些操作只需要文件头、xref、页树等相关区域, 不需要 344 个 chunk 全部到位.
因此 demo 可以出现:
全量流仍在后台顺序下载
  + 解析器通过少量 Range 补齐关键区域
  → GetDoc 先到达
  → loadingTask.promise 先 resolve
  → 用户可以 getPage(1) 并开始渲染
  → 其余 chunk 之后继续到达
  → 全部加载后才发送 DataLoaded
这正是 GetDoc 与 DataLoaded 分离的意义: 可解析、可操作的文档就绪, 不必等于完整文件下载就绪.
总结
本篇沿 demo 的真实响应走完了网络流与 Range 请求:
GetReader先创建全量PDFFetchStreamReader, 发出不带 Range 的普通 GET;- 响应给出
content-length: 22491828与accept-ranges: bytes, 五道校验全部通过; - demo 的 streaming 与 range 同时受支持, 全量流不会取消;
- worker 创建
NetworkPdfManager, 将文件按 64KB 切成 344 个 chunk; disableAutoFetch因 streaming 开启而变为true, 避免在渐进供数之外重复预取;- 渐进全量流与 Range 数据写入同一个
ChunkedStream, 共享bytes与_loadedChunks; - 解析器遇到缺块时抛出
MissingDataException,NetworkPdfManager.ensure请求数据后重试; - 缺失字节区间先对齐到 chunk, 再去重、合并连续区间;
- 主线程仅对全量流尚未覆盖的区间创建
PDFFetchStreamRangeReader, 添加Range: bytes=begin-end-1; - Range 数据到齐后重试解析,
GetDoc无需等待整个文件下载完成.
至此, 第 2 篇留下的四个「重角色」都已沿 demo 展开: PDFWorker、MessageHandler、WorkerTransport, 以及网络流的 range 请求策略. 第 10 篇继续沿第 5 篇的渲染链向下, 展开消费 operatorList 的 CanvasGraphics.
StreamPDF 的设计原则: 能前置处理的绝对不放到解析的时候才做, 由服务端一次解决所有性能问题. 浏览器只获取&渲染必须数据.
相关文章
- PDF.js 从 demo 深入浅出 10: CanvasGraphics 与 operatorList 绘制2026年10月27日
- PDF.js 从 demo 深入浅出 8: PDFWorker.create 与真假 Worker 握手2026年10月27日
- PDF.js 从 demo 深入浅出 7: WorkerTransport 初始化2026年10月27日
- PDF.js 从 demo 深入浅出 6: MessageHandler 跨线程通讯2026年10月27日
- PDF.js 从 demo 深入浅出 5: render 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 4: getViewport 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 3: getPage 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 2: getDocument 方法全貌2026年10月27日
- PDF.js 源码解读: TextLayer2026年10月27日
- PDF.js 源码解读: font_loader2026年10月27日
- PDF.js 源码解读: obj_bin_transform_display2026年10月27日
- PDF.js 源码解读: PDFObjects2026年10月27日
- PDF.js 源码解读: 网络流2026年10月27日
- PDF.js 源码解读: internal_evt.js2026年10月27日
- PDF.js 源码解读: math_clamp.js2026年10月27日
- PDF.js 源码解读: css_utils.js2026年10月27日
- PDF.js 源码解读: scripting_utils2026年10月27日
- PDF.js 源码解读: MurmurHash3_642026年10月27日
- PDF.js 源码解读: obj_bin_transform_utils2026年10月27日
- PDF.js 源码解读: image_utils.js2026年10月27日
- PDF.js 源码解读: BasePDFStream2026年10月27日
- PDF.js 源码解读: 共享工具层2026年10月27日
- PDF.js 源码解读: MessageHandler2026年10月27日
- PDF.js 源码解读: api2026年10月27日
- PDF.js 源码解读: fonts2026年10月27日
- PDF.js 源码解读: glyphlist2026年10月27日
- PDF.js 源码解读: binary_cmap2026年10月27日
- PDF.js 源码解读: cmap2026年10月27日
- PDF.js 源码解读: encodings2026年10月27日
- PDF.js 源码解读: metrics2026年10月27日
- PDF.js 源码解读: standard_fonts2026年10月27日
- PDF.js 源码解读: fonts_utils2026年10月27日
- PDF.js 源码解读: default_appearance2026年10月27日
- PDF.js 源码解读: metadata_parser2026年10月27日
- PDF.js 源码解读: name_number_tree2026年10月27日
- PDF.js 源码解读: struct_tree2026年10月27日
- PDF.js 源码解读: catalog2026年10月27日
- PDF.js 源码解读: pdf_manager2026年10月27日
- PDF.js 源码解读: object_loader2026年10月27日
- PDF.js 源码解读: obj_bin_transform_core2026年10月27日
- PDF.js 源码解读: crypto2026年10月27日
- PDF.js 源码解读: core_utils2026年10月27日
- PDF.js 源码解读: primitives2026年10月27日
- PDF.js 源码解读: worker_stream2026年10月27日
- PDF.js 源码解读: ccitt_stream2026年10月27日
- PDF.js 源码解读: jpx_stream2026年10月27日
- PDF.js 源码解读: jbig2_stream2026年10月27日
- PDF.js 源码解读: jpeg_stream2026年10月27日
- PDF.js 源码解读: decrypt_stream2026年10月27日
- PDF.js 源码解读: brotli_stream2026年10月27日
- PDF.js 源码解读: run_length_stream2026年10月27日
- PDF.js 源码解读: ascii_hex_stream2026年10月27日
- PDF.js 源码解读: ascii_85_stream2026年10月27日
- PDF.js 源码解读: lzw_stream2026年10月27日
- PDF.js 源码解读: predictor_stream2026年10月27日
- PDF.js 源码解读: flate_stream2026年10月27日
- PDF.js 源码解读: decode_stream2026年10月27日
- PDF.js 源码解读: chunked_stream2026年10月27日
- PDF.js 源码解读: stream2026年10月27日
- PDF.js 源码解读: base_stream2026年10月27日
- PDF.js 深入浅出 11: Parser2026年10月26日
- PDF.js 深入浅出 10: XRef2026年10月26日
- PDF.js 深入浅出 9: CanvasGraphics2026年10月26日
- PDF.js 深入浅出 8: Document 与 Page2026年10月26日
- AI 时代, 我们到底应该做什么才能活下去(StreamPDF 创立有感)2026年10月26日
- PDF.js 深入浅出 7: PartialEvaluator2026年10月25日
- PDF.js 深入浅出 6: PDFManager.initDocument2026年10月25日
- PDF.js 深入浅出 5: PDFFetchStream 和 PDFWorkerStream2026年10月25日
- PDF.js 深入浅出 4: MessageHandler2026年10月22日
- PDF.js 深入浅出 3: getViewport & render2026年10月22日
- PDF.js 从 demo 深入浅出 1: 自定义 viewer 渲染 PDF2026年10月19日
- PDF.js 深入浅出 2: getDocument & getPage2026年10月19日
- PDF.js 深入浅出 1: PDF.js 的架构设计2026年10月16日