
PDF.js 源码解读: font_loader
2026年10月27日 · StreamPDF Team
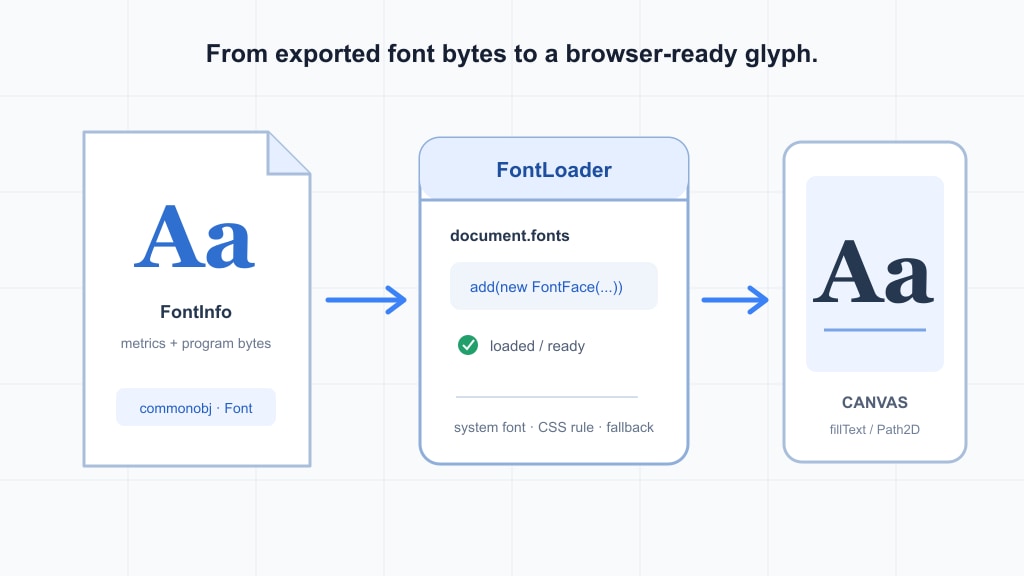
前言
上一篇 core/fonts.js 走到 Worker 的终点:PDF 字体字典、嵌入字体程序、编码与度量已经被整理成统一的 Font,再由 exportData() 导出。obj_bin_transform_display.js 则负责把跨线程字节重新解释成 FontInfo、CssFontInfo、SystemFontInfo 与 FontPathInfo。
但字体字节到达主线程,并不等于 Canvas 已经能使用它。浏览器还需要注册字体、等待加载、处理缺失字体,并在某些绘制模式下拿到独立的字形轮廓。src/display/font_loader.js(599 行)正是这段「数据已经翻译完成,但浏览器尚未准备好」的适配层。
一句话概括:**FontLoader 管理字体与 DOM 的关系,FontFaceObject 管理 Worker 字体数据与 Canvas 渲染的关系。**前者面对 FontFace、document.fonts、样式表和旧浏览器探测;后者面对度量、状态、Path2D 与资源释放。
版本说明:本篇严格按当前仓库源码展开。文件只导出
FontLoader与FontFaceObject;现代路径使用 Font Loading API,旧路径仍有@font-face、测试字体与轮询代码。不要把attached理解为「加载成功」,也不要把探测字体的 30 次轮询理解成业务字体加载失败后的自动重试。
模块总览
文件可以分成两条相互协作的主线:
| 区块 | 关键成员 | 职责 |
|---|---|---|
| 装载器状态 | #systemFonts、nativeFontFaces、#styleSheet | 记录系统字体、原生 FontFace 与规则容器 |
| DOM 注册 | addNativeFontFace、removeNativeFontFace、insertRule | 操作 document.fonts 与 CSS 样式表 |
| 资源清理 | clear | 移除字体、清空去重状态、卸载样式表 |
| 系统字体 | loadSystemFont | 装载 Worker 选择的系统字体替代项 |
| 统一入口 | bind | 按 attached、缺失文件、能力支持选择路径 |
| 能力判断 | isFontLoadingAPISupported、isSyncFontLoadingSupported | 区分现代、同步与旧式异步加载 |
| 旧式异步探测 | _queueLoadingCallback、_loadTestFont、_prepareFontLoadEvent | 排队完成回调,用测试字体猜测加载结束 |
| 字体对象 | FontFaceObject 构造函数与两个 create* 方法 | 包装 FontInfo,创建 FontFace 或 @font-face |
| 内置字形渲染 | getPathGenerator | 把 FontPathInfo 编译并缓存为 Path2D |
| 渲染数据接口 | 代理 getter、disableFontFace setter、clearData | 向 Canvas 暴露状态与度量,并释放大对象 |
把它接上前两篇文章,完整链路是:
// Worker: Font.exportData()
//   → TranslatedFont.send(): commonobj [loadedName, "Font", fontData]
// Main thread: new FontInfo(exportedData)
//   → new FontFaceObject(fontData, ...)
//   → FontLoader.bind(font)
//       → FontFace + document.fonts       (modern path)
//       → @font-face + test-font polling  (legacy path)
//   → commonObjs.resolve(loadedName, font)
// CanvasGraphics: commonObjs.get(fontRefName)
//   → ctx.font / fillText / strokeText
// → font.getPathGenerator(...) → Path2D (built-in outlines)这里有两组名字不要混淆。loadedName 是 PDF.js 为文档内字体生成的装载名,同时充当 commonObjs 的对象 id 和通常情况下的 CSS 字体名;name 则来自 PDF 字体本身。cssFontInfo.fontFamily 又可能来自 PDF 文档,因此进入 CSS 前必须序列化,不能与内部生成的 loadedName 一视同仁。
从 Worker 导出到主线程对象
TranslatedFont.send:一次性发送字体主体
Worker 侧 TranslatedFont 用 #sent 保证同一字体主体只发送一次:
send(handler) {
  if (this.#sent) {
    return;
  }
  this.#sent = true;

  const fontData = this.font.exportData(),
    transfers = fontData.buffer ? [fontData.buffer] : null;

  handler.send("commonobj", [this.loadedName, "Font", fontData], transfers);
}
fontData.buffer 被放进 transfer list,避免复制整块字体数据。消息里的 loadedName 是主线程对象 id,"Font" 决定 commonobj 路由分支,第三项包含二进制 buffer、Type3 的 charProcOperatorList 和可选 extra。
这与 core/fonts.js 的 exportData() 正好衔接:Worker 已完成字体修复、包装、编码与度量计算;主线程不再解释 TrueType 或 CFF 表,而是消费一份稳定的导出结果。
FontInfo:按需读取,而不是展开成大对象
FontInfo 构造时保存 ArrayBuffer 与 DataView,并把可选 extra 展开到实例;核心导出字段仍按需读取。布尔值按两位一个字段读取,数字、数组、字符串各有固定布局;cssFontInfo 与 systemFontInfo 在 getter 被访问时才从相应区段重建。对字体装载最关键的是 data 与 clearData():
get data() {
  const { offset, length } = this.#getDataOffsets();
  return length === 0
    ? undefined
    : new Uint8Array(this.#buffer, offset + 4, length);
}

clearData() {
  const { offset, length } = this.#getDataOffsets();
  if (length === 0) {
    return;
  }
  this.#view.setUint32(offset, 0);

  this.#buffer = new Uint8Array(this.#buffer, 0, offset + 4).slice().buffer;
  this.#view = new DataView(this.#buffer);
}
#getDataOffsets() 依次越过字符串区、系统字体信息区和 CSS 字体信息区,最后定位字体程序长度。data 只是原 buffer 上的一个 Uint8Array 视图;长度为零时返回 undefined,所以「没有可嵌入字体」和「数据已经清掉」在这个 getter 上表现相同。
clearData() 先把数据长度写零,再复制并保留数据块之前的前缀。这样身份、度量、CSS 与系统字体信息仍然可读,可能达到数 MB 的字体程序却不再驻留。重复调用是安全的,因为第二次看到的长度已经是零。
systemFontInfo 提供 css、loadedName、baseFontName、src、style;cssFontInfo 提供 fontFamily、fontWeight、italicAngle。前者描述系统字体替代与 CSS 使用方式,后者描述创建原生字体规则时需要的家族和字形样式。
commonobj 的 Font 分支:装载流程收尾后才发布对象
api.js 在 WorkerTransport 上创建唯一的 commonObjs = new PDFObjects() 与 fontLoader = new FontLoader(...)。收到字体消息后,关键代码如下:
case "Font":
  if ("error" in exportedData) {
    const exportedError = exportedData.error;
    warn(`Error during font loading: ${exportedError}`);
    this.commonObjs.resolve(id, exportedError);
    break;
  }

  const fontData = new FontInfo(exportedData);
  const inspectFont =
    this._params.pdfBug && globalThis.FontInspector?.enabled
      ? (font, url) => globalThis.FontInspector.fontAdded(font, url)
      : null;
  const font = new FontFaceObject(
    fontData,
    inspectFont,
    exportedData.charProcOperatorList,
    exportedData.extra
  );

  this.fontLoader
    .bind(font)
    .catch(() => messageHandler.sendWithPromise("FontFallback", { id }))
    .finally(() => {
      if (!font.fontExtraProperties) {
        font.clearData();
      }
      this.commonObjs.resolve(id, font);
    });
  break;
如果 Worker 导出的是 ErrorFont,这里没有 FontFaceObject,而是直接把错误对象 resolve 给等待者。正常字体则先包装,再调用 bind(font)。
顺序非常重要:
bind()尝试附加并等待相应加载流程。- 若
bind()reject,.catch()向 Worker 发送FontFallback,Worker 将自身字体也设为disableFontFace = true,并尝试重发已经解析过的全部FontPath。 - 无论成功或失败,
.finally()都会在未开启fontExtraProperties时执行font.clearData()。 - 最后才
commonObjs.resolve(id, font),让依赖该字体的 Canvas 操作继续。
因此 resolve 的语义不是「浏览器字体一定可用」,而是「装载流程已经收尾,渲染可以按字体对象上的最终状态继续」。若原生字体失败,主线程对象已在 bind 的 catch 中切换到 disableFontFace;若系统字体加载失败,则是另一条不会 reject 的路径,后文单独说明。
PDFObjects.get(id) 在对象尚未 resolve 时会抛错,带 callback 的 get(id, callback) 则等待 promise。commonObjs.resolve 既是数据发布点,也是渲染依赖的同步点,所以 clearData 与 resolve 的先后关系不是无关紧要的内存优化细节。
FontLoader:管理 DOM 中的字体生命周期
构造函数:文档、注册表与旧式队列
class FontLoader {
  #systemFonts = new Set();
  #styleSheet = null;

  constructor({ ownerDocument = globalThis.document, styleElement = null }) {
    this._document = ownerDocument;
    this.nativeFontFaces = new Set();
    this.styleElement =
      typeof PDFJSDev === 'undefined' || PDFJSDev.test('TESTING') ? styleElement : null;

    if (typeof PDFJSDev === 'undefined' || !PDFJSDev.test('MOZCENTRAL')) {
      this.loadingRequests = [];
      this.loadTestFontId = 0;
    }
  }
}
ownerDocument 默认是当前文档,也可以指向打印 iframe 的文档;后面所有字体与样式操作都应以它为准。styleElement 是测试注入口,非测试构建会强制置空。nativeFontFaces 跟踪通过本加载器注册的原生对象,#systemFonts 只跟踪已经成功加载的系统字体名。
loadingRequests 与 loadTestFontId 只服务于非 MOZCENTRAL 的旧式异步路径:前者保存完成请求队列,后者参与生成唯一测试字体 id。现代 Font Loading API 路径不使用它们。
addNativeFontFace 与 removeNativeFontFace
addNativeFontFace(nativeFontFace) {
  this.nativeFontFaces.add(nativeFontFace);
  this._document.fonts.add(nativeFontFace);
}

removeNativeFontFace(nativeFontFace) {
  this.nativeFontFaces.delete(nativeFontFace);
  this._document.fonts.delete(nativeFontFace);
}
两个集合必须同步:PDF.js 自己的 Set 用于后续统一清理,浏览器的 FontFaceSet 决定 Canvas 能否解析这个 family。只调用 new FontFace(...) 并不会完成注册;必须进入对应 document 的 document.fonts。
系统字体加载失败时调用 removeNativeFontFace,把刚加入的失败对象从两边删除。普通嵌入字体的原生加载失败路径没有在这里立即 remove,而是由 disableFontFace 切换内置轮廓渲染,最终仍可通过 clear() 统一移除注册对象。
insertRule 与 #getStyleSheet:优先 constructable stylesheet
旧式路径需要插入 @font-face。规则容器不是简单写死一个 <style>,而是按能力与测试配置选择:
insertRule(rule) {
  const styleSheet = this.#getStyleSheet();
  styleSheet.insertRule(rule, styleSheet.cssRules.length);
}

#getStyleSheet() {
  if (this.#styleSheet) {
    return this.#styleSheet;
  }

  const StyleSheet =
    this._document.defaultView?.CSSStyleSheet || globalThis.CSSStyleSheet;
  if (!this.styleElement && StyleSheet) {
    const { adoptedStyleSheets } = this._document;
    if (adoptedStyleSheets) {
      const styleSheet = new StyleSheet();
      adoptedStyleSheets.push(styleSheet);
      return (this.#styleSheet = styleSheet);
    }
  }

  if (!this.styleElement) {
    this.styleElement = this._document.createElement("style");
    this._document.documentElement
      .getElementsByTagName("head")[0]
      .append(this.styleElement);
  }
  return (this.#styleSheet = this.styleElement.sheet);
}
首选 constructable stylesheet,因为它不受 CSP inline-style 检查阻塞。CSSStyleSheet 构造函数优先从 this._document.defaultView 取,这是跨 window 场景的关键:打印 iframe 的 document 只能 adopt 在同一个 window 中创建的 stylesheet,不能随意复用顶层 window 的构造器。
没有测试 styleElement、构造器存在且 adoptedStyleSheets 可用时,新建 sheet 并 push 到文档数组,然后缓存到 #styleSheet。否则创建 <style> 并附加到目标文档的 <head>,使用它的 .sheet。两种方式最终都向 insertRule 暴露相同的 insertRule(rule, cssRules.length) 接口。
#styleSheet 缓存避免每条规则都重建容器;规则本身追加到末尾,没有在这里做去重或合并。字体去重由更上层的 attached 和 #systemFonts 负责。
clear:同时清理字体与规则容器
clear() {
  for (const nativeFontFace of this.nativeFontFaces) {
    this._document.fonts.delete(nativeFontFace);
  }
  this.nativeFontFaces.clear();
  this.#systemFonts.clear();

  if (this.#styleSheet) {
    const { adoptedStyleSheets } = this._document;
    if (adoptedStyleSheets?.includes(this.#styleSheet)) {
      this._document.adoptedStyleSheets = adoptedStyleSheets.filter(
        styleSheet => styleSheet !== this.#styleSheet
      );
    }
    this.#styleSheet = null;
  }

  if (this.styleElement) {
    this.styleElement.remove();
    this.styleElement = null;
  }
}
清理分三层。第一层从 document.fonts 删除每个原生 FontFace,再清空 PDF.js 的注册 Set;第二层清空系统字体成功记录,使后续新生命周期可以重新加载;第三层处理样式:若缓存 sheet 在 adoptedStyleSheets 中,就用过滤后的新数组解除 adopt,随后断开缓存;若使用过 <style>,再将其从 DOM 删除。
构造样式表与 <style> 两条回退路径都在这里闭合,测试注入的 style 也会被移除并置空。clear() 没有重置 loadTestFontId,也没有在这里显式排空 loadingRequests;它清理的是 DOM 注册、成功去重状态和样式资源,不应被扩写成不存在的异步队列取消机制。
系统字体:loadSystemFont 的去重与失败处理
当 Worker 没有可用嵌入字体、但选择了系统字体替代项时,font.systemFontInfo 非空。此时不是把 PDF 的 data 注册为字体,而是根据替代信息加载系统资源:
async loadSystemFont({ systemFontInfo: info, disableFontFace, _inspectFont }) {
  if (!info || this.#systemFonts.has(info.loadedName)) {
    return;
  }
  assert(
    !disableFontFace,
    "loadSystemFont shouldn't be called when `disableFontFace` is set."
  );

  if (this.isFontLoadingAPISupported) {
    const { loadedName, src, style } = info;
    const fontFace = new FontFace(loadedName, src, style);
    this.addNativeFontFace(fontFace);
    try {
      await fontFace.load();
      this.#systemFonts.add(loadedName);
      _inspectFont?.(info);
    } catch {
      warn(
        `Cannot load system font: ${info.baseFontName}, installing it could help to improve PDF rendering.`
      );
      this.removeNativeFontFace(fontFace);
    }
    return;
  }

  unreachable("Not implemented: loadSystemFont without the Font Loading API.");
}
去重键是 info.loadedName,而且只有 await fontFace.load() 成功后才加入 #systemFonts。所以它表达的是「这个系统字体已经成功加载」,不是「曾经尝试过」,也不是一张 in-flight promise 表。相同 FontFaceObject 的重复调用还会先被 bind 的 attached 拦住。
这里显式调用 fontFace.load(),与后面嵌入字体等待 nativeFontFace.loaded 不同。成功时调用 _inspectFont?.(info),检查器收到的是系统字体信息;失败时只警告「安装该字体可能改善渲染」并移除刚注册的 FontFace。
**系统字体失败的 catch 不向外抛错。**因此 bind() 会正常完成,api.js 不会因这次失败发送 FontFallback,commonObjs 仍会 resolve 原字体对象。Canvas 后续仍可根据 systemFontInfo.css 组 CSS 字体栈;这里完成的是加载替代资源的尝试与失败回退,而不是伪造一次成功加载。
如果环境根本没有 Font Loading API,系统字体路径直接 unreachable:旧式 @font-face 探测只服务普通字体规则,并没有另一套系统字体加载实现。
bind:所有字体进入 DOM 前的统一分支
提前返回、attached 与系统字体优先级
async bind(font) {
  if (font.attached || (font.missingFile && !font.systemFontInfo)) {
    return;
  }
  font.attached = true;

  if (font.systemFontInfo) {
    await this.loadSystemFont(font);
    return;
  }

  if (this.isFontLoadingAPISupported) {
    const nativeFontFace = font.createNativeFontFace();
    if (nativeFontFace) {
      this.addNativeFontFace(nativeFontFace);
      try {
        await nativeFontFace.loaded;
      } catch (ex) {
        warn(`Failed to load font '${nativeFontFace.family}': '${ex}'.`);
        font.disableFontFace = true;
        throw ex;
      }
    }
    return;
  }

  const rule = font.createFontFaceRule();
  if (rule) {
    this.insertRule(rule);

    if (this.isSyncFontLoadingSupported) {
      return;
    }
    if (typeof PDFJSDev !== "undefined" && PDFJSDev.test("MOZCENTRAL")) {
      throw new Error("Not implemented: async font loading");
    }
    await new Promise(resolve => {
      const request = this._queueLoadingCallback(resolve);
      this._prepareFontLoadEvent(font, request);
    });
  }
}
第一个判断包含两种完全不同的跳过:已经 attached 的对象不重复附加;missingFile && !systemFontInfo 表示既没有文件,也没有系统替代信息,无需向 DOM 注册。第二种情况直接返回,发生在设置 attached 之前。
其余路径立刻执行 font.attached = true,然后才 await。它只是一个「已经尝试过附加」的防重入标记,不是 loaded、ready 或 usable 状态。即使后面的 nativeFontFace.loaded reject,这个标记也不会被源码复位;本文件没有据此实现错误重试。
systemFontInfo 分支先于普通 data 分支,因为缺失文件仍可能有系统替代信息。若不存在系统替代,才按浏览器能力进入现代或旧式嵌入字体路径。
现代路径:等待 loaded,失败时禁用 FontFace
createNativeFontFace() 可能返回 null,例如没有 data 或已经 disableFontFace。此时 bind 直接返回,不注册空规则。创建成功则先 addNativeFontFace,再等待 nativeFontFace.loaded,而不是额外调用一次 load()。
等待失败时做三件事:打印 family 与异常、执行 font.disableFontFace = true、重新抛出原异常。重新抛出让 api.js 的 .catch() 能通知 Worker 进入 FontFallback;设置标志则让当前主线程对象之后的 paintChar 选择内置 Path2D,不再依赖失败的浏览器字体。
这里依然不能从 attached === true 推出加载成功。真正决定后续绘制方式的是 disableFontFace、missingFile、系统字体信息以及已发布的字形路径共同形成的状态。
旧式路径:规则插入不等于异步加载结束
没有 Font Loading API 时,createFontFaceRule() 生成规则并插入样式表。若 isSyncFontLoadingSupported 为真,可以立即返回;否则 MOZCENTRAL 构建明确抛出「未实现」,其余环境创建 promise,把 resolve 放进加载请求队列,再启动测试字体探测。
rule 为 null 时同样不等待探测。也就是说,_prepareFontLoadEvent 不是每个字体必经步骤,它只在「有规则、无 Font Loading API、又不能同步加载」这一窄路径运行。
两个能力 getter:能力判断只计算一次
get isFontLoadingAPISupported() {
  const hasFonts = !!this._document?.fonts;
  if (typeof PDFJSDev === "undefined" || PDFJSDev.test("TESTING")) {
    return shadow(this, "isFontLoadingAPISupported", hasFonts && !this.styleElement);
  }
  return shadow(this, "isFontLoadingAPISupported", hasFonts);
}

get isSyncFontLoadingSupported() {
  if (typeof PDFJSDev !== "undefined" && PDFJSDev.test("MOZCENTRAL")) {
    return shadow(this, "isSyncFontLoadingSupported", true);
  }
  return shadow(
    this,
    "isSyncFontLoadingSupported",
    (typeof PDFJSDev === "undefined" || !PDFJSDev.test("CHROME")) &&
      (isNodeJS || FeatureTest.platform.isFirefox)
  );
}
document.fonts 是现代路径的基础。测试模式额外要求 !this.styleElement,使注入 style 的测试可以强制走旧式回退。shadow 把首次计算结果固化到实例上,后续不再重复能力探测。
同步路径在 MOZCENTRAL 中直接视为支持;其他非 CHROME 构建中,Node.js 可以假装同步支持,Firefox 也走这一分支。源码注释对应 Firefox 14 起的行为。这里的「同步」只描述此抽象采用的加载模型,不应推广为所有浏览器或所有字体来源的通用保证。
旧式异步加载:队列、测试字体与像素轮询
_queueLoadingCallback:完成可以乱序,回调必须按入队顺序
_queueLoadingCallback(callback) {
  function completeRequest() {
    assert(!request.done, "completeRequest() cannot be called twice.");
    request.done = true;

    while (loadingRequests.length > 0 && loadingRequests[0].done) {
      const otherRequest = loadingRequests.shift();
      setTimeout(otherRequest.callback, 0);
    }
  }

  const { loadingRequests } = this;
  const request = { done: false, complete: completeRequest, callback };
  loadingRequests.push(request);
  return request;
}
每个 request 保存 done、complete 与原回调。探测结束时只能调用一次 complete;它先标记自己完成,再从队首开始,连续取出所有已经完成的请求,并用 setTimeout(callback, 0) 调度。
假设 A、B、C 按序入队,而 B 先完成:B 只会变成 done,不会越过 A。随后 A 完成时,循环依次取出 A、B 并调度回调;若 C 也已完成,也会继续取出 C。这样保证的是完成回调按入队顺序调度,不是证明字体字节按这个顺序下载,更不是额外的加载成功校验。
bind 传入的 callback 就是 promise 的 resolve。因此队列顺序最终决定了这些旧式 bind() promise 的完成发布顺序。
_loadTestFont:一个只含句点字形的已知 CFF 字体
get _loadTestFont() {
  // MOZCENTRAL throws "Not implemented" here.
  const testFont = atob(/* Full CFF test-font Base64 omitted in this excerpt. */);
  return shadow(this, "_loadTestFont", testFont);
}
源码内嵌的完整 Base64 是一个 CFF 字体,只有一个 . 字形,而且该字形填满整个宽度与高度。atob 得到二进制字符串,shadow 缓存解码结果,避免每次探测都重复解码同一份常量。
这个字体不是 PDF 里的业务字体。它是一个形状完全已知、像素结果稳定的「探针」:如果能用 Canvas 测到它画出的 alpha,就推测排在它前面的目标字体也已加载。
_prepareFontLoadEvent:先构造探针,再观察一个像素
方法开头定义了 int32、string32、spliceString 三个二进制字符串工具,随后创建 1×1 Canvas 与探测函数:
const canvas = this._document.createElement('canvas');
canvas.width = 1;
canvas.height = 1;
const ctx = canvas.getContext('2d');

let called = 0;
function isFontReady(name, callback) {
  if (++called > 30) {
    warn('Load test font never loaded.');
    callback();
    return;
  }
  ctx.font = '30px ' + name;
  ctx.fillText('.', 0, 20);
  const imageData = ctx.getImageData(0, 0, 1, 1);
  if (imageData.data[3] > 0) {
    callback();
    return;
  }
  setTimeout(isFontReady.bind(null, name, callback));
}
每次用 30px 测试字体画一个句点,再读取唯一像素的 alpha。alpha 大于零说明已知字形已经画出来,于是调用完成回调;否则通过 setTimeout 再查。源码注释指出,计时器 clamping 下整个窗口约为 100ms。
++called > 30 的精确含义是最多进行 30 次实际像素探测,第 31 次进入时警告并直接完成。这里没有 reject,也没有重新发起业务字体请求;所谓「30 次轮询」只是加载完成探测的兜底窗口,绝不能描述成 PDF.js 会重试失败字体 30 次。
唯一 id 与 CFF checksum:避免 Chromium 按字体数据缓存误判
const loadTestFontId = `lt${Date.now()}${this.loadTestFontId++}`;
let data = this._loadTestFont;
const COMMENT_OFFSET = 976;
data = spliceString(data, COMMENT_OFFSET, loadTestFontId.length, loadTestFontId);

const CFF_CHECKSUM_OFFSET = 16;
const XXXX_VALUE = 0x58585858;
let checksum = int32(data, CFF_CHECKSUM_OFFSET);
for (i = 0, ii = loadTestFontId.length - 3; i < ii; i += 4) {
  checksum = (checksum - XXXX_VALUE + int32(loadTestFontId, i)) | 0;
}
if (i < loadTestFontId.length) {
  checksum = (checksum - XXXX_VALUE + int32(loadTestFontId + 'XXX', i)) | 0;
}
data = spliceString(data, CFF_CHECKSUM_OFFSET, 4, string32(checksum));
id 由 lt、当前毫秒时间戳与递增计数器组成。Chromium 可能按实际字体数据的 hash 缓存,所以只改 CSS family 不够:每次测试还必须改变字体二进制内容,否则新探针会被误判为早已加载。
实现把 id 写进偏移 976 的 comment 区域,该区域按 4 字节对齐。原内容相当于一串 X,所以校验和修正会按每 4 字节减去 0x58585858,再加上 id 对应整数;末尾不足 4 字节时用 XXX 补齐参与计算。最后把新 checksum 写回偏移 16。
这一步同时满足两个约束:数据对 Chromium 来说是新的,CFF checksum 对 IE 来说仍然正确。它修改的是内嵌测试字体的副本,不会改动 PDF 导出的业务字体数据。
插入探针规则、触发字体使用、结束后移除临时 DOM
const url = `url(data:font/opentype;base64,${btoa(data)});`;
const rule = `@font-face {font-family:"${loadTestFontId}";src:${url}}`;
this.insertRule(rule);

const div = this._document.createElement('div');
div.style.visibility = 'hidden';
div.style.width = div.style.height = '10px';
div.style.position = 'absolute';
div.style.top = div.style.left = '0px';

for (const name of [font.loadedName, loadTestFontId]) {
  const span = this._document.createElement('span');
  span.textContent = 'Hi';
  span.style.fontFamily = name;
  div.append(span);
}
this._document.body.append(div);

isFontReady(loadTestFontId, () => {
  div.remove();
  request.complete();
});
测试字体被编码成 data URL 并插入 @font-face。隐藏、绝对定位的 div 中有两个 span:一个使用目标 font.loadedName,另一个使用测试 id。它们让两个 family 都实际参与页面布局与字体请求,而探针 Canvas 只观察测试字体。
探测结束或超过轮询上限后,先移除 div,再 request.complete()。临时 span 与 div 因而不会残留;测试规则则留在加载器的样式容器中,由后续 clear() 随整个 sheet 一起清理。
这套 hack 的基本假设是字体按顺序加载:把已知测试字体排在目标字体之后,测试字体可用时便推测目标字体已准备好。它是旧浏览器缺少字体完成事件时的兼容方案,不是现代路径仍需执行的通用流程。
FontFaceObject:把字体数据变成渲染接口
构造函数:保存二进制视图,保留可选扩展
class FontFaceObject {
  compiledGlyphs = Object.create(null);
  #fontData;

  constructor(translatedData, inspectFont = null, charProcOperatorList, extra) {
    this.#fontData = translatedData;
    this._inspectFont = inspectFont;

    if (charProcOperatorList) {
      this.charProcOperatorList = charProcOperatorList;
    }
    if (extra) {
      Object.assign(this, extra);
    }
  }
}
每个实例都有无原型字典 compiledGlyphs,用于按字符缓存 Path2D;#fontData 私有保存 FontInfo,所有基础 getter 都从这里读。_inspectFont 是可选调试钩子。
charProcOperatorList 仅在存在时挂到实例上,供 Type3 字符过程使用;extra 通过 Object.assign 展开额外属性。测试构建还会断言 disableFontFace 与 fontExtraProperties 必须是 boolean,确保跨线程格式没有漏字段。
createNativeFontFace:现代浏览器注册对象的工厂
createNativeFontFace() {
  if (!this.data || this.disableFontFace) {
    return null;
  }
  let nativeFontFace;
  if (!this.cssFontInfo) {
    nativeFontFace = new FontFace(this.loadedName, this.data, {});
  } else {
    const css = { weight: this.cssFontInfo.fontWeight };
    if (this.cssFontInfo.italicAngle) {
      css.style = `oblique ${this.cssFontInfo.italicAngle}deg`;
    }
    nativeFontFace = new FontFace(
      serializeFontFamily(this.cssFontInfo.fontFamily),
      this.data,
      css
    );
  }

  this._inspectFont?.(this);
  return nativeFontFace;
}
没有字体数据或已经禁用 FontFace 时返回 null,让 bind 无需创建空对象。普通路径以内部 loadedName 为 family,直接传入 data 与空 descriptors。
存在 cssFontInfo 时,family 改用其 fontFamily,weight 来自 fontWeight;italicAngle 非空时转成 oblique <angle>deg。serializeFontFamily 的返回值可直接作为 FontFace family 字符串使用。
创建后触发 _inspectFont?.(this)。这里还没有把对象加入 document.fonts,注册仍是 FontLoader.addNativeFontFace 的职责;工厂方法与生命周期操作保持分离。
createFontFaceRule:旧式 CSS 规则的工厂
createFontFaceRule() {
  if (!this.data || this.disableFontFace) {
    return null;
  }
  const url = `url(data:${this.mimetype};base64,${this.data.toBase64()});`;
  let rule;
  if (!this.cssFontInfo) {
    rule = `@font-face {font-family:"${this.loadedName}";src:${url}}`;
  } else {
    let css = `font-weight: ${this.cssFontInfo.fontWeight};`;
    if (this.cssFontInfo.italicAngle) {
      css += `font-style: oblique ${this.cssFontInfo.italicAngle}deg;`;
    }
    const fontFamily = serializeFontFamily(this.cssFontInfo.fontFamily);
    rule = `@font-face {font-family:${fontFamily};${css}src:${url}}`;
  }

  this._inspectFont?.(this, url);
  return rule;
}
与现代工厂相同,缺数据或禁用时返回 null。旧路径需要把二进制转成 Base64 data URL,并使用 Worker 导出的 mimetype;有 CSS 信息时同样附加 weight 与 oblique style。
调试钩子在这里额外收到 url,因为规则路径已经物化出可供检查的字体 URL。方法只返回字符串,何时插入哪个 document 的 stylesheet 仍由 FontLoader 决定。
cssFontInfo.fontFamily:为什么必须序列化
function serializeFontFamily(fontFamily) {
  if (isCSSString(fontFamily)) {
    return fontFamily;
  }
  const escaped = fontFamily.replaceAll(/["\\\p{Cc}]/gu, char =>
    char === `"` || char === '\\' ? `\\${char}` : `\\${char.codePointAt(0).toString(16)} `,
  );
  return `"${escaped}"`;
}
fontFamily 可能源自不可信 PDF,不能直接拼接进 @font-face,否则引号、反斜杠或控制字符可能破坏规则边界,形成任意 CSS 注入。serializeFontFamily 对已经是合法 CSS string 的输入原样返回;其他值统一输出带引号的 <string>,转义双引号与反斜杠,并把控制字符改成十六进制 CSS 转义。
统一使用 <string> 还避免把 serif、inherit 等值误当作 generic family 或 CSS-wide keyword。普通 loadedName 是 PDF.js 内部生成的装载名,所以无 cssFontInfo 的规则分支可以按现有格式直接引用;来自文档的 family 则必须经过这道边界。
getPathGenerator:按需生成并缓存 Path2D
getPathGenerator(objs, character) {
  if (this.compiledGlyphs[character] !== undefined) {
    return this.compiledGlyphs[character];
  }

  const objId = this.loadedName + "_path_" + character;
  let cmds;
  try {
    cmds = objs.get(objId);
  } catch (ex) {
    warn(`getPathGenerator - ignoring character: "${ex}".`);
  }
  const path = makePathFromDrawOPS(cmds?.path);

  if (!this.fontExtraProperties) {
    objs.delete(objId);
  }
  return (this.compiledGlyphs[character] = path);
}
对象 id 与 Worker buildFontPaths 完全对应:${loadedName}_path_${fontChar}。主线程收到 "FontPath" 时把它 resolve 为 FontPathInfo,其 path getter 按平台能力给出 Float16Array 或 Float32Array 绘制操作序列。
makePathFromDrawOPS 创建 Path2D,依次翻译 moveTo、lineTo、curveTo、quadraticCurveTo 与 closePath;输入为空时返回空路径。getPathGenerator 因而不是字形解析器,它只是 Worker 已编译轮廓与 Canvas 原生路径之间的轻量转换器。
缓存判断使用 !== undefined,所以空 Path2D 也会命中。若 objs.get 因对象未发布等原因抛错,这里警告并继续生成空路径,没有异步等待或重试;正常渲染依赖 commonObjs 的依赖机制保证路径可用。
首次编译后,若未开启 fontExtraProperties,就从对象池删除原始 FontPathInfo,只保留编译后的 Path2D。开启额外属性时保留原始数据,便于调试,代价是更多内存。这与字体主体的 clearData() 采用同一策略:常规渲染留最少数据,调试模式保留更多原始信息。
全部代理 getter、状态 setter 与 clearData
除路径方法外,FontFaceObject 有意保持为一层很薄的代理。下表覆盖当前文件定义的全部基础 getter:
| 分类 | getter | 消费者或含义 |
|---|---|---|
| 字形与样式状态 | black、bold、italic、vertical | Canvas 字体样式与竖排布局 |
| 装载与回退状态 | disableFontFace、missingFile、isInvalidPDFjsFont | 决定浏览器字体或内置回退路径 |
| 类型与配置 | isType3Font、fontExtraProperties、remeasure | Type3 分支、调试保留策略、重新测量 |
| 水平度量 | ascent、descent、defaultWidth | 文本布局与默认字宽 |
| 几何信息 | bbox、fontMatrix、defaultVMetrics | 包围盒、文本矩阵、默认竖排度量 |
| 身份与字体程序 | fallbackName、loadedName、mimetype、name、data | CSS family、对象 id、data URL、原始字体名与字节 |
| 可选装载信息 | cssFontInfo、systemFontInfo | CSS descriptors 与系统字体替代 |
这些 getter 都直接返回 this.#fontData.<property>,不在主线程重新计算度量,也不复制 Worker 已完成的字体分析。唯一带写入语义的状态是 disableFontFace:
get disableFontFace() {
  return this.#fontData.disableFontFace;
}

set disableFontFace(value) {
  shadow(this, "disableFontFace", !!value);
}

clearData() {
  this.#fontData.clearData();
}
setter 用 shadow 在 FontFaceObject 实例上写入布尔化的自有属性,覆盖原型上的 getter/setter。这样原生字体失败后,当前对象立即读到 true,无需修改 FontInfo 的二进制布局;后续读取也直接使用这个已确定状态。
clearData() 只是委托给 FontInfo.clearData()。它释放的是字体程序字节,不会清空 compiledGlyphs,也不会移除已注册的 FontFace;后者属于 FontLoader.clear(),两类资源不能混为一谈。
CanvasGraphics 如何消费 FontFaceObject
commonObjs.resolve 之后,CanvasGraphics.setFont 才能按 fontRefName 同步取得对象。它把对象保存到 current.font,读取矩阵与样式,并设置浏览器的 ctx.font:
const fontObj = this.commonObjs.get(fontRefName);
current.fontMatrix = fontObj.fontMatrix || FONT_IDENTITY_MATRIX;
this.current.font = fontObj;
this.current.fontSize = size;

if (fontObj.isType3Font) {
  return;
}

const name = fontObj.loadedName || 'sans-serif';
const typeface = fontObj.systemFontInfo?.css || `"${name}", ${fontObj.fallbackName}`;
// `black` / `bold` choose the weight, `italic` chooses the style.
this.ctx.font = `${italic} ${bold} ${browserFontSize}px ${typeface}`;
Type3 不需要 ctx.font,其字形由字符过程绘制。其他字体优先使用 systemFontInfo.css;否则使用 loadedName 加 fallbackName。black、bold、italic 与字体大小共同组成 CSS font shorthand,尺寸还会被钳制到浏览器可处理的范围,再通过变换补偿。
paintChar 则在需要内置轮廓时调用路径接口:
if ((font.disableFontFace || isAddToPathSet || patternFill || patternStroke) && !font.missingFile) {
  path = font.getPathGenerator(this.commonObjs, character);
}

if (path && (font.disableFontFace || patternFill || patternStroke)) {
  // Translate/scale to the glyph position, then ctx.fill(path) / ctx.stroke(path).
}
禁用 FontFace、把文本加入裁剪路径、或使用特定 pattern 填充/描边时,仅靠 fillText 不够,需要独立轮廓。missingFile 为真时则不走这条嵌入字体路径。原生字体加载失败后的 disableFontFace = true 正是在这里生效,Worker 重发的 FontPath 也正是在这里被消费。
因此 FontFaceObject 同时提供两种渲染表示:浏览器字体的 family、样式与度量,以及 Canvas 可直接 fill/stroke 的 Path2D。FontLoader 负责让第一种表示尽力可用,第二种表示则是内置渲染器与失败回退的基础。
具体加载时序
正常嵌入字体的现代路径
// 1. Worker exports FontInfo bytes and sends "commonobj".
// 2. Main thread constructs FontInfo + FontFaceObject.
// 3. bind: attached = true.
// 4. createNativeFontFace → document.fonts.add.
// 5. Await nativeFontFace.loaded.
// 6. On success: finish bind.
//    On failure: disableFontFace = true, throw, await FontFallback handling.
// 7. finally: clearData unless fontExtraProperties.
// 8. commonObjs.resolve(id, font).
// 9. CanvasGraphics consumes ctx.font and/or Path2D.这个时序里有两个独立「完成」:nativeFontFace.loaded 表示浏览器原生加载结果,commonObjs.resolve 表示 PDF.js 已把字体对象发布给渲染器。失败时前者 reject,后者仍会在回退处理与数据清理之后发生。
其他分支的完成条件
| 分支 | bind 等待什么 | 失败如何表现 | resolve 前状态 |
|---|---|---|---|
已 attached | 不等待,立即返回 | 不重新判断原加载结果 | 保留第一次尝试后的状态 |
missingFile 且无系统替代 | 不等待,立即返回 | 没有可注册字体 | 由 Canvas 使用缺失字体逻辑 |
| 系统字体 | fontFace.load() | 警告、移除 FontFace,但不 rethrow | 正常结束,不触发 FontFallback |
| 原生嵌入字体成功 | nativeFontFace.loaded | 不适用 | disableFontFace 保持原值 |
| 原生嵌入字体失败 | loaded reject,随后 API catch 通知 Worker | 设置 disableFontFace 并走 FontFallback | 回退收尾后仍发布字体对象 |
| 旧式同步 | 插入规则后立即返回 | 无异步探测结果 | 视为同步加载路径完成 |
| 旧式异步 | 测试字体像素出现,或探测超过上限 | 超限只警告并完成 | 队列按入队顺序调度 resolve |
最容易误读的是第一行与最后一行:attached 只防重复附加,旧式探针超时也不等于成功。源码没有在这些位置重置 attached、循环调用 bind 或实现通用错误重试。
clearData、cleanup 与 destroy 的时间边界
字体主体字节通常在每次 bind 链收尾时就释放,不必等文档 cleanup。只有 fontExtraProperties 开启时才保留。字形原始路径则在第一次 getPathGenerator 后按同一开关决定是否删除。
PDFDocumentProxy.cleanup(keepLoadedFonts = false) 转发到 startCleanup。后者先等待 Worker 的 "Cleanup",再逐页调用 page.cleanup();任何页面仍在渲染都会抛错。随后总是 commonObjs.clear(),但只有 !keepLoadedFonts 时才 fontLoader.clear():
this.commonObjs.clear();
if (!keepLoadedFonts) {
  this.fontLoader.clear();
}
keepLoadedFonts 允许 DOM 字体继续驻留,避免后续重用成本,但源码文档明确警告会增加持久内存。纯 XFA 在 PDFDocumentProxy.cleanup 入口会强制保留字体。
WorkerTransport.destroy() 则先标记 destroyed,等待各页 _destroy() 和 Worker "Terminate",在 Promise.all(waitOn) 成功后无条件执行 commonObjs.clear() 与 fontLoader.clear(),再清理消息处理器等资源。PDFDocumentLoadingTask.destroy() 负责等待并调用 transport 的销毁流程。
所以三个清理动作层级不同:font.clearData() 释放单个字体的大字节块;fontLoader.clear() 释放 DOM 注册与样式;commonObjs.clear() 释放主线程对象池。文档销毁会把后两者一起收尾,而普通 cleanup 可以选择保留已加载字体。
设计要点
-
把「附加」「加载」「可渲染」分开。
attached只表示已走过附加入口;原生 promise、系统字体 catch、旧式探测和disableFontFace才共同决定后续渲染方式。单一 boolean 无法也不被迫表达整个状态机。 -
发布对象前完成回退收尾。
api.js把clearData()和commonObjs.resolve()放在finally,让 Canvas 看到的始终是已经结束装载流程的对象,而不是一个仍在变化的中间状态。 -
注册与创建分离。
FontFaceObject只创建FontFace或规则,FontLoader才操作目标 document。打印 iframe、测试 style、CSP 回退和统一清理由一个拥有明确文档边界的类处理。 -
**CSP 与跨 window 是样式设计的一部分。**constructable stylesheet 不仅是为了「新 API 更好看」,而是规避 inline-style 限制;从
ownerDocument.defaultView取构造器则保证 sheet 能被正确 adopt。 -
系统字体去重记录成功,不伪装尝试。
#systemFonts在load()成功后写入,失败会移除注册对象并正常返回。它既没有把失败说成成功,也没有被扩展成源码中不存在的 in-flight 缓存或重试框架。 -
**旧式兼容代码把不确定性局部化。**测试字体、唯一 id、checksum、像素 alpha、30 次探测和顺序队列都封装在非现代路径中。现代 Canvas 与
FontFaceObject不需要知道这些 hack 的存在。 -
不可信字符串必须在 CSS 边界序列化。
loadedName是内部 id,cssFontInfo.fontFamily却可能来自 PDF。serializeFontFamily用 CSS string 与转义消除规则注入,而不是依赖字体名「通常很正常」。 -
缓存编译结果,尽快删除原始大对象。
Path2D按字符缓存,原始FontPathInfo用后可删;字体字节在 bind 完成后可裁剪。fontExtraProperties明确把调试可见性与内存占用做成一个开关。 -
**回退是跨线程协作,不是主线程单方面换 family。**原生字体失败后,主线程设置
disableFontFace并发送FontFallback;Worker 同步自身状态并重发已解析字形路径,Canvas 才能可靠切换到内置轮廓。 -
清理按资源所有权划分。
FontFaceObject不管 DOM,FontLoader不重新计算字体度量,commonObjs不负责创建 CSS。各自释放自己拥有的资源,才使 cleanup 与 destroy 的组合保持可预测。
总结
font_loader.js 位于「Worker 已理解字体」与「浏览器可以绘制字体」之间。FontInfo 保留紧凑导出数据,FontFaceObject 提供创建规则、读取度量、生成路径的接口,FontLoader 则把现代 API、系统字体、旧浏览器 hack 与资源生命周期收拢在同一个文档边界内。
| 问题 | 当前源码的答案 |
|---|---|
| 字体如何进入浏览器? | 现代路径注册 FontFace,旧路径插入 @font-face |
| 系统字体如何避免重复? | #systemFonts 记录成功加载的 loadedName |
| 如何知道旧式异步加载结束? | 已知 CFF 测试字体、1 像素 alpha、最多 30 次实际探测 |
| 多个旧式请求如何收尾? | 完成可乱序,队首连续出队保证回调按入队顺序调度 |
| 原生字体失败怎么办? | disableFontFace = true、抛出异常、FontFallback、使用字形路径 |
| 字体对象何时给 Canvas? | bind/回退收尾、clearData 后才 commonObjs.resolve |
| 字形路径如何避免重复工作? | compiledGlyphs 缓存 Path2D,常规模式删除原始路径对象 |
| 文档结束如何释放? | cleanup 可选择保留 DOM 字体,destroy 无条件清理加载器与对象池 |
读完这个文件,最应该记住的不是某条浏览器 hack,而是它的状态边界:**附加不等于成功,resolve 不等于原生字体可用,失败也不等于渲染流程必须崩溃。**PDF.js 用明确的发布时序和内置轮廓回退,把这些差异挡在 CanvasGraphics 的稳定接口之后。
StreamPDF 的设计原则: 能前置处理的绝对不放到解析的时候才做, 由服务端一次解决所有性能问题. 浏览器只获取&渲染必须数据.
相关文章
- PDF.js 从 demo 深入浅出 10: CanvasGraphics 与 operatorList 绘制2026年10月27日
- PDF.js 从 demo 深入浅出 9: 网络流与 Range 请求2026年10月27日
- PDF.js 从 demo 深入浅出 8: PDFWorker.create 与真假 Worker 握手2026年10月27日
- PDF.js 从 demo 深入浅出 7: WorkerTransport 初始化2026年10月27日
- PDF.js 从 demo 深入浅出 6: MessageHandler 跨线程通讯2026年10月27日
- PDF.js 从 demo 深入浅出 5: render 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 4: getViewport 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 3: getPage 方法全貌2026年10月27日
- PDF.js 从 demo 深入浅出 2: getDocument 方法全貌2026年10月27日
- PDF.js 源码解读: TextLayer2026年10月27日
- PDF.js 源码解读: obj_bin_transform_display2026年10月27日
- PDF.js 源码解读: PDFObjects2026年10月27日
- PDF.js 源码解读: 网络流2026年10月27日
- PDF.js 源码解读: internal_evt.js2026年10月27日
- PDF.js 源码解读: math_clamp.js2026年10月27日
- PDF.js 源码解读: css_utils.js2026年10月27日
- PDF.js 源码解读: scripting_utils2026年10月27日
- PDF.js 源码解读: MurmurHash3_642026年10月27日
- PDF.js 源码解读: obj_bin_transform_utils2026年10月27日
- PDF.js 源码解读: image_utils.js2026年10月27日
- PDF.js 源码解读: BasePDFStream2026年10月27日
- PDF.js 源码解读: 共享工具层2026年10月27日
- PDF.js 源码解读: MessageHandler2026年10月27日
- PDF.js 源码解读: api2026年10月27日
- PDF.js 源码解读: fonts2026年10月27日
- PDF.js 源码解读: glyphlist2026年10月27日
- PDF.js 源码解读: binary_cmap2026年10月27日
- PDF.js 源码解读: cmap2026年10月27日
- PDF.js 源码解读: encodings2026年10月27日
- PDF.js 源码解读: metrics2026年10月27日
- PDF.js 源码解读: standard_fonts2026年10月27日
- PDF.js 源码解读: fonts_utils2026年10月27日
- PDF.js 源码解读: default_appearance2026年10月27日
- PDF.js 源码解读: metadata_parser2026年10月27日
- PDF.js 源码解读: name_number_tree2026年10月27日
- PDF.js 源码解读: struct_tree2026年10月27日
- PDF.js 源码解读: catalog2026年10月27日
- PDF.js 源码解读: pdf_manager2026年10月27日
- PDF.js 源码解读: object_loader2026年10月27日
- PDF.js 源码解读: obj_bin_transform_core2026年10月27日
- PDF.js 源码解读: crypto2026年10月27日
- PDF.js 源码解读: core_utils2026年10月27日
- PDF.js 源码解读: primitives2026年10月27日
- PDF.js 源码解读: worker_stream2026年10月27日
- PDF.js 源码解读: ccitt_stream2026年10月27日
- PDF.js 源码解读: jpx_stream2026年10月27日
- PDF.js 源码解读: jbig2_stream2026年10月27日
- PDF.js 源码解读: jpeg_stream2026年10月27日
- PDF.js 源码解读: decrypt_stream2026年10月27日
- PDF.js 源码解读: brotli_stream2026年10月27日
- PDF.js 源码解读: run_length_stream2026年10月27日
- PDF.js 源码解读: ascii_hex_stream2026年10月27日
- PDF.js 源码解读: ascii_85_stream2026年10月27日
- PDF.js 源码解读: lzw_stream2026年10月27日
- PDF.js 源码解读: predictor_stream2026年10月27日
- PDF.js 源码解读: flate_stream2026年10月27日
- PDF.js 源码解读: decode_stream2026年10月27日
- PDF.js 源码解读: chunked_stream2026年10月27日
- PDF.js 源码解读: stream2026年10月27日
- PDF.js 源码解读: base_stream2026年10月27日
- PDF.js 深入浅出 11: Parser2026年10月26日
- PDF.js 深入浅出 10: XRef2026年10月26日
- PDF.js 深入浅出 9: CanvasGraphics2026年10月26日
- PDF.js 深入浅出 8: Document 与 Page2026年10月26日
- AI 时代, 我们到底应该做什么才能活下去(StreamPDF 创立有感)2026年10月26日
- PDF.js 深入浅出 7: PartialEvaluator2026年10月25日
- PDF.js 深入浅出 6: PDFManager.initDocument2026年10月25日
- PDF.js 深入浅出 5: PDFFetchStream 和 PDFWorkerStream2026年10月25日
- PDF.js 深入浅出 4: MessageHandler2026年10月22日
- PDF.js 深入浅出 3: getViewport & render2026年10月22日
- PDF.js 从 demo 深入浅出 1: 自定义 viewer 渲染 PDF2026年10月19日
- PDF.js 深入浅出 2: getDocument & getPage2026年10月19日
- PDF.js 深入浅出 1: PDF.js 的架构设计2026年10月16日